LLMファインチューニングとは?RAGとの違いや手法、導入判断を解説
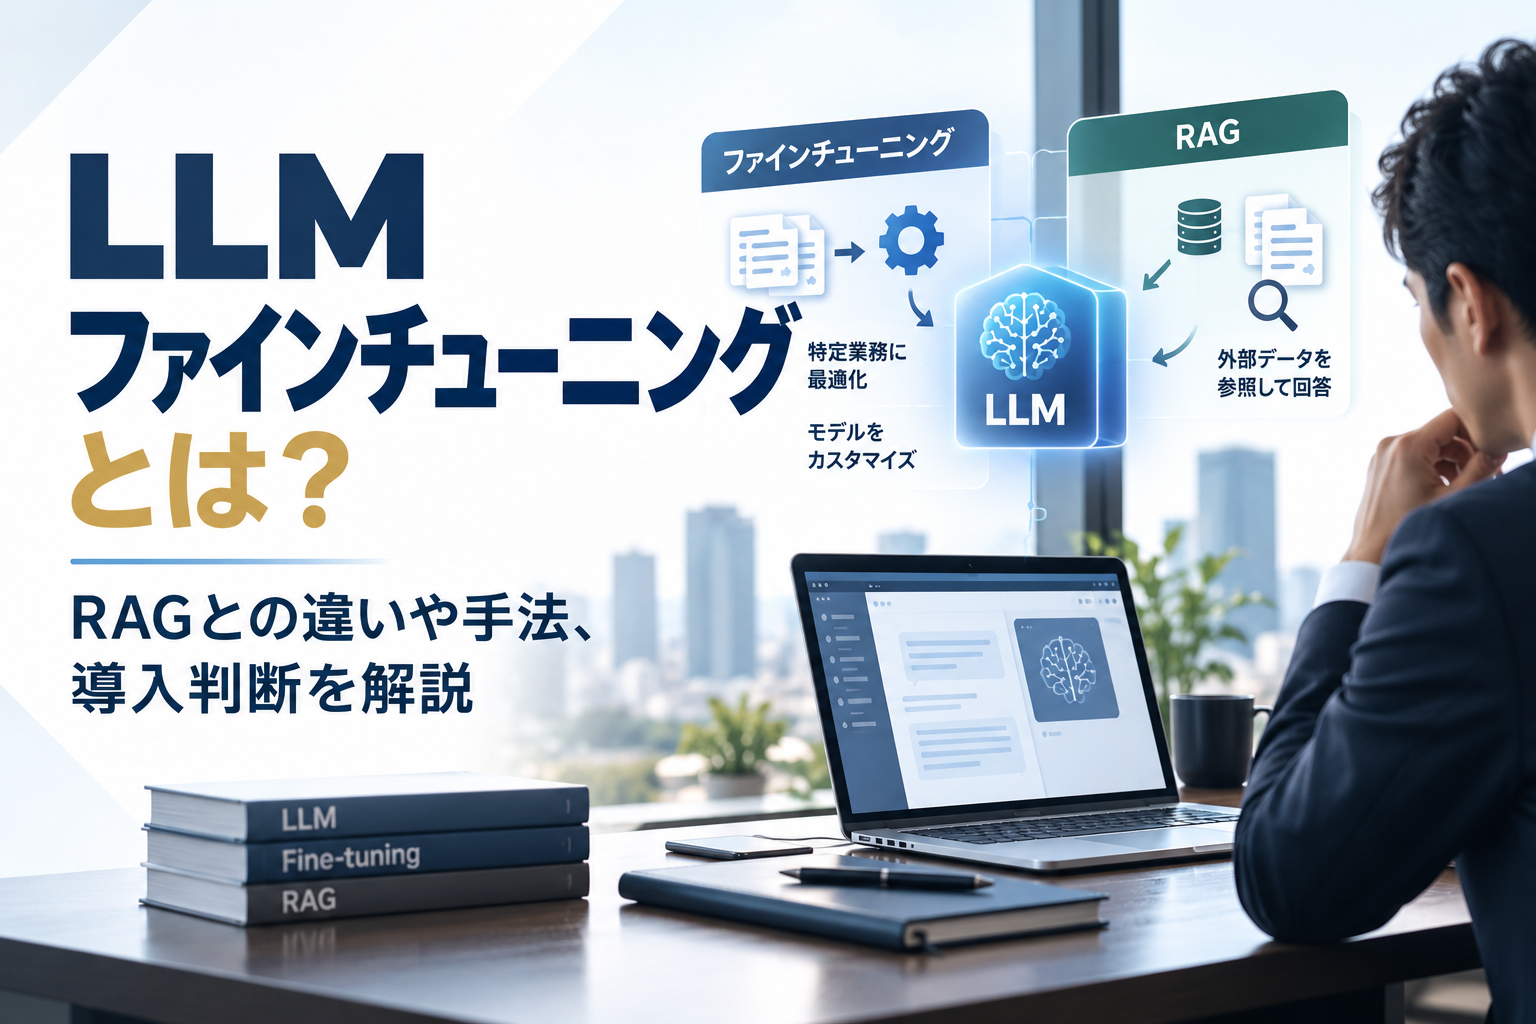
LLMファインチューニングは、既存の大規模言語モデルを自社用途に合わせて追加学習し、応答の質や振る舞いを調整するための手法です。
生成AIを業務で活用する際、「RAGと何が違うのか」「自社では本当にファインチューニングが必要なのか」と迷うこともあるでしょう。
実際には、知識を追加したいのか、出力の癖や文体を整えたいのかによって、選ぶべき方法は変わります。
さらに、手法の違いだけでなく、学習データの作り方、GPUや実行環境、導入後の運用負荷まで見ないと、期待した効果が出にくいこともあります。
この記事では、LLMファインチューニングの基本から、RAGとの違い、代表的な手法、学習データ設計、実行環境の考え方、導入時の注意点までを整理します。
読み終えるころには、自社がファインチューニングを検討すべきか、それとも別の選択肢が適しているかを判断しやすくなるはずです。
LLMファインチューニングとは
LLMファインチューニングとは、事前学習済みの大規模言語モデルに対して、追加の学習データを使い、特定の業務や目的に合わせて性能を調整することです。
ゼロからモデルを作るわけではなく、既存モデルの土台を活かしながら、自社に必要な応答スタイルや判断傾向を身につけさせるイメージです。
たとえば、社内問い合わせへの回答文を一定の文体で返したい、専門用語を正確に扱いたい、出力フォーマットを厳密に守らせたい、といった要件では有効に働きやすくなります。
一方で、最新情報をそのまま覚えさせる用途には向かない場合があります。
モデル自体に知識を持たせる方法なので、情報更新のたびに再学習が必要になりやすいためです。
そのため、ファインチューニングは万能な手段ではなく、何を改善したいのかを明確にしたうえで使う必要があります。
LLMの全体像を先に押さえたい場合は、LLM開発の基本もあわせて確認すると、ファインチューニングの位置づけを整理しやすいでしょう。
ファインチューニングで調整しやすい要素
ファインチューニングは、単に知識量を増やすよりも、モデルの振る舞いを整えることに強みがあります。
- 回答の文体やトーンの統一
- 特定業界の表現や専門用語への適応
- 出力フォーマットの安定化
- 望ましい回答例に沿った応答傾向の強化
- 不要な表現や誤った返答パターンの抑制
つまり、「何を知っているか」よりも「どう答えるか」を整えたい場面で、導入価値が高まりやすいと考えると分かりやすいはずです。
RAGとLLMファインチューニングの違い
RAGとLLMファインチューニングは、どちらも生成AIを業務に合わせて使うための代表的な方法ですが、役割は大きく異なります。
RAGは検索で必要な情報を取り出してから回答させる方式です。
一方で、ファインチューニングはモデルそのものを追加学習し、応答の仕方を変える方式です。
| 観点 | RAG | ファインチューニング |
|---|---|---|
| 主な目的 | 外部知識を参照して回答精度を上げる | 応答傾向や文体、形式を最適化する |
| 知識更新 | 文書差し替えで対応しやすい | 再学習が必要になりやすい |
| 向いている課題 | 社内文書検索、FAQ参照、最新情報の活用 | 定型応答、専門表現、出力ルールの統一 |
| 導入負荷 | 検索基盤やデータ整備が必要 | 学習データ設計と計算資源が必要 |
| よくある使い方 | 知識の補完 | 振る舞いの調整 |
判断の軸として重要なのは、課題が「情報不足」なのか「応答品質のばらつき」なのかです。
たとえば、社内規程や製品マニュアルを参照して正確に答えたいならRAGのほうが適しています。
反対に、毎回同じ形式で回答してほしい、接客品質に近い言い回しを再現したいといった要件なら、ファインチューニングが候補になります。
RAGの仕組みや構築の考え方を詳しく知りたい場合は、RAG構築の記事も参考になります。
RAGだけで十分なケース
情報の更新頻度が高い業務では、RAGを中心に設計できる場合があります。
商品情報、法改正、社内ルール、最新の案件資料などを扱う場合、知識をモデル内部に持たせるより、外部データを都度参照したほうが運用しやすいためです。
とくに、回答根拠を示したい場面では、検索元の文書を提示しやすいRAGが有利です。
ファインチューニングが必要になりやすいケース
一方で、検索で情報を持ってきても出力の品質が安定しない場合は、ファインチューニングを検討する余地があります。
たとえば、回答の言い回しが毎回変わる、禁止表現を避けたい、JSONや定型帳票の形式を守らせたいといった場面です。
RAGは知識補完、ファインチューニングは出力制御という役割分担で考えると、導入判断がしやすくなります。
RAGとファインチューニングを併用するケース
実務では、RAGとファインチューニングを二者択一で考えないほうが現実的です。
最新情報はRAGで参照しつつ、回答文体や出力形式はファインチューニングで整える構成も考えられます。
つまり、どちらが優れているかではなく、課題に対してどこをモデル側で吸収し、どこを検索側で補うかを設計することが大切です。
LLMファインチューニングの代表的な手法
LLMファインチューニングにはいくつかの手法があり、目的やコスト条件によって向き不向きがあります。
まず押さえたいのは、すべてを深く理解する必要はないものの、何を改善するための手法なのかを区別することです。
SFT(教師ありファインチューニング)
SFTは、入力と望ましい出力のペアを用意して学習させる、もっとも基本的な方法です。
「この質問にはこの回答が望ましい」という正解例を与えるため、業務向けの受け答えを覚えさせやすいのが特徴です。
FAQ応答、要約形式の統一、分類タスクなど、明確な教師データを作りやすい用途で使われます。
PEFT
PEFTは、モデル全体ではなく一部のパラメータだけを効率よく調整する考え方です。
フルファインチューニングに比べて計算資源を抑えやすく、実験を回しやすい点が利点です。
学習コストや実装負荷を抑えながら効果を見たい場合に、有力な選択肢になります。
LoRA
LoRAはPEFTの代表例で、少ない追加パラメータで学習を行う軽量手法です。
フルファインチューニングよりGPU負荷を抑えやすいため、まず検証から始めたい企業に向いています。
特定用途への適応を比較的短いサイクルで試しやすく、実務で採用されやすい理由のひとつです。
DPO
DPOは、どちらの回答がより望ましいかという選好データを使ってモデルを調整する手法です。
単純な正解を1つ決めにくい場面でも、好ましい振る舞いを学習させやすいのが特徴です。
たとえば、より自然で丁寧な言い回し、安全性に配慮した回答、ブランドトーンに合う表現を強めたい場合に検討されます。
フルファインチューニングとの違い
フルファインチューニングはモデル全体を更新するため、調整余地は大きい一方で、計算コストも高くなりやすい方法です。
対してPEFTやLoRAは、必要な変更範囲を絞ることで、負荷と柔軟性のバランスを取りやすくします。
初期段階では、いきなり大規模な学習に進むより、軽量手法で効果を検証するほうが現実的なことも多いでしょう。
LLMファインチューニングが向いているケース
ファインチューニングは、すべての生成AI活用で必要になるわけではありません。
導入価値が高いのは、検索やプロンプト工夫だけでは安定しない課題を抱えているケースです。
- 回答の文体やトーンを一貫させたい
- 専門用語や業界特有の言い回しに対応したい
- 定型フォーマットで安定して出力させたい
- 望ましい応答例を大量に持っている
- 禁止表現や回答ルールを守らせたい
- RAGだけでは出力品質のばらつきが大きい
たとえば、コールセンター支援、営業メール作成、審査コメント生成、文書分類、問い合わせ一次応答などでは、出力品質の安定が重要になります。
こうした業務では、単に情報を参照できるだけでは足りず、どう答えるかまで揃えたくなるため、ファインチューニングの意義が出やすいのです。
逆に、最新資料を横断して探しながら答える業務や、根拠文書を参照すべき業務では、RAG中心の設計のほうが適している場合があります。
既存の課題が「知識不足」なのか「応答品質の不安定さ」なのかを切り分けることが、導入判断の出発点です。
学習データ設計で押さえるべきポイント
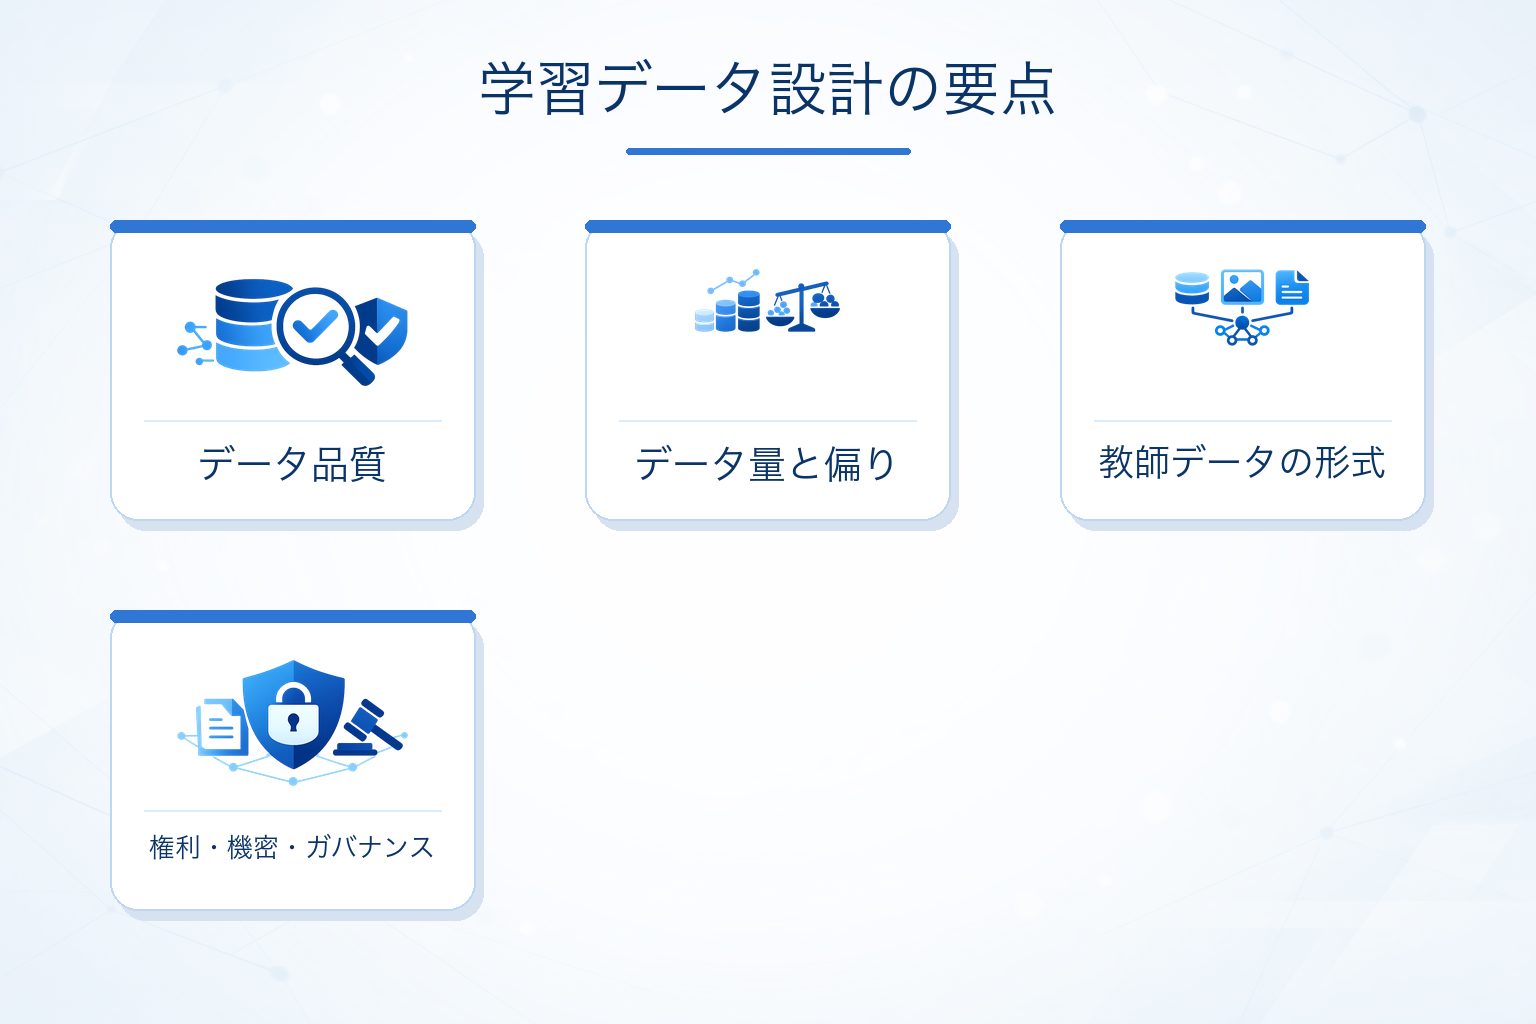
LLMファインチューニングの成否を大きく左右するのが学習データです。
手法やGPUより前に、どのようなデータを、どの形式で、どの品質で用意するかを詰める必要があります。
量よりも品質を優先する
学習データは多ければよいわけではありません。
誤った回答例や曖昧な指示が混じっていると、その癖まで学習してしまいます。
まずは高品質なデータを絞って用意し、評価しながら拡張する進め方が安全です。
入力と出力の対応を明確にする
SFTでは、とくに入力と望ましい出力の対応関係が重要です。
質問、前提条件、期待する回答形式が揃っていないと、モデルは何を学ぶべきか判断しにくくなります。
社内でよくある問い合わせ、過去の対応履歴、優良回答例などを使う場合も、学習用に整形する工程が欠かせません。
データの偏りを確認する
一部の部署やユースケースに偏ったデータだけで学習すると、他の場面で精度が落ちやすくなります。
たとえば、短文の問い合わせばかりを学習させると、長文入力への対応が弱くなる可能性があります。
本番で想定する入力の幅を踏まえ、カバレッジを意識した設計が必要です。
機密情報と権利処理に注意する
業務データを扱う以上、個人情報、営業秘密、著作権、契約上の利用制限には十分な配慮が必要です。
匿名化やマスキング、利用許諾の確認をせずに学習へ流すのは避けるべきです。
とくに機密データを扱う場合は、運用全体も含めて生成AIセキュリティの観点で確認しておきたいところです。
評価用データを分けて持つ
学習に使ったデータだけで精度を判断すると、過学習に気づきにくくなります。
そのため、学習用とは別に、評価専用のデータセットを確保することが重要です。
本番想定の質問に対して、形式遵守のしやすさ、禁止表現の抑制、回答妥当性などを確認できるようにすると、導入判断がぶれにくくなります。
学習データは「集める」だけでなく、「使える形に整え、評価できる状態にする」ことが本質です。
実行環境とGPU選定の考え方
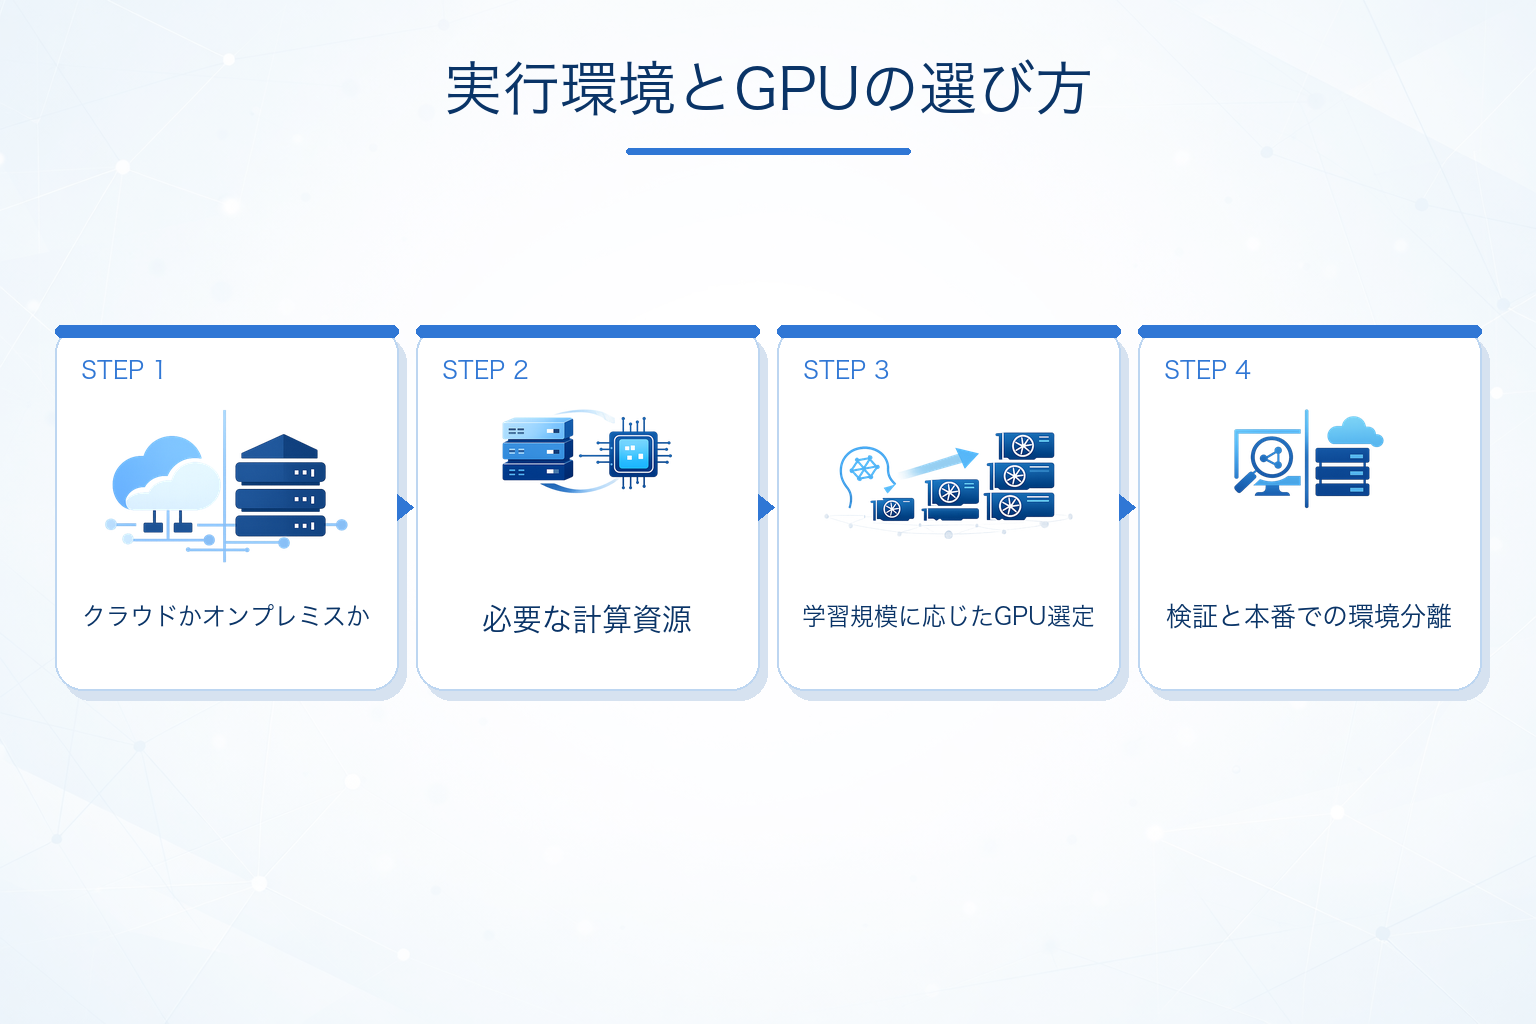
ファインチューニングでは、実行環境とGPU選定も重要な検討事項です。
ただし、最初から高性能GPUを前提にするのではなく、学習方式と運用要件に合わせて考える必要があります。
クラウドかオンプレミスか
検証段階では、必要なときだけ計算資源を利用できるクラウドが選択肢になります。
一方で、機密性の高いデータを扱う、既存の社内基盤に合わせたい、長期的に安定運用したい場合はオンプレミスや閉域環境を検討することもあります。
自社環境での運用を視野に入れるなら、ローカルLLMの考え方も把握しておくと判断しやすくなります。
GPU要件は手法で変わる
必要なGPU性能は、モデルサイズ、学習データ量、バッチサイズ、学習方式によって変わります。
フルファインチューニングは負荷が大きくなりやすく、LoRAのような軽量手法は比較的始めやすい構成です。
そのため、「どのGPUが正解か」を先に決めるのではなく、どの程度の調整が必要なのかを先に整理したほうが失敗しにくくなります。
検証環境と本番環境は分けて考える
PoCで一度うまく動いたとしても、そのまま本番運用に耐えられるとは限りません。
推論速度、同時接続、ログ管理、監視、権限制御など、本番で必要な要件は別に存在します。
学習環境だけでなく、デプロイ後の推論基盤まで含めて設計することが大切です。
GPU選定で見たい観点
GPUは単体スペックだけでなく、全体の利用条件で評価する必要があります。
- 対象モデルのサイズに対して必要なメモリがあるか
- フルファインチューニングかLoRAか
- 学習を何回やり直す想定か
- 学習後の推論基盤をどこに置くか
- セキュリティ要件やデータ持ち出し制約があるか
つまり、GPU選定はハードウェアの比較ではなく、学習方法・運用設計・セキュリティ要件を含めた全体最適として考えるべきテーマです。
LLMファインチューニング導入時の注意点
ファインチューニングは効果的な手段ですが、導入時には見落としやすい論点もあります。
ここを曖昧にしたまま進めると、コストだけかかって成果が見えにくくなるおそれがあります。
過学習とメンテナンス負荷に注意する
学習データに過度に適応すると、想定外の入力への汎化性能が落ちることがあります。
また、一度学習して終わりではなく、業務変更やルール更新に応じて見直しが必要になる点も見逃せません。
ファインチューニングは導入プロジェクトというより、継続的な改善プロセスとして捉えたほうが現実的です。
評価指標を先に決める
「なんとなく良くなった」で判断すると、PoCの結果を本番導入につなげにくくなります。
事前に、何を改善対象にするのかを明確にし、比較できる評価軸を置くことが重要です。
たとえば、定型フォーマットの遵守、禁止表現の抑制、回答の一貫性、人手レビューでの合格可否など、業務に沿った観点で確認すると判断しやすくなります。
RAGやプロンプト改善で代替できるかを確認する
ファインチューニングは有力な選択肢ですが、常に最優先とは限りません。
参照文書の整備、プロンプトの改善、ワークフロー分割、出力後のバリデーション追加で十分なケースもあります。
とくに最新情報の参照や回答根拠の提示が重要な業務では、まずRAG中心で設計したほうが運用しやすいことがあります。
まずは小さく検証する
いきなり全社展開を前提にせず、限定用途でPoCを行うほうが失敗を防ぎやすくなります。
たとえば、問い合わせ分類だけ、定型返信だけ、審査コメント補助だけ、といった単位で始める方法です。
効果指標を決めたうえで、小さく検証し、RAGやプロンプト設計との比較を行う進め方が望ましいでしょう。
よくある質問
Q.1 LLMファインチューニングとは何ですか?
LLMファインチューニングとは、事前学習済みの大規模言語モデルに追加学習を行い、特定業務に合った応答の仕方へ調整することです。知識を増やすというより、文体、出力形式、専門表現、望ましい回答傾向を最適化する目的で使われることが多い手法です。
Q.2 RAGとファインチューニングはどちらを選ぶべきですか?
最新情報や社内文書を参照して答えたいならRAGが向いています。一方で、回答の文体やフォーマット、禁止表現の制御など、出力の一貫性を高めたいならファインチューニングが候補です。実務ではどちらか一方ではなく、RAGで知識を補い、ファインチューニングで振る舞いを整える併用もよくあります。
Q.3 LoRAとは何ですか?
LoRAは、モデル全体を大きく更新せず、一部の追加パラメータだけを学習する軽量なファインチューニング手法です。フルファインチューニングより計算資源を抑えやすく、まずは効果検証から始めたいケースで採用しやすい方法として知られています。
Q.4 DPOとは何ですか?
DPOは、どの回答がより望ましいかという選好データを使ってモデルを調整する手法です。正解を1つに決めにくい場面でも、自然さ、安全性への配慮、ブランド方針への適合など、望ましい回答傾向を学習させる目的で利用できます。
Q.5 どのような学習データが必要ですか?
基本は、入力と望ましい出力が対応した高品質な教師データです。量だけでなく、誤りの少なさ、形式の統一、ユースケースの偏りの少なさが重要になります。また、個人情報や機密情報の扱い、著作権や利用許諾の確認も欠かせません。
Q.6 GPUはどの程度必要ですか?
必要なGPUは、モデルサイズ、学習データ量、学習方式、求める速度によって変わるため、一律には決められません。フルファインチューニングは高い計算資源を求めやすく、LoRAのような軽量手法なら比較的始めやすいことがあります。まずは目的に合う学習方式を決め、そのうえで実行環境を設計する進め方が現実的です。
自社に合ったLLMファインチューニングの進め方を考えよう
LLMファインチューニングを検討する際に大切なのは、自社の課題が本当にモデル調整で解決すべきものかを見極めることです。
RAG、プロンプト設計、ワークフロー改善でも十分な場合があるため、ファインチューニングありきで進めない姿勢が欠かせません。
また、同じファインチューニングでも、SFT、LoRA、DPO、フルファインチューニングでは、狙える効果も必要な計算資源も変わります。
さらに、学習データの品質、評価方法、実行環境、運用設計によって、成果の出やすさは大きく変わるでしょう。
比較検討の際は、何を改善したいのか、RAGで代替できないか、学習データを継続的に整備できるか、PoCから本番運用までの体制を見通せるかを確認したいところです。
まずは対象業務を絞り、期待する出力品質を定義し、小規模なPoCで効果を検証してみましょう。
そのうえで、RAGとの併用も含めて構成を見直すと、自社にとって無理のない導入方針を描きやすくなります。
自社だけで学習データ設計や実行環境の判断まで進めるのが難しい場合は、外部の専門家や開発パートナーへ相談する選択肢もあります。
とくに、要件整理、PoC設計、GPUや基盤選定、評価設計まで含めて検討したい場合は、LLM開発会社の支援領域を確認してみるのも有効です。
エラビサキでは、LLM開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。