RAG構築とは?仕組みや構築方法、精度向上のポイントもわかりやすく解説
RAG構築は、社内文書やFAQ、マニュアルなどの既存情報を生成AIに参照させ、回答の根拠を持たせたい場面で検討されることが多いテーマです。
一方で、仕組みを理解しないまま進めると、「とりあえず文書を入れれば使える」と考えてしまい、検索精度や運用面でつまずくことも少なくありません。
「RAGとはそもそも何?」
「どうやって構築するの?」
「文書分割やベクトル化はなぜ必要?」
そこで、こちらの記事では、RAG構築の基本から、検索と回答生成の仕組み、実装の全体フロー、精度向上の考え方、活用事例、ファインチューニングとの違いまでを順に整理します。
これからRAG導入を検討する方はもちろん、PoCや要件整理の前提知識を短時間で押さえたい方にも役立つ内容です。
RAG構築とは
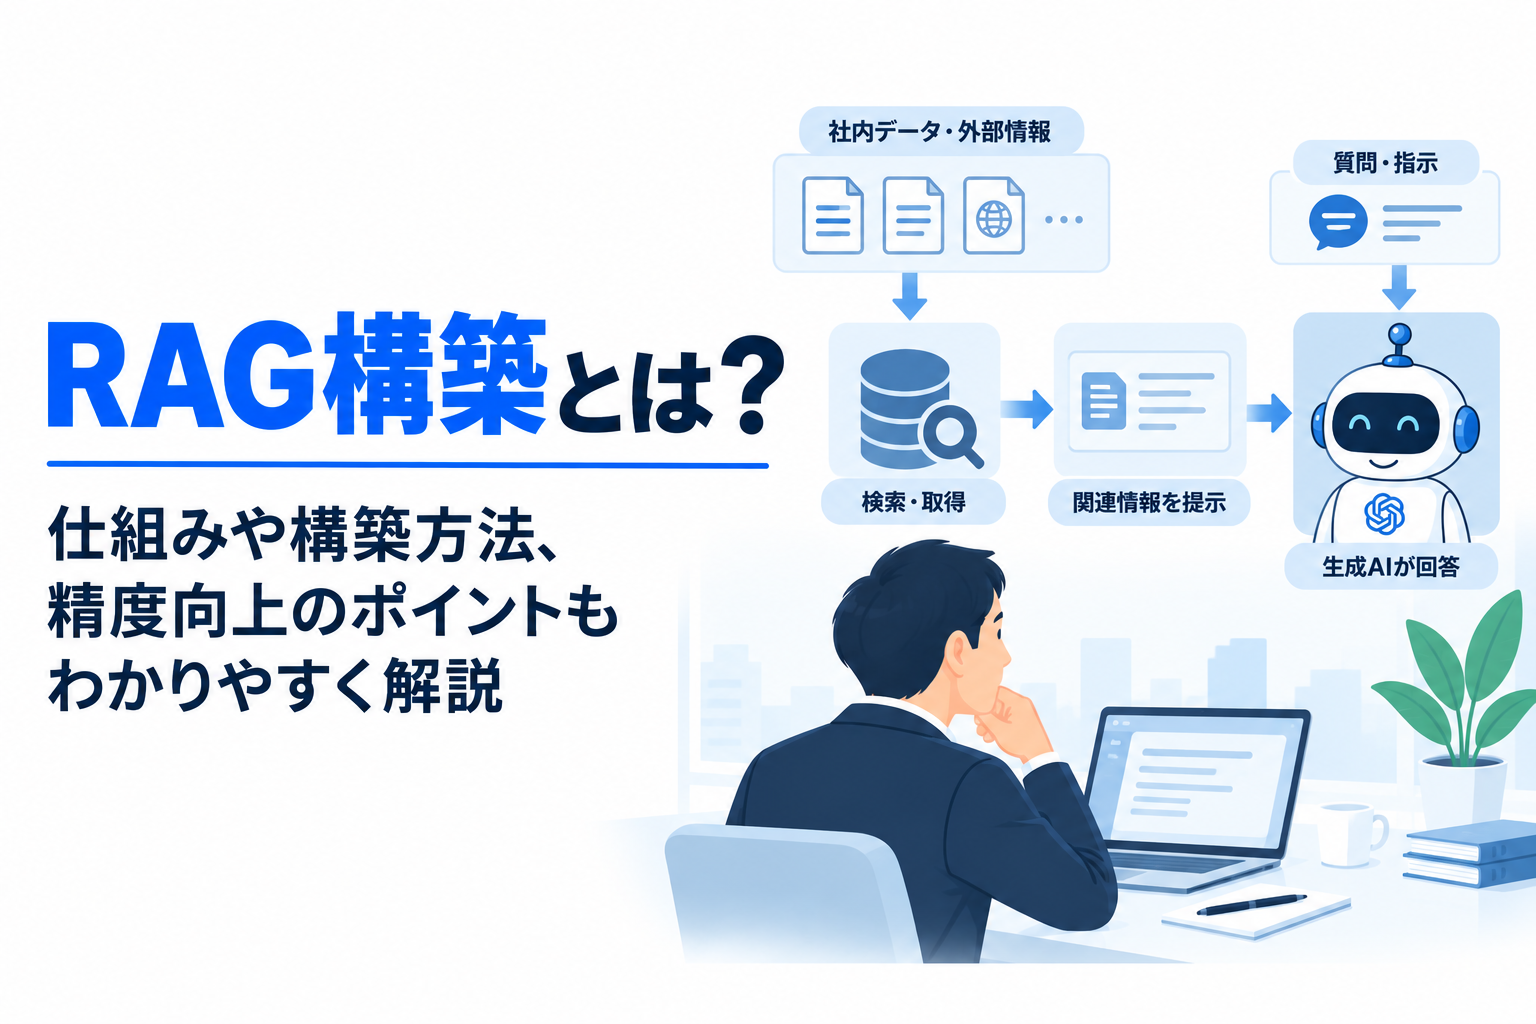
RAG構築とは、生成AIが回答を作る前に外部データを検索し、その結果を参照して回答できるようにする仕組みを設計・実装することです。
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と訳されます。
通常のLLMは学習済みの知識をもとに回答しますが、RAGでは社内文書や製品資料、規程集、FAQなどを都度検索してから回答を生成します。
そのため、社内固有の情報や最新情報を回答へ反映しやすくなる点が大きな特徴です。
たとえば、就業規則の問い合わせ対応、営業資料の検索、カスタマーサポート向けナレッジ参照などでは、LLM単体よりもRAGのほうが実務に適しやすい場面があります。
ただし、RAGは単に文書をアップロードすれば完成するものではありません。
どのデータを使うか、どう分割するか、どのように検索するか、検索結果をどうLLMへ渡すかによって、使い勝手も回答精度も大きく変わります。
構築前には、対象業務やデータの性質を踏まえてAI開発の要件定義で整理すべき項目を明確にしておくことが大切です。
RAG構築の仕組み
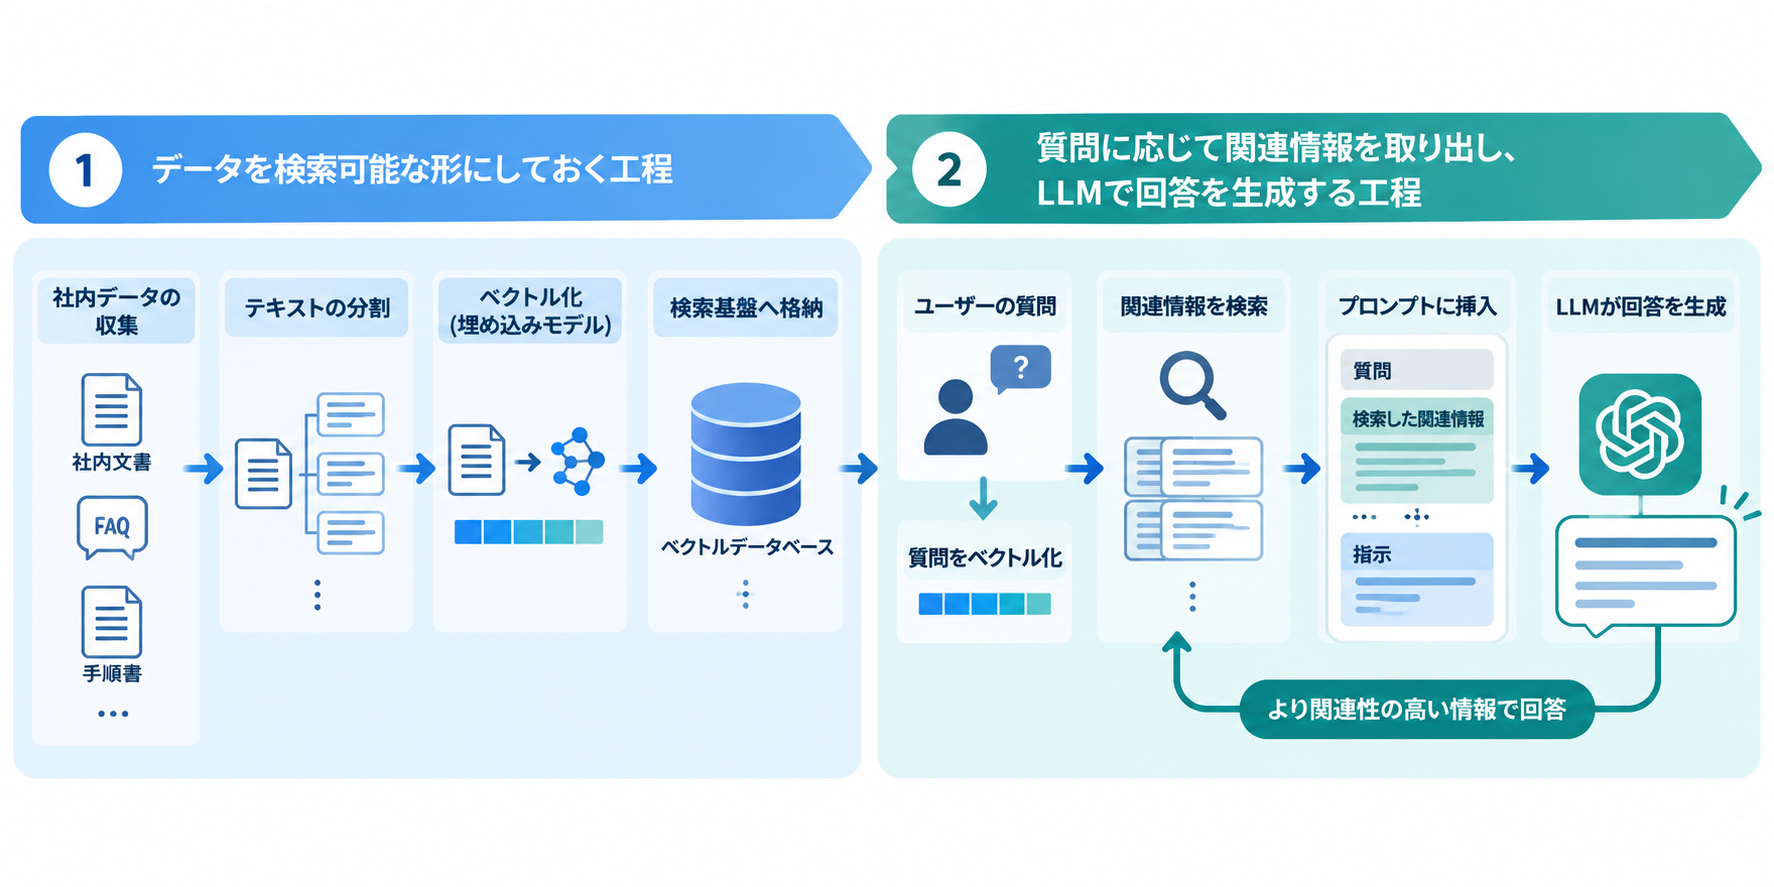
RAGの仕組みは、大きく分けると「データを検索可能な形にしておく工程」と「質問に応じて関連情報を取り出し、LLMで回答を生成する工程」の2段階で成り立ちます。
まず、社内文書やFAQ、手順書などの情報源を収集し、検索しやすい単位へ分割します。
一般的なRAGでは、そのうえでテキストを埋め込みモデルでベクトル化し、ベクトルデータベースなどの検索基盤へ格納します。
ユーザーが質問すると、その質問文もベクトル化され、意味的に近い文書断片が検索されます。
検索された情報はプロンプトに挿入され、LLMはその内容を踏まえて回答を生成します。
この流れによって、回答の根拠を社内データへ近づけやすくなります。
一方で、検索対象にノイズが多い、分割が粗すぎる、関連文書の絞り込みが弱いと、LLMへ渡す情報の質が下がります。
結果として、もっともらしいが根拠の弱い回答が出ることもあるため、LLMの性能だけでなく検索基盤の設計が重要です。
なお、仕組みの理解に加えて実際の実装イメージまで詳しく確認したい場合は、RAGの作り方を整理した記事も参考になります。
RAG構築の全体フロー
RAG構築は、一般的に次のような流れで進みます。
- 対象業務と目的を整理する
- データソースを選定する
- 文書を分割・構造化する
- 埋め込みでベクトル化する
- ベクトルデータベースへ格納する
- 検索ロジックを設計する
- LLMと連携して回答生成を実装する
- 評価・改善を繰り返す
最初に整理したいのは、何のためにRAGを使うのかという目的です。
社内問い合わせ対応、コールセンター支援、営業ナレッジ検索など、用途が変われば必要なデータも評価方法も変わります。
次に重要なのがデータソースの選定です。
古い資料や重複ファイルが多い状態で始めると、検索結果の質が安定しにくくなります。
そのため、利用頻度が高く、更新ルールがある文書群から始めるほうが現実的です。
構築後は一度作って終わりではなく、検索ヒット率や回答の妥当性を見ながら改善を重ねる必要があります。
RAGは初期実装よりも、評価と改善の設計まで含めて考えることで実務に乗りやすくなります。
技術実装だけでなく、PoCから本番運用までの進め方を整理したい場合は、RAGの導入方法もあわせて確認しておくと全体像をつかみやすいでしょう。
文書の分割と構造化
RAG構築で見落とされやすいのが、文書の分割と構造化です。
同じデータを使っていても、この設計次第で検索精度は大きく変わります。
文書分割では、1つの文書をそのまま丸ごと保存するのではなく、意味のまとまりごとに小さな単位へ分けます。
これをチャンク分割と呼びます。
チャンクが大きすぎると、質問と関係の薄い情報まで一緒に取り込まれやすくなります。
逆に小さすぎると、必要な前後関係が失われてしまい、文脈を正しく参照できないことがあります。
たとえば、就業規則なら「休暇制度全体」を1チャンクにするより、「対象者」「申請条件」「例外事項」などの意味単位で整理したほうが検索しやすくなります。
また、見出し構造や章立てを保ったまま分割することも有効です。
単純に文字数だけで切るより、文書の構造を活かした分割のほうが、回答の根拠として使いやすい断片を作りやすくなります。
さらに、タイトル、文書種別、更新日、部署、製品名などのメタデータを持たせておくと、検索時の絞り込みやアクセス制御にも活用できます。
RAGの精度が十分でない場合は、LLMの変更だけでなく、まず文書分割や検索設計に改善余地がないか確認することが重要です。
埋め込みによるベクトル化とベクトルデータベース
RAGでは、文書をそのまま文字列検索するだけでなく、意味の近さで検索できるようにするため、埋め込みによるベクトル化を行う構成が広く使われています。
埋め込みとは、テキストの意味的な特徴を数値の並びとして表現する処理です。
これにより、「有給休暇の取得条件」と「休暇申請のルール」のように表現が少し違っても、意味的に近い文書を見つけやすくなります。
ベクトル化したデータを保存し、類似検索に利用できるようにするのがベクトルデータベースです。
ベクトル検索を利用する場合は、質問文も埋め込みモデルでベクトル化し、近い文書チャンクを検索します。
ただし、ベクトル検索だけで万能というわけではありません。
専門用語や製品番号、固有名詞などを扱う場合は、ベクトル検索だけでなくキーワード検索を組み合わせるハイブリッド検索が有効なケースもあります。
また、文書タイトルや更新日、部署名などのメタデータを併用すると、単なる類似度検索よりも実務向けの検索にしやすくなります。
たとえば「2024年以降の人事制度」「営業部向け提案資料」のように条件を加えると、対象外の情報を減らしやすくなります。
一方で、埋め込みの再生成、ベクトルDBの更新、差分取り込みの仕組みまで考えておかないと、文書更新に追従しにくくなります。
検索基盤は初期構築だけでなく、更新運用まで見据えて設計する必要があります。
検索とLLM連携の実装ポイント
RAGの実装では、検索で取れた文書をそのままLLMへ渡せばよいわけではありません。
どの文書を何件渡すか、どの順序で並べるか、どのような指示文と組み合わせるかによって、回答品質は変わります。
まず考えたいのは、取得件数です。
関連文書が少なすぎると根拠不足になり、多すぎると不要情報が混ざって回答がぼやけやすくなります。
そのため、top-kの件数は固定せず、用途ごとに検証する必要があります。
次に、検索結果の並び順も重要です。
最初の類似検索だけでは精度が足りない場合、rerankingを挟んで質問との関連性が高い順に再評価する方法がよく使われます。
これにより、表面的には似ていても本当に必要な文書を上位に寄せやすくなります。
プロンプト設計では、「検索結果に基づいて答える」「根拠が不十分なら不明と答える」「参照元を示す」などのルールを明示すると、過度な推測回答を抑えやすくなります。
また、回答不能時の扱いも実装上の大切な論点です。
無理に答えさせるのではなく、該当文書なし、情報不足、確認先案内などの分岐を用意しておくと、実務で使いやすくなります。
検索と生成の境界を曖昧にせず、どこまでが根拠情報で、どこからが生成処理なのかを設計することが安定運用につながるでしょう。
RAG構築で精度を上げるポイント
RAGの精度を高めるには、モデルの選定だけでなく、前処理から運用設計まで一貫して見直すことが必要です。
とくに次の観点は、実務上の改善に直結しやすい要素です。
- 重複・古い文書・ノイズを除くクレンジング
- 見出しや文脈を保ったチャンク分割
- 部署名や更新日などのメタデータ設計
- 類似検索後のreranking導入
- ユーザー権限に応じた検索対象の制御
- 検索評価と回答評価の指標設計
まず、データクレンジングは優先して確認したい項目です。
誤記や古い版、重複資料が混在していると、検索結果そのものが不安定になる原因になります。
次に、メタデータ設計を行うことで、意味検索だけでは拾いきれない条件を補いやすくなります。
たとえば製品別、部門別、最新版のみといった絞り込みができるようになると、業務での使い勝手が大きく変わります。
さらに、社内利用ではアクセス権限の考慮も欠かせません。
検索精度が高くても、閲覧権限のない文書を参照できてしまう設計では運用できません。
精度向上と同じくらい、権限制御や監査の設計もRAG構築では重要です。
評価面では、正答率だけでなく、根拠文書の適合性、回答不能時の挙動、更新後の再現性も見ておく必要があります。
スモールスタートで検証し、利用ログをもとに改善する進め方が現実的です。
RAG構築の活用事例
RAGは幅広い用途に使えますが、効果が出やすいのは「文書量が多い」「情報更新がある」「担当者によって回答品質がぶれやすい」業務です。
代表的な活用例としては、次のようなものがあります。
- 社内規程やマニュアルを参照する総務・人事向け問い合わせ対応
- 製品仕様書や提案資料を検索する営業支援
- 過去FAQやサポート履歴をもとにしたカスタマーサポート支援
- 設計書や障害対応記録を横断検索する開発・情報システム部門向けナレッジ検索
- 法務・コンプライアンス文書を参照する社内確認業務
たとえば社内ヘルプデスクでは、担当者が複数システムのマニュアルを横断して調べる手間を減らせる可能性があります。
営業部門では、類似提案や業界別資料を検索しながら、提案文案のたたき台を短時間で作りやすくなります。
サポート領域では、公開FAQだけでなく内部ナレッジも含めて参照できれば、一次回答のスピード向上が期待できます。
活用イメージをさらに広げたい場合は、RAGの活用事例をまとめた記事も参考になります。
ただし、どの業務でも向いているわけではありません。
定型ルールが少なく、判断根拠が文書化されていない業務では、RAGだけでは十分な効果が出にくいこともあります。
まずは検索対象が明確で、回答根拠を文書で示せる領域から始めるのが無理のない進め方です。
RAGとファインチューニングの違い
RAGとファインチューニングは混同されやすいですが、役割は異なります。
RAGは、外部データを検索して回答時に参照させる仕組みです。
一方のファインチューニングは、追加データを使ってモデル自体の振る舞いや出力傾向を調整する方法です。
RAGが向いているのは、社内文書、FAQ、製品情報など、モデルが持っていない固有知識や更新される情報を回答時に参照させたいケースです。
データ更新のたびにモデルを再学習させる必要がないため、情報の追加や更新に対応しやすいという特徴があります。
反対にファインチューニングは、特定の文体や出力形式に寄せたい、特定タスクに対する振る舞いを調整したいといった場面で検討されます。
最新情報や社内固有の知識を参照して回答させたい場合はRAG、モデルの出力形式や振る舞いを特定のタスクに合わせて調整したい場合はファインチューニングと整理すると分かりやすいでしょう。
もちろん、両者を組み合わせるケースもあります。
どちらか一方を選ぶものとは限らないため、実現したい目的に応じて使い分けることが大切です。
RAG構築の費用はどう決まるのか
RAG構築の費用は、構築方法や開発範囲、対象データの状態、求める検索精度などによって大きく変わります。
そのため、市場全体の代表的な金額だけを見るのではなく、どのような方法で構築するのか、見積もりに何が含まれているのかを確認することが重要です。
RAGの構築方法
RAGを構築する方法は、大きく次のように分けられます。
- SaaSやパッケージを利用する
- ローコードツールや既存サービスを組み合わせて構築する
- 自社の要件に合わせてフルスクラッチで開発する
SaaSやパッケージを利用する方法は、比較的短期間で導入しやすい一方、機能や連携先、カスタマイズ範囲に制約がある場合があります。
ローコードツールや既存サービスを組み合わせる方法は、開発負担を抑えながら一定のカスタマイズ性を確保しやすい方法です。
一方、既存システムとの複雑な連携や高度な権限制御、独自の検索ロジックなどが必要な場合は、フルスクラッチ開発が検討されます。
どの方法が適しているかは、必要な機能だけでなく、社内の開発体制や運用体制も踏まえて判断する必要があります。
外注する場合の契約・料金体系
外部の開発会社や支援会社へ依頼する場合は、開発フェーズや支援範囲によって契約・料金体系も変わります。
- PoC単位で小規模な検証を依頼する
- 本番開発をプロジェクト単位で依頼する
- 準委任契約で開発チームや専門人材の支援を受ける
- 請負契約で要件に沿ったシステム開発を依頼する
- 保守・運用・改善を月額契約で依頼する
PoCだけで終えるのか、本番開発まで行うのか、公開後の運用改善まで含めるのかによって、必要な予算や契約期間は変わります。
また、LLMのAPI利用料や検索基盤などのインフラ費用が開発費とは別に従量課金となるケースもあるため、初期費用だけで比較しないことが重要です。
RAG構築の費用を左右する主な要因
料金が変動しやすい要因としては、対象データの量や品質、OCRやクレンジングの有無、検索精度への要求水準、既存システム連携の数、セキュリティ要件、権限制御、UIの作り込み、運用設計の範囲などが挙げられます。
とくに、社内文書が整理されていない場合は前処理の負荷が大きくなりやすく、想定より工数が膨らくことがあります。
見積もりを確認する際は、次の点を分けて見ると判断しやすくなります。
- PoC費用に評価設計や検証レポートまで含まれるか
- PoC後の本番開発費が別見積もりか
- 初期構築費と月額運用費が分離されているか
- LLM利用料やベクトル検索などの従量課金が明記されているか
- データ整備、OCR、既存システム連携が見積もり範囲に入っているか
- 権限制御、監査ログ、SSOなどの非機能要件が含まれているか
- 回答精度の評価方法や合格基準が定義されているか
- 保守に含まれる作業範囲が明記されているか
RAGは構築そのものだけでなく、データ更新や検索精度の改善など、運用開始後にも継続的な対応が必要になる場合があります。
そのため、初期費用だけで判断せず、運用時の従量課金や改善工数まで含めて確認することが欠かせません。
RAG構築でよくある質問
Q.1 どのくらいのデータ量があればRAGを構築できますか?
大量データがなければ構築できないわけではありません。むしろ初期段階では、よく使うFAQや特定部門のマニュアルなど、対象を絞ったデータから始めるほうが検証しやすいです。重要なのは量よりも、質問に対する根拠文書が存在すること、文書の更新ルールがあること、内容がある程度整理されていることです。
Q.2 RAGとファインチューニングは何が違うのですか?
RAGは外部データを検索して回答時に参照する仕組みで、ファインチューニングはモデル自体の出力傾向や振る舞いを調整する方法です。最新情報や社内固有の知識を参照させたい場合はRAGが向いており、出力形式や応答パターンなどを特定の用途に合わせて調整したい場合はファインチューニングが検討対象になります。
Q.3 RAG構築で最初に取り組むべきことは何ですか?
最初に行いたいのは、対象業務とデータソースの整理です。何を検索できるようにしたいのか、誰が使うのか、どの文書を根拠に回答させるのかが曖昧なままでは、構築後の評価もしにくくなります。小さなユースケースを定めて始めるのが現実的です。
Q.4 ベクトルデータベースは必ず必要ですか?
必ずしもベクトルデータベースが必要とは限りません。意味的な類似性を使って検索するRAGではベクトル検索が広く利用されていますが、要件によってはキーワード検索や既存の検索エンジンを活用する方法もあります。また、ベクトル検索とキーワード検索を組み合わせるハイブリッド検索も選択肢です。扱う文書や検索要件に応じて検索方式を設計することが重要です。
Q.5 RAGは内製と外注のどちらがよいですか?
社内に検索基盤、LLM連携、データ整備、運用改善まで担える体制があれば内製も可能です。一方で、要件整理やPoC設計、精度評価、セキュリティ対応に不安がある場合は、外部支援を活用したほうが立ち上がりが早いこともあります。必要な技術と社内体制、構築後の運用まで踏まえて判断しましょう。
RAG構築を着実に進めよう
RAG構築で重要なのは、生成AIを導入すること自体ではなく、どの業務で、どの文書を根拠に、どの水準の回答を求めるのかを明確にすることです。
同じRAGでも、社内FAQ向けなのか、営業資料検索なのか、規程参照なのかによって、適したデータ設計や検索方法は変わります。
そのため、単に「最新技術だから」「LLMを使いたいから」という理由だけで進めるのでは十分ではありません。
また、RAG構築では、文書分割、埋め込み、検索基盤、検索設計、LLM連携、評価改善といった工程が相互に影響します。
どこか1つだけを最適化しても、全体の使い勝手が上がるとは限らないでしょう。
検討時には、対象データの状態、検索精度の要件、権限制御の必要性、更新運用の方法、見積もりに含まれる範囲を整理しておくことが大切です。
とくにPoCでは、何をもって成功とするのか、どこまで本番前提で検証するのかを先に決めておくと判断しやすくなります。
次のアクションとしては、まず小さなユースケースを定め、対象文書を洗い出し、評価観点を決めたうえでスモールスタートするのが現実的です。
自社だけでの構築が難しい場合は、RAGの要件整理やPoC、本番開発まで支援できる外部パートナーを活用する方法もあります。
外注を検討している方は、RAG開発会社を比較した記事も参考に、自社の目的や開発範囲に合う会社を検討してみてください。
費用、精度、運用体制、セキュリティ要件まで含めて整理していくことで、自社に合ったRAGの形を見つけやすくなります。