LLM(大規模言語モデル)開発とは?仕組みや必要なスキル、費用相場を解説
LLM開発は、社内検索、文書要約、問い合わせ対応、業務支援チャットなど、企業のさまざまな業務に活用されています。
ただし、実際に検討を始めると、「LLMとは何か」「生成AIとどう違うのか」「RAGやファインチューニングはいつ使うのか」など、開発方法の違いが分かりにくいことも多いでしょう。
また、LLMをゼロから開発するケースだけでなく、既存LLMのAPI利用やRAGなど複数の選択肢があるため、自社にどの方法が適しているのかを見極めることも重要です。
そこで、こちらの記事では、LLM開発の基礎から仕組み、前処理、必要なスキル、主な開発方法、外注・導入の流れ、費用相場までわかりやすく解説します。
これからLLMを業務やサービスに取り入れたい方は、自社に合った開発方法を検討する際の参考にしてください。
エラビサキでは、各社の公式サイト・サービスページ・導入事例・プレスリリースなどの公開情報を確認し、記事ごとに設定した比較項目から各社を評価しています。
- ◎:専用サービスや明確な対応実績などを公式情報で確認
- ○:対応していることを公式情報で確認
- 要確認:公開情報だけでは対応状況を判断できない
「要確認」は非対応を意味するものではありません。料金・実績・対応技術など、公式情報で確認できない内容は推測せず、確認できた情報のみを掲載しています。
LLM開発とは
LLM開発とは、大規模言語モデルを業務やサービスで使える形に設計・構築・実装することです。
ここでいう開発は、基盤モデルそのものをゼロから作る場合だけを指しません。
既存のLLMをAPIで利用したり、自社データを組み合わせて業務向けに最適化したり、RAG構成で社内文書を参照できるようにしたりする取り組みも、実務では広くLLM開発に含まれます。
つまり、企業にとって重要なのは「モデルを研究開発すること」だけではなく、自社の業務で安全かつ実用的に使える仕組みとして整えることです。
そのため、LLM開発ではモデル選定だけでなく、要件整理、データ整備、評価方法、セキュリティ、システム連携まで含めて考える必要があります。
LLMと生成AIの違い
生成AIは、文章、画像、音声、コードなどを生成するAI全体を指す広い概念です。
一方でLLMは、その中でも大量のテキストデータを学習し、自然な文章生成や要約、分類、質問応答などを行う言語特化のモデルを指します。
つまり、LLMは生成AIの一種です。
企業の現場では、この違いを整理しておかないと、画像生成のような話と社内文書検索のような話が混ざってしまい、検討の前提がぶれやすくなります。
たとえば、社内ナレッジ活用や文書ベースの問い合わせ対応を考えるなら、主役になるのは画像生成AIではなくLLMです。
また、LLMを業務で使う方法には、そのままAPI利用する形もあれば、RAG構築によって自社文書を参照させる形もあります。
自社の検討テーマが「生成AI全般」なのか、「言語処理中心のLLM活用」なのかを早めに切り分けておくと、要件定義や発注先の選定が進めやすくなるでしょう。
LLMの仕組み
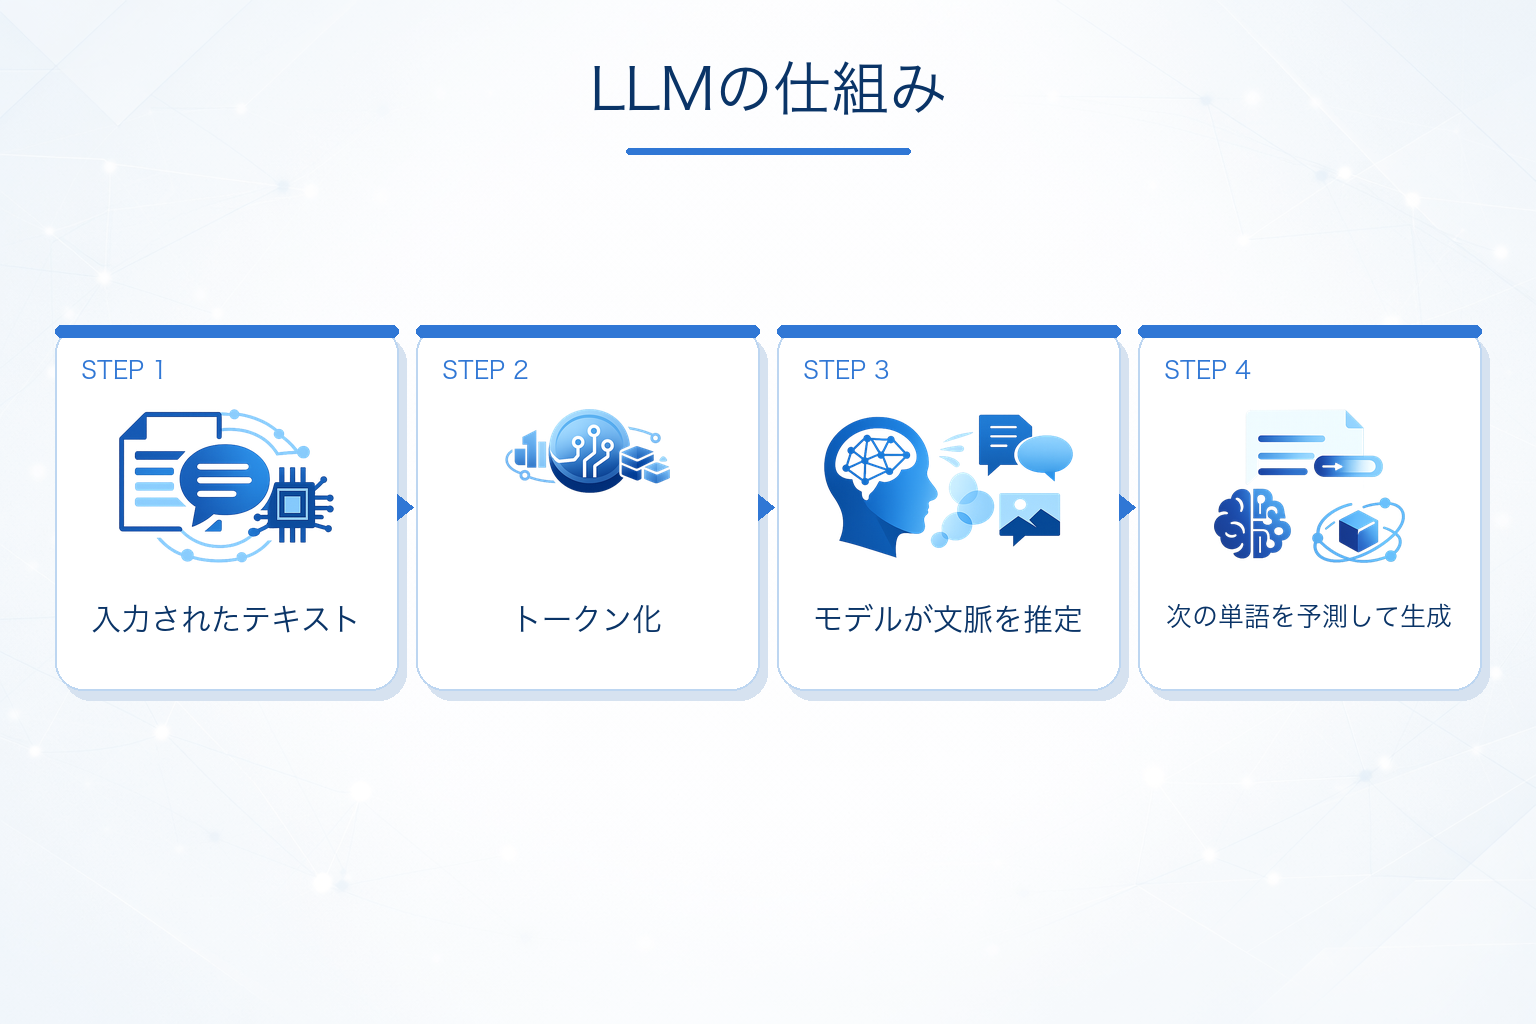
LLMは、入力された文章を細かな単位に分け、その並びや関係から文脈を推定し、次に続く単語や表現を予測しながら文章を生成します。
基本の流れは、テキスト入力、トークン化、文脈理解、次トークン予測、出力生成という形です。
人間のように意味を理解しているというより、膨大な学習データをもとに、文脈に合う確率の高い表現を出力していると考えると捉えやすいでしょう。
この仕組みがあるため、自然な会話、要約、分類、翻訳、文章生成など幅広いタスクに対応できます。
一方で、学習していない最新情報や社内固有情報は、そのままでは扱えません。
そのため企業利用では、外部LLMをそのまま使うだけではなく、自社データを参照させる仕組みや評価プロセスを組み合わせることが重要になります。
LLMの出力品質は、モデル単体の性能だけでなく、入力設計や参照データの整備でも大きく変わります。
LLM開発の前処理で行うこと
LLM開発では、利用するデータを目的に合わせて整える前処理が重要です。
ただし、必要な前処理は、RAGを構築するのか、ファインチューニングを行うのか、基盤モデルそのものを開発するのかによって異なります。
RAGで行う主な前処理
RAGでは、社内文書やマニュアルなどのデータを検索しやすい状態に整える必要があります。
- 文書の収集・形式統一
- 不要な情報や重複データの除去
- 文書の適切な単位への分割(チャンク分割)
- メタデータの付与
- 埋め込み(Embedding)の生成
- 検索用データベースへの登録
とくに文書の分割方法やメタデータ設計は検索精度に影響するため、単にデータを登録するだけではなく、実際の質問を想定して設計することが重要です。
ファインチューニングで行う主な前処理
ファインチューニングでは、モデルに追加学習させるデータを目的に合わせて整備します。
- 学習データの収集
- 誤りや重複、不要データの除去
- 学習目的に合わせたデータ形式への変換
- 学習用・検証用データの分割
- データ品質の確認
学習データの量だけでなく、内容の正確性や一貫性もモデルの出力品質に影響します。
基盤モデル開発ではさらに大規模なデータ処理が必要
LLMそのものを事前学習から開発する場合は、大規模な学習データの収集やクリーニング、重複除去、トークン化など、より大規模なデータ処理が必要になります。
既存LLMをAPIで利用するだけの場合は、こうしたモデル学習向けの前処理を自社で行う必要は通常ありません。
LLM開発では、すべての前処理を行うのではなく、採用する開発方法に応じて必要なデータ処理を設計することが重要です。
LLM開発に必要なスキル
LLM開発には、単一の技術だけではなく、複数領域をまたぐスキルが求められます。
研究寄りの基盤モデル開発と、企業向けの業務実装では必要な比重が異なるものの、少なくとも次の観点は押さえておきたいところです。
- 自然言語処理や機械学習の基礎知識
- データ収集、前処理、評価設計の実務力
- API連携やアプリケーション実装の開発力
- クラウド、GPU、推論基盤などインフラ理解
- セキュリティ、権限管理、監査対応の知識
- 業務要件を整理する要件定義力
とくに企業導入では、モデル精度だけでなく、既存システムとの接続、ログ管理、利用部門への定着まで見なければなりません。
そのため、純粋なAIエンジニアリングだけでなく、AI開発の要件定義を進める力も欠かせません。
また、自社だけでこれらを一度にそろえるのが難しい場合は、PoCや導入初期だけ外部パートナーを活用する方法も現実的です。
LLMでできることと課題
LLMでできることは幅広く、文章生成、要約、社内文書検索、問い合わせ対応、議事録整理、分類、翻訳などが代表例です。
企業では、とくに社内ナレッジ活用や文書業務の効率化で導入が検討されやすい傾向があります。
また、既存システムや業務フローと組み合わせることで、単なるチャットツールではなく、業務プロセスの一部として運用しやすくなります。
一方で課題もあります。
最新情報や社内固有情報に弱い、誤った内容をもっともらしく出力する、権限のない情報に触れるリスクがある、プロンプトインジェクション対策が必要といった点は、導入前に整理しておく必要があります。
また、回答品質をどのように測るかが曖昧なままPoCを進めると、期待と実態がずれてしまいがちです。
「使えるかどうか」ではなく、「どの業務で、どの精度なら実用とみなすか」まで決めて検証することが大切です。
導入検討の段階では、生成AI 導入方法の全体像も合わせて押さえておくと、業務展開をイメージしやすくなります。
LLM開発の主な4つの方法
LLM開発といっても、必ずしも大規模言語モデルをゼロから開発する必要はありません。
企業がLLMを業務やサービスに導入する方法は、大きく分けると「既存LLMのAPI利用」「RAG」「ファインチューニング」「独自LLMの開発」の4つがあります。
既存LLMをAPIで利用する
もっとも取り組みやすいのが、既存のLLMをAPI経由で利用し、自社のシステムやアプリケーションに組み込む方法です。
基盤モデルを自社で開発・運用する必要がないため、比較的短期間で検証を始めやすく、チャット、文章生成、要約、分類など幅広い用途に活用できます。
一方で、自社固有の情報を回答に反映させたい場合は、RAGなど別の仕組みを組み合わせる必要があります。
RAGで自社データを参照させる
RAGは、社内文書やマニュアルなどから関連情報を検索し、その情報をLLMに与えて回答を生成する方法です。
モデルそのものを再学習させなくても、自社固有の情報を活用できるため、社内検索や問い合わせ対応、ナレッジ活用などに向いています。
ただし、回答品質はLLMだけでなく、文書の分割方法や検索方式、参照データの品質などにも左右されます。
ファインチューニングでモデルを調整する
ファインチューニングは、特定のデータを使って既存モデルを追加学習し、特定のタスクや出力傾向に適応させる方法です。
特定形式の出力や専門的なタスクへの適応などに活用できますが、最新の社内情報をその都度参照させる用途では、RAGのほうが適している場合があります。
そのため、「何をモデル側に学習させたいのか」を明確にしたうえで採用することが重要です。
独自LLMを開発する
自社で基盤モデルそのものを開発したり、既存のオープンモデルなどをベースに独自モデルを構築したりする方法もあります。
モデルや実行環境を自社の要件に合わせやすい一方で、大量のデータや計算資源、高度な専門人材が必要になるため、API利用やRAGと比べて開発・運用のハードルは高くなります。
企業のLLM開発では、最初から独自LLMを目指すのではなく、解決したい課題に応じてAPI利用、RAG、ファインチューニングなどを使い分けることが重要です。
LLM開発を外注・導入する流れ
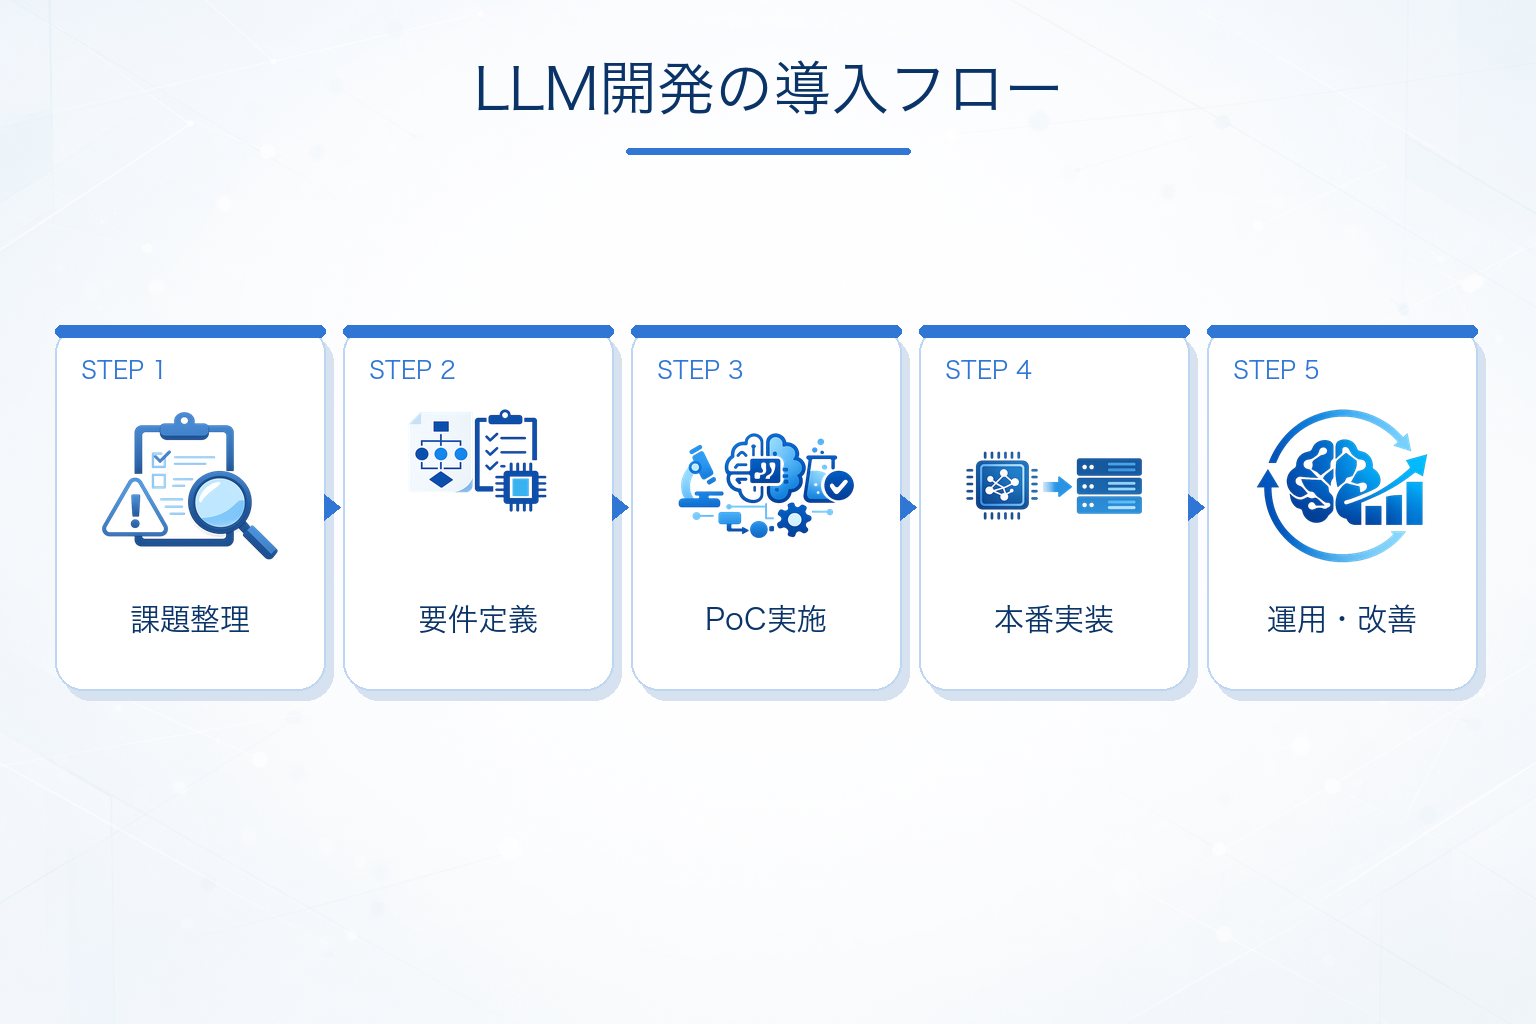
LLM開発を外注・導入する場合は、一般的に次のような流れで進みます。
- 課題と利用目的を整理する
- 対象業務と必要なデータを洗い出す
- 候補企業へ問い合わせる
- 要件定義と実現方法をすり合わせる
- PoCを実施して精度と業務適合性を検証する
- 本番実装とシステム連携を行う
- 運用、改善、定着化を進める
とくに重要なのは、PoC前の要件整理です。
どの業務で使うのか、どの文書を参照させるのか、誤回答をどこまで許容できるのかが曖昧だと、検証結果を評価しにくくなります。
PoCの進め方を詰める際は、AI PoC 進め方も参考になります。
また、PoCから本番移行するときに再構築が必要になる設計もあるため、初期段階で本番想定のアーキテクチャかどうかを確認しておくことが大切です。
たとえば、社内文書検索で始めるなら、「対象文書の選定 → 権限制御設計 → RAG検証 → 利用部門テスト → 本番展開」という流れで見ていくと、抜け漏れを防ぎやすくなります。
LLM開発の費用相場
LLM開発の費用は、PoCだけを行うのか、RAGや業務システムまで構築するのかによって大きく異なります。
2026年時点で公開されている生成AI・LLM開発の料金情報を見ると、小規模なPoCでは100万〜500万円前後、本番環境で利用するシステムの開発では500万〜2,000万円以上がひとつの目安になります。
| 開発内容 | 費用の目安 | 主な内容 |
|---|---|---|
| PoC・プロトタイプ | 100万〜500万円前後 | 対象業務を限定した実現可能性・精度の検証 |
| RAG・社内検索など | 300万〜800万円前後 | 社内文書の整備、検索設計、回答生成、評価など |
| 本番システム開発 | 500万〜2,000万円以上 | UI、認証・権限制御、既存システム連携、テスト、本番環境構築など |
| 運用・継続改善 | 月額数十万〜100万円程度が目安 | ログ分析、データ更新、プロンプト改善、保守など |
ただし、上記はあくまで公開されている複数の生成AI・LLM開発費用から整理した目安です。同じ「LLM開発」でも、既存LLMのAPIを使った小規模なシステムと、複数の社内システムやデータベースを連携する本番システムでは必要な工数が大きく異なります。
とくに費用を左右しやすいのは、次のような要素です。
- PoCで止めるか、本番導入まで進めるか
- 既存LLMを利用するか、独自モデルを構築するか
- RAGやファインチューニングを行うか
- データ整備や前処理がどこまで必要か
- 参照する文書やデータの量
- 既存システムやデータベースとの連携数
- ユーザー認証やアクセス権限をどこまで設計するか
- セキュリティや監査対応の要件
- LLM APIやクラウドなどの利用量
- 導入後の運用・改善をどこまで外注するか
また、LLM開発では初期の開発費だけでなく、LLM APIやクラウド、保守・改善などのランニングコストも発生します。
そのため見積もりを比較するときは、要件定義、PoC、本番開発、データ整備、システム連携、API・クラウド利用料、運用保守のどこまでが含まれているかを確認しましょう。
初期費用だけで判断せず、本番稼働後の利用料や改善費まで含めた総額で比較することが重要です。
よくある質問
Q.1 LLMとは何ですか?
LLMはLarge Language Modelの略で、大量のテキストデータを学習し、文章生成、要約、分類、質問応答などを行う大規模言語モデルです。企業では、社内検索、問い合わせ対応、文書要約、ナレッジ活用などの用途で検討されることが多いです。
Q.2 LLMと生成AIの違いは何ですか?
生成AIは文章、画像、音声、コードなどを生成するAI全体の総称で、LLMはその中でも言語処理に特化したモデルです。つまり、LLMは生成AIの一種であり、文章中心の業務活用を考えるときに重要な技術領域といえます。
Q.3 LLM開発に必要なスキルは何ですか?
自然言語処理や機械学習の知識に加えて、データ前処理、API連携、アプリケーション開発、クラウドや推論基盤の理解、セキュリティ対応、要件定義力などが求められます。企業導入では、技術だけでなく業務設計や評価設計も欠かせません。
Q.4 自社でLLM開発を進めるのは難しいですか?
基盤モデルをゼロから作る難易度は高く、実務では既存LLMを活用しながら、自社データ連携やRAG構成、業務アプリ連携を進めるケースが多くなります。自社にAI人材や要件定義の体制が十分でない場合は、PoCや初期導入だけ外部企業へ相談する進め方も現実的です。
Q.5 SaaS型とオンプレ版の違いは?
SaaS型は導入しやすく初期構築の負荷を抑えやすい一方、扱うデータや運用ルールによっては制約が出ることがあります。オンプレミスやローカルLLMは統制しやすい反面、環境構築や運用負荷を見込む必要があります。どちらが適切かは、セキュリティ要件、既存システム、利用部門、更新頻度などで変わります。
Q.6 LLM開発企業はどう選べばいいですか?
コンサル、PoC、実装、運用のどこまで任せたいかを先に決め、そのうえでRAG対応、閉域環境対応、既存システム連携、内製化支援、導入事例などを比較すると選びやすくなります。基盤モデルの強さだけでなく、自社の業務要件に合う支援範囲があるかを見ることが大切です。
自社に合った方法でLLM開発を進めよう
LLM開発は、基盤モデルをゼロから構築することだけを指すものではありません。既存LLMのAPI利用、RAG、ファインチューニング、独自LLMの開発など、目的に応じてさまざまな方法があります。
重要なのは、最初に「どの技術を使うか」を決めるのではなく、どの業務の、どの課題を解決したいのかを明確にすることです。
そのうえで、必要なデータ、求める精度、セキュリティ要件、既存システムとの連携、運用方法などを整理し、自社に適した開発方法を選びましょう。
小さく検証したい場合はAPI利用やPoCから始め、社内情報を活用したい場合はRAGを検討するなど、段階的に進める方法もあります。
自社だけで要件整理や実装を進めるのが難しい場合は、外部の専門会社を活用するのも選択肢です。発注先を検討する際は、LLM開発会社の記事で、対応領域や選び方を比較しています。