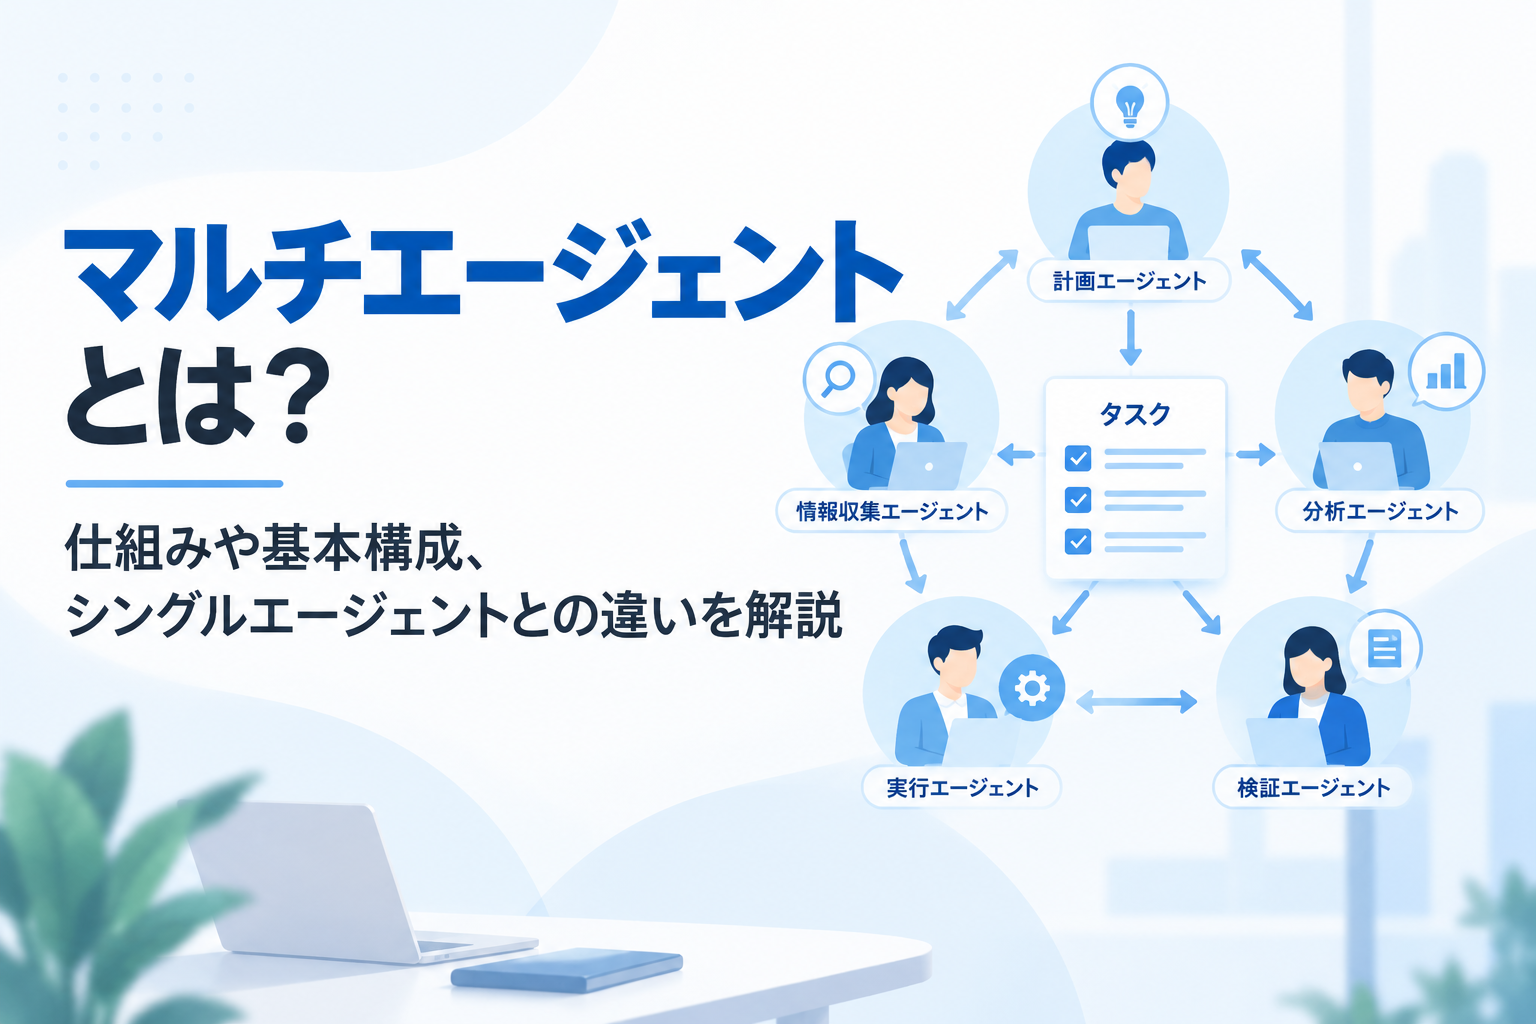
マルチエージェントとは?仕組みや基本構成、シングルエージェントとの違いを解説
マルチエージェントは、複数のAIエージェントが役割分担しながら1つの目的に向かって動く仕組みです。単体のチャットボットや1つのAIエージェントでは対応しにくい、複数工程にまたがる業務や専門性の分かれたタスクで注目されています。
とはいえ、「シングルエージェントと何が違うのか」「どんな構成で動くのか」「自社業務に本当に必要なのか」といった疑問を持つ方も多いでしょう。
実際には、マルチエージェントは便利そうに見える一方で、設計や運用が複雑になりやすく、向いているケースとそうでないケースを見極めることが欠かせません。
この記事では、マルチエージェントの定義から、シングルエージェントとの違い、基本構成、代表的なアーキテクチャ、構築アプローチ、メリット、課題、活用例まで、導入判断に必要な論点を順番に整理します。
マルチエージェントとは
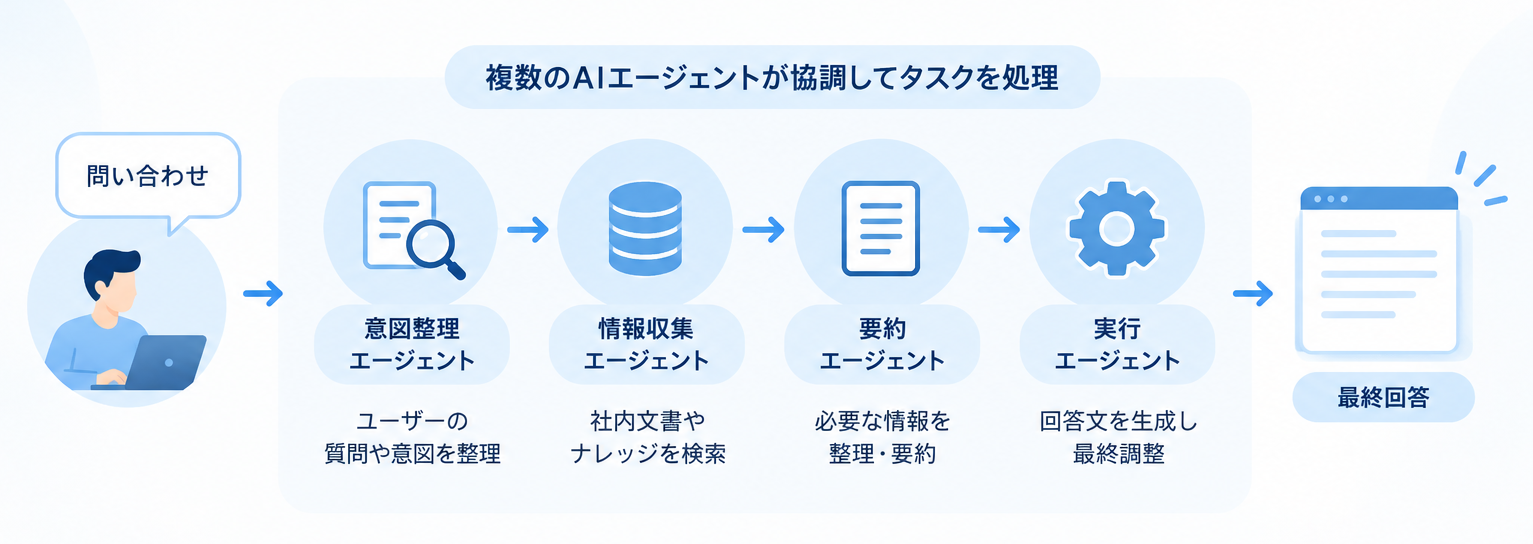
マルチエージェントとは、複数のAIエージェントがそれぞれ異なる役割を持ち、協調しながらタスクを処理する仕組みを指します。
1つのエージェントがすべての判断と処理を担うのではなく、計画担当、情報収集担当、要約担当、実行担当といったように機能を分けることで、複雑な業務を扱いやすくします。
たとえば、問い合わせ対応を高度化する場面では、ユーザー意図を整理するエージェント、社内文書を検索するエージェント、回答文を生成するエージェントを分けて動かす構成が考えられます。
この考え方の本質は、1つの大きな仕事を、そのまま1つのAIに投げるのではなく、複数の役割へ分解して連携させることにあります。
そのため、マルチエージェントは単なる「AIを複数使うこと」ではありません。
役割分担、エージェント間の情報の受け渡し、処理順序、最終的な統合方法まで設計されてはじめて、実務で意味のある仕組みになります。
シングルエージェントとの違い
シングルエージェントは、1つの主体が入力を受け取り、考え、必要に応じてツールを使い、出力まで担う構成です。
構成が比較的シンプルで、小規模な業務自動化や単一目的のチャット機能には向いています。
一方、マルチエージェントは複数の主体が連携して処理します。
違いを整理すると、次のようになります。
| 観点 | シングルエージェント | マルチエージェント |
|---|---|---|
| 処理主体 | 1つのエージェント | 複数のエージェント |
| 役割分担 | 基本的に1つで兼務 | 機能ごとに分担しやすい |
| 設計の複雑さ | 比較的低い | 高くなりやすい |
| 向いているタスク | 単純・単発・単一目的 | 複雑・多段・複数の専門処理 |
| 改善のしやすさ | 原因切り分けが難しい場合がある | 役割ごとに評価・改善しやすい |
重要なのは、マルチエージェントが常に優れているわけではないことです。
タスクが単純なら、シングルエージェントの方が速く、低コストで、運用しやすいことも少なくありません。
逆に、複数の判断工程や専門処理をまたぐ業務では、それぞれの役割を分離したマルチエージェントが適している場合があります。
つまり違いは単純な性能の優劣ではなく、責務の分け方と処理フローの設計にあります。
マルチエージェントの基本構成
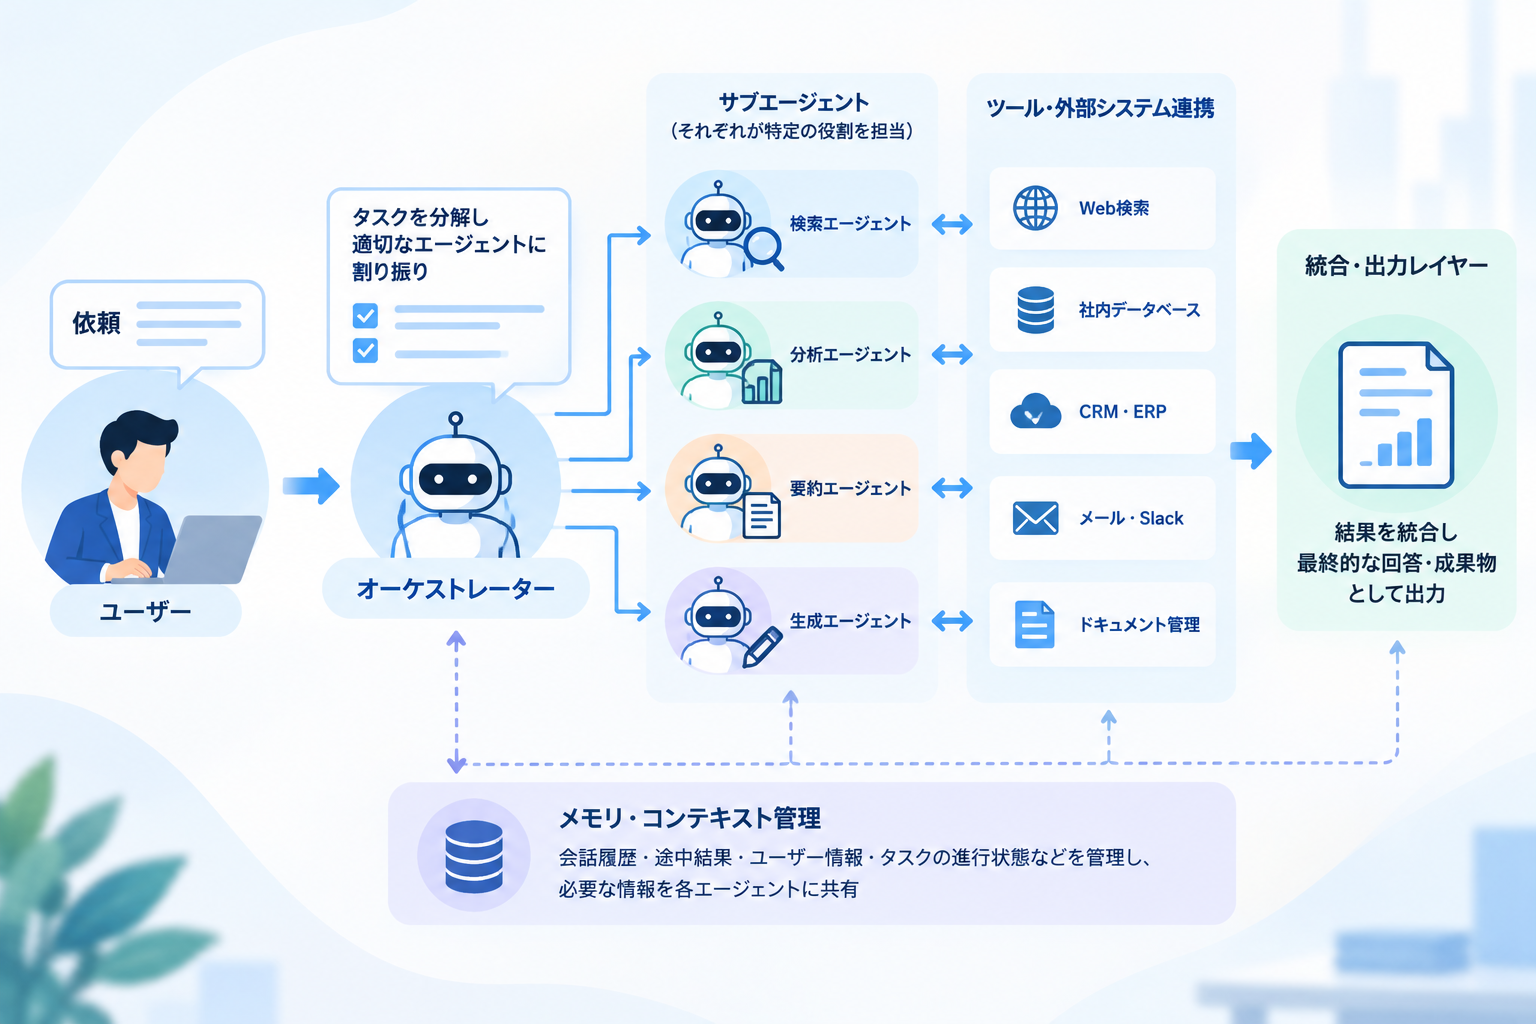
マルチエージェントは、複数の要素を組み合わせて構成します。
すべてのシステムが同じ構造になるわけではありませんが、代表的な構成要素として、オーケストレーター、サブエージェント、ツール、メモリ・コンテキスト管理、統合レイヤーなどがあります。
オーケストレーター
オーケストレーターは、ユーザーの依頼を受け取り、タスクを分解して、どのエージェントに何を任せるかを制御する役割です。
たとえば「競合企業を調査してレポートを作成して」という依頼に対して、調査、分析、レポート作成といった処理へ分解し、それぞれを担当するエージェントへ割り振ります。
実務では司令塔にあたる部分で、全体の処理フローや終了条件、失敗時の再試行などを管理することもあります。
サブエージェント
サブエージェントは、検索、分析、要約、分類、文章生成、レビューなど、特定の役割を担当します。
役割を明確にすると、それぞれのエージェントに適したプロンプトやモデル、ツールを設定しやすくなります。
一方で、役割を細かく分けすぎるとエージェント間の通信や調整が増えるため、必要以上にエージェント数を増やさないことも重要です。
ツール・外部システム連携
AIエージェントが情報取得や業務処理を行うためには、外部ツールとの連携が必要になることがあります。
たとえば、Web検索、社内データベース、CRM、ERP、メール、Slack、ドキュメント管理基盤などと接続することで、AIが情報を参照したり、一定の処理を実行したりできるようになります。
社内文書検索やナレッジ参照を伴う構成では、RAG構築と組み合わせ、検索を担当するエージェントと回答生成を担当するエージェントを分ける方法も考えられます。
メモリ・コンテキスト管理
複数のエージェントが連携する場合、どの情報を共有し、どの情報を各エージェントだけが保持するのかを設計する必要があります。
すべての情報を毎回すべてのエージェントへ渡すと、コンテキストが肥大化し、処理コストや精度に影響する可能性があります。
そのため、会話履歴、途中結果、ユーザー情報、タスクの進行状態などをどこまで保持し、次のエージェントへ何を渡すかを整理することが重要です。
統合・出力レイヤー
複数のエージェントが出した結果を、そのままユーザーへ返せるとは限りません。
各エージェントの出力を整理し、矛盾を確認したうえで、最終的な回答や成果物としてまとめる処理が必要になる場合があります。
たとえば複数の調査エージェントから得た情報を、別のエージェントが評価・統合し、1つのレポートとして出力する構成です。
マルチエージェントでは、個々のAIの性能だけでなく、エージェント間で情報をどう受け渡し、最終結果へまとめるかが重要になります。
ベースとなるモデル選定や推論設計を理解したい場合は、LLM開発の全体像もあわせて整理しておくと役立ちます。
代表的なアーキテクチャ
マルチエージェントのアーキテクチャは、エージェント同士をどのように連携させるかによっていくつかに分けられます。
代表的な考え方として、階層型、分散型、ハイブリッド型があります。
階層型
階層型は、上位に司令塔となるエージェントを置き、その配下に専門エージェントを配置する構成です。
上位エージェントがタスクを分解し、各サブエージェントへ処理を割り振り、結果を受け取ります。
責任の所在や処理フローを明確にしやすく、業務プロセスを統制しやすい点が特徴です。
一方で、上位エージェントへ判断が集中するため、その設計がボトルネックになる可能性があります。
分散型
分散型は、中央の強い司令塔を置かず、複数のエージェントが相互に連携しながら処理を進める構成です。
状況に応じてエージェント同士が情報交換したり、次の処理を決めたりするため、柔軟性や自律性を高めやすい特徴があります。
一方で、処理経路が複雑になりやすく、終了条件の管理、デバッグ、障害時の原因特定などが難しくなる場合があります。
ハイブリッド型
ハイブリッド型は、中央制御を持ちながら、一部の処理ではエージェント同士が自律的にやり取りする構成です。
たとえば全体の業務フローはオーケストレーターが管理しつつ、情報収集やレビューの一部だけを複数エージェントへ任せる方法があります。
中央制御による管理のしやすさと、複数エージェントによる柔軟な処理を組み合わせられる点が特徴です。
実務では、最初から複雑な分散型を目指すのではなく、処理経路を把握しやすい構成から検証することが重要です。
マルチエージェントの構築アプローチ
マルチエージェントの構築方法は、大きく分けると自作、フレームワーク活用、既存ツール利用の3つがあります。
それぞれ自由度や開発負荷が異なるため、自社の技術力や要件に合わせて選択する必要があります。
自作するアプローチ
自作は、ワークフロー制御、役割分担、状態管理、再試行、監視などを独自に実装する方法です。
自由度が高く、既存業務や社内システムに合わせた細かな設計をしやすい一方、設計・実装・テスト・保守の負担は大きくなります。
独自の業務フローや高度な制御が必要な場合には選択肢になりますが、初期段階から全面的に自作すると開発範囲が広がりすぎる可能性があります。
フレームワークを活用するアプローチ
AIエージェント向けのフレームワークを利用すると、エージェントの定義、タスクの受け渡し、状態管理、ツール連携などを効率的に実装できます。
代表的な選択肢として、LangGraph、Microsoft Agent Framework、CrewAI、OpenAI Agents SDKなどがあります。
フレームワークによって、ワークフロー中心の設計、複数エージェントの協調、状態管理、ツール利用など得意とする領域が異なります。
そのため、知名度だけで選ぶのではなく、自社で実装したい処理フローや運用要件に合っているかを確認することが重要です。
フレームワークを使えばPoCを立ち上げやすくなる一方で、本番環境では監視、権限管理、エラー処理、既存システムとの接続などを別途設計する必要があります。
既存ツールを利用するアプローチ
既存のAIエージェント基盤やワークフローツールを利用し、ノーコード・ローコードに近い形で検証する方法もあります。
とくに、問い合わせ対応、社内ナレッジ検索、定型レポート作成など、処理フローが比較的明確な業務では導入を始めやすいでしょう。
一方で、細かなオーケストレーション制御、複雑な権限制御、独自システムとの深い連携などが必要になると、既存ツールだけでは対応しにくくなる場合があります。
構築を進めるときは、AIエージェント構築の基本手順とあわせて、役割分担をどこまで細かくするかを先に決めておくと整理しやすくなります。
導入は小さく始めるのが基本
どのアプローチを選ぶ場合でも、いきなり大規模なマルチエージェントを構築する必要はありません。
まずは1つの業務を対象に、2〜3程度の役割へ分けて検証し、シングルエージェントと比べて品質や業務効率が改善するかを確認する方法があります。
マルチエージェントでは、エージェントの数を増やすことよりも、どの責務を分けると価値が生まれるかを見極めることが重要です。
マルチエージェントを導入するメリット
マルチエージェントの利点は、単にAIの数を増やせることではなく、複雑な業務を役割単位へ分解できることにあります。
代表的なメリットは次のとおりです。
- 複雑なタスクを複数の工程へ分解できる
- 役割ごとに専門性を持たせやすい
- 工程ごとに品質を評価・改善しやすい
- 異なるツールやデータソースを使い分けやすい
- 機能追加や業務範囲の拡張に対応しやすい
複雑な業務では、情報収集、判断、出力整形などをすべて1つのエージェントへ任せると、どの工程で問題が発生したのか分かりにくくなることがあります。
役割を分ければ、検索エージェントだけを改善する、レビュー工程だけモデルを変更する、といった調整がしやすくなります。
また、役割によって異なるモデルやツールを使い分けられる点も特徴です。
高度な推論が必要な工程には高性能なモデルを使い、単純な分類や整形には軽量なモデルを使うなど、処理内容に応じて構成を変えることもできます。
さらに、対象業務が広がった際に、新しい役割を追加する形で拡張できる場合があります。
具体的なAIエージェントの利用場面については、AIエージェント活用事例もあわせて確認するとイメージしやすくなるでしょう。
役割分担に明確な目的があり、各エージェントの責務と連携ルールを定義できることが、マルチエージェントのメリットを引き出す前提です。
運用上の課題と注意点
マルチエージェントは複雑な業務を分担できる一方で、シングルエージェントより設計や運用が複雑になりやすい仕組みです。
導入前には、次のような課題を確認しておく必要があります。
- エージェント数の増加による設計の複雑化
- エージェント間通信による処理遅延
- LLM API利用量の増加
- コンテキスト共有や状態管理の難しさ
- テストと障害切り分けの複雑化
- 権限管理やセキュリティ設計の難化
まず注意したいのは、エージェントを増やせば増やすほど性能が高くなるわけではないことです。
数が増えるほど、情報の受け渡し、失敗時の再試行、状態管理、監視対象なども増えていきます。
その結果、役割分担によって得られるメリットより、システムの複雑さが上回る可能性があります。
処理速度にも注意が必要です。
複数のエージェントが順番にLLMを呼び出したり、相互にやり取りしたりすると、シングルエージェントより回答までの時間が長くなる場合があります。
リアルタイム性が求められる業務では、すべての工程をエージェント化するのではなく、固定ワークフローと組み合わせることも検討する必要があります。
また、複数のエージェントがLLMを呼び出す構成では、シングルエージェントよりAPI利用量が増える場合があります。
エージェント数だけを見るのではなく、各処理で使用するモデル、呼び出し回数、入力・出力トークン量、再試行回数などを含めてコストを設計することが重要です。
セキュリティ面では、エージェントごとに必要な権限を整理する必要があります。
メール送信、データベース更新、ファイル操作などの実行権限をすべてのエージェントへ与えると、誤動作した際の影響範囲が大きくなる可能性があります。
そのため、必要最小限の権限を付与し、重要な処理には人による承認を挟むなどの設計が求められます。
マルチエージェントでは「正常に動くか」だけでなく、「失敗したときにどこで止まり、原因を追跡できるか」まで設計しておくことが重要です。
マルチエージェントの主な活用例
マルチエージェントは、複数の工程や専門的な判断が連続する業務と相性があります。
ここでは、具体的な活用イメージを紹介します。
問い合わせ対応・カスタマーサポート
問い合わせ対応では、問い合わせ内容の分類、顧客情報の確認、社内ナレッジの検索、回答案の作成、内容のチェックなど、複数の工程が発生します。
これらを役割ごとのエージェントへ分担することで、複雑な問い合わせ処理を段階的に進める構成が考えられます。
たとえば、分類エージェントが問い合わせの種類を判定し、検索エージェントが必要な社内情報を取得し、回答生成エージェントが文章を作成し、最後にレビューエージェントが内容を確認する流れです。
市場調査・リサーチ
市場調査では、情報収集、情報の整理、比較、分析、レポート作成など複数の作業が必要です。
情報収集を担当するエージェント、取得した情報を評価するエージェント、分析を担当するエージェント、レポートを作成するエージェントなどに役割を分ける方法があります。
複数の観点から調査する場合には、業界動向、競合、顧客ニーズなどを別々のエージェントへ調査させ、最後に結果を統合する構成も考えられます。
ソフトウェア開発
ソフトウェア開発でも、要件整理、設計、コード生成、レビュー、テストなどを役割ごとに分けるマルチエージェント構成が考えられます。
たとえば、実装を担当するエージェントとは別に、コードレビューやテストを担当するエージェントを配置する方法です。
ただし、生成されたコードをそのまま本番環境へ反映するのではなく、人によるレビューやテストを含めた運用設計が重要になります。
社内ナレッジ活用
社内ナレッジ活用では、ユーザーの質問を分析するエージェント、必要な情報を検索するエージェント、複数資料の内容を整理するエージェント、最終回答を作るエージェントなどに分担できます。
情報源や業務領域が複数に分かれている企業では、営業資料、人事規程、技術文書などを担当するエージェントを分ける構成も考えられます。
RAGと組み合わせることで、社内データを参照しながら複数のエージェントが協調する仕組みへ発展させることも可能です。
マルチエージェントが向いているケース
マルチエージェントは、あらゆる業務で採用すべき構成ではありません。
具体的な活用例を踏まえたうえで、自社の業務を複数の役割へ分ける意味があるかを判断することが重要です。
複数工程をまたぐ業務
問い合わせ内容の分類、関連文書の検索、回答方針の決定、返信文の生成、送信前チェックなど、複数の工程が連続する業務はマルチエージェントと相性があります。
各工程を分けることで、それぞれの処理を個別に評価・改善しやすくなります。
専門性の異なる処理を組み合わせたい業務
異なる専門知識やツールを必要とする処理が組み合わさる業務でも、役割分担が有効な場合があります。
たとえば、情報検索、データ分析、文章作成、レビューなど、性質の異なる処理を別々のエージェントへ担当させる方法です。
処理ごとに異なるモデルやツールを使いたい業務
すべての処理に同じAIモデルを使う必要がない場合も、マルチエージェントを検討できます。
複雑な推論には高性能なモデル、単純な分類には軽量なモデル、社内情報検索にはRAGといったように、役割ごとに適した仕組みを組み合わせられます。
将来的な拡張を見込む業務
はじめは小さく導入し、後から対象業務や機能を広げる予定がある場合は、役割を分割できる構造にしておく意味があります。
既存の処理を大きく変更せず、新しいエージェントやツールを追加できる構成であれば、段階的な拡張もしやすくなります。
逆にマルチエージェントが向いていないケース
一問一答で完結するFAQ、単純な文章要約、定型入力から定型出力を返す処理などでは、シングルエージェントや通常のワークフローで十分な場合があります。
また、処理速度が最優先される業務では、複数エージェントによるやり取りが遅延の原因になる可能性があります。
「複数のエージェントを使えるか」ではなく、「複数の役割へ分けることで品質や運用性が改善するか」で判断することが重要です。
マルチエージェントに関するFAQ
Q.1 マルチエージェントとRAGの違いは何ですか?
マルチエージェントは、複数のエージェントが役割分担して協調するシステム構成です。一方、RAGは外部の情報を検索し、その情報を生成処理に利用する仕組みです。
両者は競合するものではなく、検索を担当するエージェントがRAGを利用するなど、組み合わせて構築することもできます。
Q.2 フレームワークなしでも構築できますか?
はい。API呼び出し、状態管理、メッセージの受け渡し、再試行処理などを自前で実装すれば、特定のフレームワークを使わずに構築することもできます。
ただし、本番運用まで考えると実装範囲が広くなりやすいため、まずは小さな構成で検証し、必要に応じてフレームワークや既存基盤を利用する方法があります。
Q.3 個人開発でもマルチエージェントを使う意味はありますか?
目的によってはあります。複数工程の自動化を試したり、マルチエージェントの設計を学習したりする用途では有効です。
ただし、単純なツールを作るだけならシングルエージェントの方が実装・保守ともに簡単な場合が多いため、役割を分ける必要性があるかを先に検討するとよいでしょう。
Q.4 どのようなスキルが必要ですか?
基本的には、LLM APIの利用、プロンプト設計、ログ確認、ワークフロー設計などの知識が必要です。
実運用まで進める場合は、外部システム連携、権限管理、状態管理、監視、評価設計、障害対応など、一般的なシステム開発・運用に近い知識も求められます。
Q.5 今から自作を始めるべきですか?
要件がまだ曖昧な段階で、全面的な自作から始める必要はありません。
まずは小さなPoCで役割分担の有効性を確認し、シングルエージェントと比較しながら、どの工程を分けると価値が出るのかを見極める方法があります。
その結果をもとに、自作、フレームワーク、既存ツールのどれが適しているかを判断すると、過剰な複雑化を避けやすくなります。
マルチエージェント導入を見極めよう
マルチエージェントを理解するうえで重要なのは、「複数のAIを使うこと」ではなく、役割分担によって複雑な業務を扱いやすくする設計だと捉えることです。
単純な処理ならシングルエージェントの方が適している場合もあり、構造の新しさだけで選ぶべきではありません。
実際には、階層型、分散型、ハイブリッド型といった構成があり、さらに自作、フレームワーク活用、既存ツール利用といった構築アプローチによって、必要な技術力や運用負荷も変わります。
検討時には、どの業務を分解するのか、各エージェントの責務をどう定義するのか、情報をどのように受け渡すのか、失敗時に原因を追跡できるかを確認したいところです。
まずは対象業務の流れを整理し、シングルエージェントで十分なのか、複数の役割へ分ける価値があるのかを見極めたうえで、小さなPoCから検証すると判断しやすくなります。
自社だけで設計や検証を進めるのが難しい場合は、AI導入やAIエージェント構築に詳しい専門家へ相談する方法もあります。
要件整理、役割設計、PoC、外部システム連携、運用監視まで含めて支援を受けることで、自社に必要なマルチエージェント構成を整理しやすくなるでしょう。
エラビサキでは、AIエージェント関連の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。