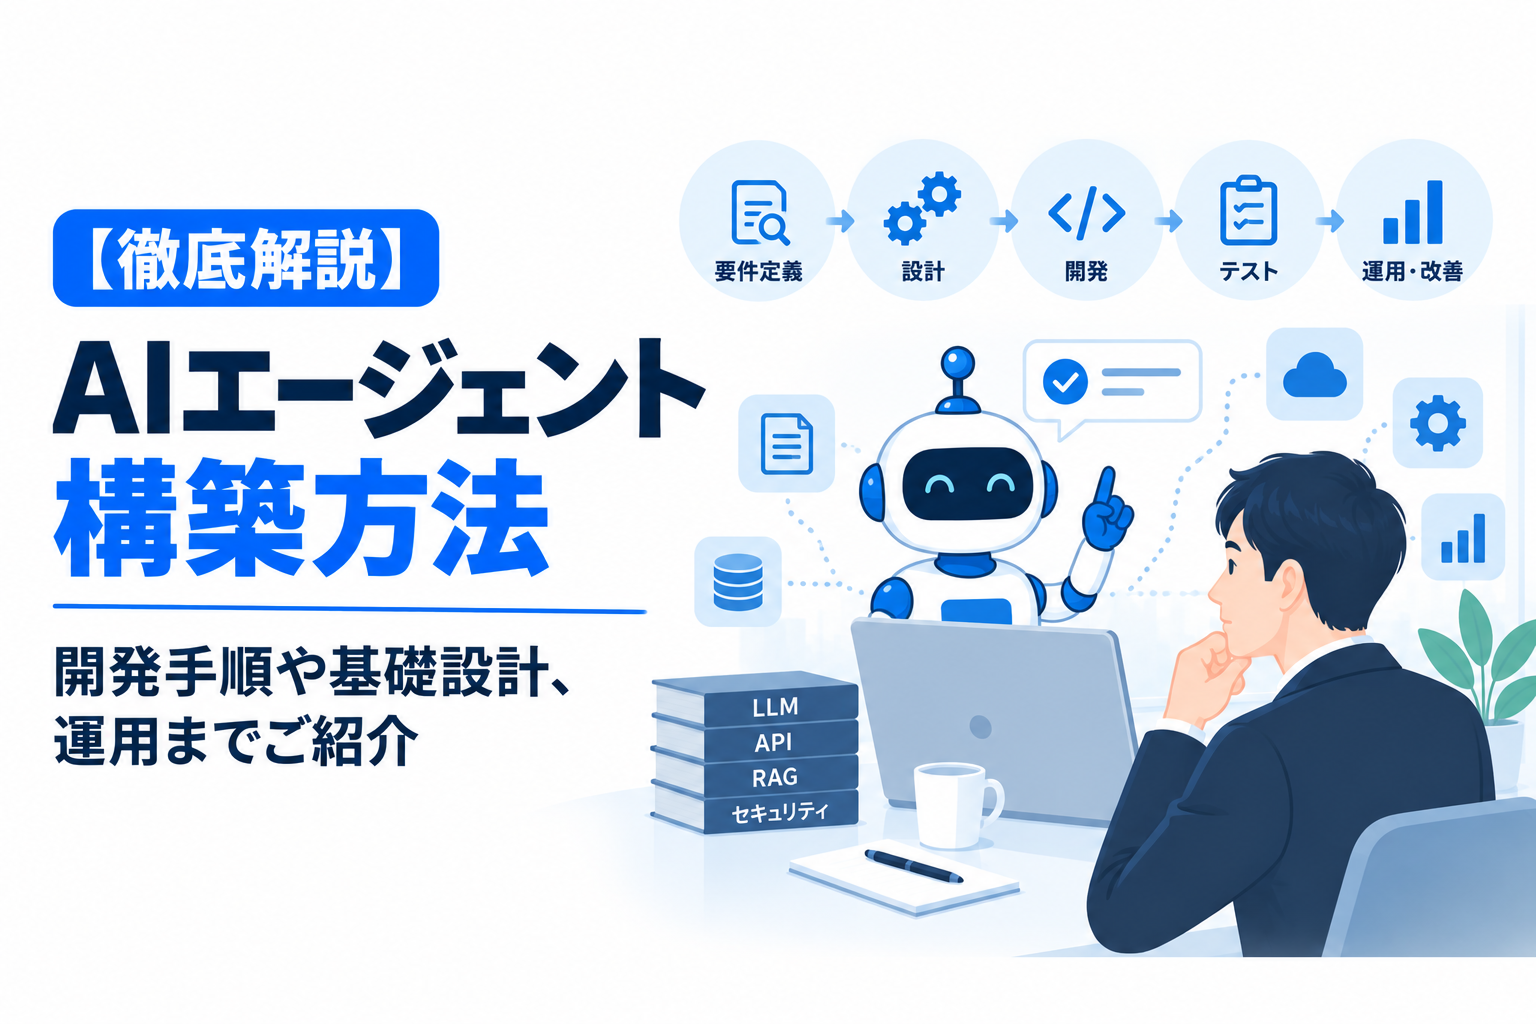
【徹底解説】AIエージェント構築方法|開発手順や基礎設計、運用までご紹介
AIエージェントの構築を検討するときは、単に「生成AIを使えば自動化できる」と考えるだけでは不十分です。
実際には、どの業務を対象にするのか、どこまで自律的に動かすのか、社内データや外部ツールとどうつなぐのかによって、設計も実装方法も大きく変わります。
また、「ノーコードで作れるのか」「どの段階からフルコード開発が必要になるのか」「本番運用では何に気をつけるべきか」といった疑問を持つ担当者も多いはずです。
そこで、こちらの記事では、AIエージェントの定義や仕組みから、構築前の整理事項、設計パターン、具体的な構築手順、テスト、運用、セキュリティまでを一通り整理します。
これからPoCを始めたい企業担当者にも、すでに検証を進めていて実装や運用の勘所を押さえたい方にも役立つよう、実務目線でわかりやすく解説していきます。
AIエージェントとは?
AIエージェントとは、与えられた指示に対して単に文章を生成するだけでなく、目的達成のために必要な手順を考え、必要に応じて外部ツールやデータを利用しながら処理を進める仕組みのことです。
一般的なチャットAIが「質問に答える」ことを中心とするのに対し、AIエージェントは「タスクを遂行する」ことに重心があります。
たとえば、問い合わせ内容を読み取り、関連資料を検索し、回答案を作成し、必要なら社内システムに登録するといった一連の流れを扱えるようになります。
つまりAIエージェントは、LLMを中心にしつつも、記憶、判断、ツール実行、情報取得といった要素を組み合わせて動くものだと理解するとわかりやすいでしょう。
重要なのは、AIエージェントは「賢いチャットボット」ではなく、「目的に沿って行動できる業務実行基盤」であることです。
なお、基盤となるモデル選定や推論設計の考え方を深掘りしたい場合は、LLM開発の全体像を整理した記事もあわせて確認しておくと、エージェント設計とのつながりを理解しやすくなります。
AIエージェントの仕組みと構成要素
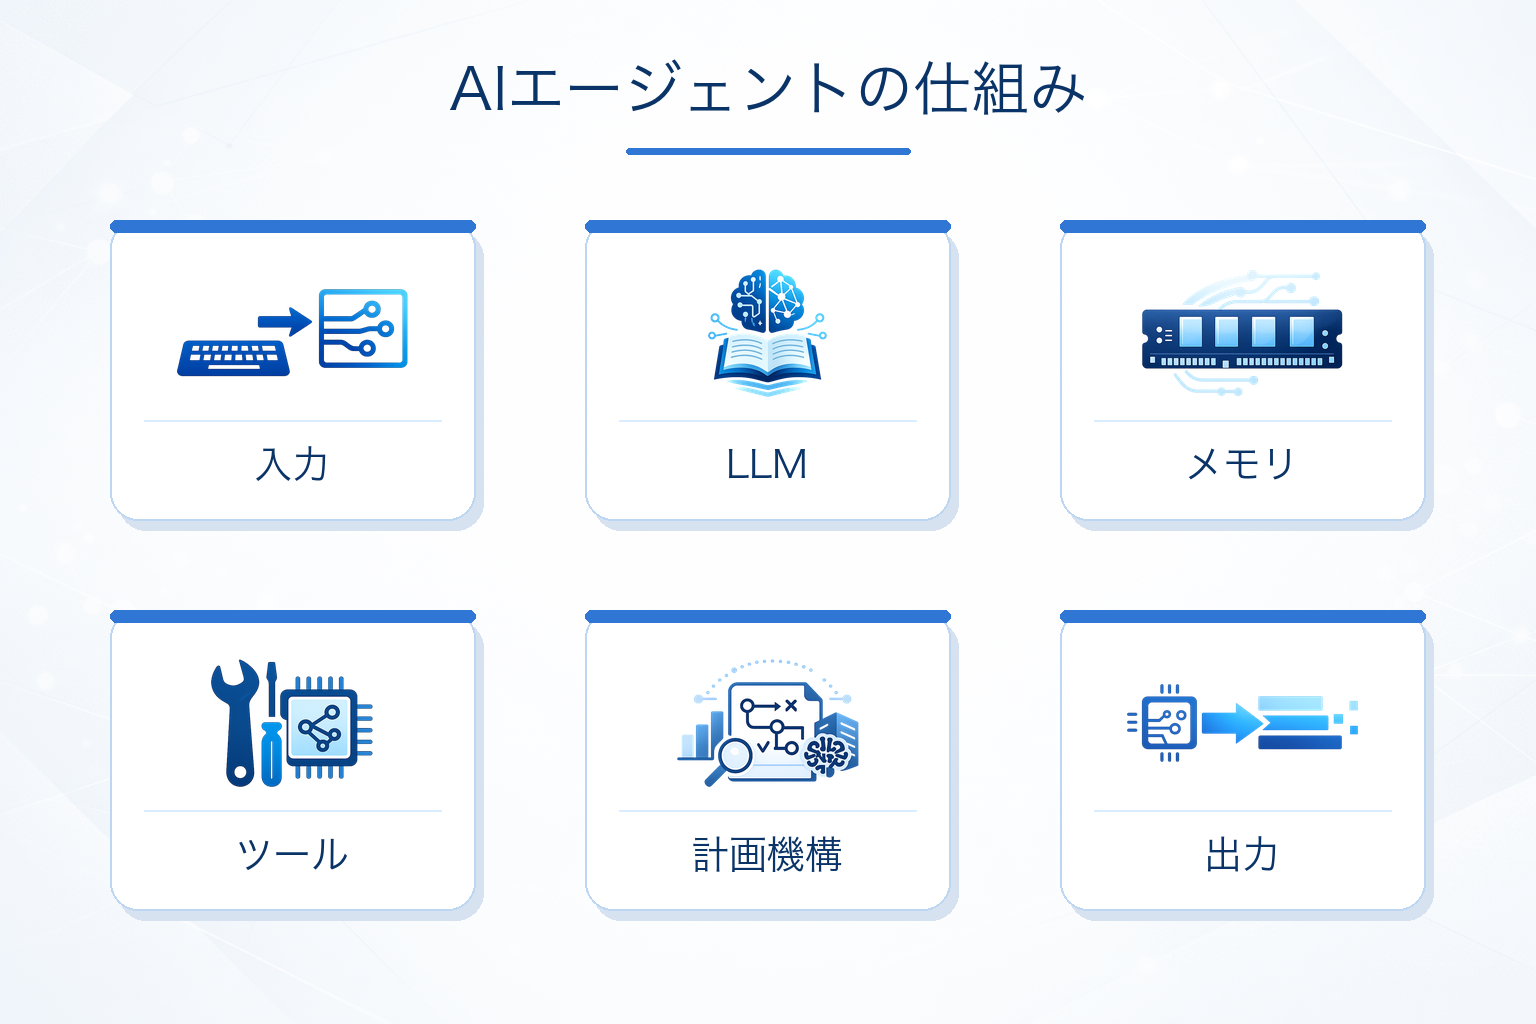
AIエージェントは、1つのモデルだけで完結するものではありません。
実務で使うには、入力を理解する部分、計画を立てる部分、必要な情報を取りに行く部分、実行結果を保持する部分など、複数の構成要素を連携させる必要があります。
中心になるのはLLM
AIエージェントの中核には、多くの場合LLMがあります。
LLMは自然言語を理解し、次に何をすべきかを推論し、外部ツールの利用指示や回答文の生成を担います。
ただし、LLM単体では最新情報へのアクセスや社内データの参照、業務システムの更新はできません。
そのため、エージェント化するには周辺機能の設計が欠かせません。
メモリは文脈維持と継続処理に必要
メモリは、会話履歴や途中経過、ユーザーの条件、処理結果などを保持するための仕組みです。
短期的な情報保持では、その場の会話履歴やタスクの途中状態などを管理します。
一方、継続的な情報保持が必要な場合は、ユーザーごとの設定や過去の処理結果などを外部ストレージに保存し、必要に応じて参照する仕組みを設けます。
なお、社内規程や商品情報などの業務知識は、すべてをメモリに持たせるのではなく、RAGなどの外部ナレッジ基盤から取得する設計も一般的です。
何を会話状態として保持し、何を外部ナレッジから取得するかを分けて設計することが重要です。
ツール連携で行動できるようになる
AIエージェントが業務で価値を発揮するのは、外部ツールを呼び出せるときです。
たとえば、Slackへの通知、CRMの更新、社内FAQ検索、カレンダー登録、メール送信などを実行できれば、単なる応答から実務支援へと役割が広がります。
逆に言えば、どのツールに何の権限で接続するかを決めないまま構築すると、使い道の狭いエージェントになりがちです。
計画機構が複数ステップの処理を支える
複雑なタスクでは、いきなり最終回答を出すのではなく、必要なステップを分解して順番に進める仕組みが求められます。
この役割を担うのが計画機構です。
たとえば「問い合わせ分類→関連情報検索→回答案作成→承認依頼」のように、工程を組み立てながら動くことで、複数ステップの業務を処理しやすくなります。
出力は回答文だけではない
AIエージェントの出力は、テキスト回答に限りません。
業務システムへの登録、チケット発行、通知送信、レポート作成など、行動結果そのものが出力になる場合もあります。
そのため、設計時には「何を言うか」だけでなく、「何を実行するか」まで定義する必要があります。
構築前に決めるべきこと
AIエージェント構築の成否は、実装より前の整理に大きく左右されます。
ここが曖昧なままPoCに入ると、便利そうなデモはできても、本番で使える形に育ちにくくなります。
まず決めたいのは目的です。
問い合わせ対応の効率化なのか、営業支援なのか、社内ナレッジ活用なのかによって、必要な設計は変わります。
目的が広すぎると要件が膨らみやすいため、最初は1つの業務課題に絞る方が進めやすいでしょう。
次に、対象業務のスコープを定義します。
どの入力を受け付け、どこまで自動で処理し、どこから人が確認するのかを決めておくことが大切です。
AIエージェントは「全部自動化」ではなく、「どこを自動化し、どこを人が担うか」を切り分けた方が失敗しにくくなります。
また、成功基準も先に決めておきましょう。
回答精度、処理時間、一次対応率、工数削減率など、評価軸がなければPoCの良し悪しを判断できません。
構築前の要件整理を詳しく見直したい場合は、AI開発の要件定義で押さえる項目を参照すると、抜け漏れを防ぎやすくなります。
さらに、利用するデータや接続先システムも整理が必要です。
社内文書が散在している、マスタ情報が整っていない、API仕様が古いといった状態では、AIより前にデータ整備や連携設計がボトルネックになることがあります。
- 何の業務課題を解決したいのか
- どの範囲まで自動実行させるのか
- 人の承認や確認をどこに入れるのか
- 成功基準を何で測るのか
- 必要なデータや接続先は整っているか
- セキュリティや権限制御にどこまで対応するか
この整理ができていれば、ツール選定も開発方式の判断もしやすくなります。
AIエージェントの構築方法を選ぶポイント
AIエージェントの構築方法は、大きくノーコード、ローコード、フルコードに分けて考えられます。
どれが優れているかではなく、自社の目的、技術力、運用要件に合うものを選ぶことが重要です。
ノーコードが向くケース
ノーコードは、PoCを短期間で試したい場合に向いています。
画面上でフローや処理を設定できるサービスもあり、エンジニアリソースが限られていても始めやすいのが利点です。
一方で、複雑な分岐や細かな制御、大規模な独自連携では限界が出やすくなります。
ローコードが向くケース
ローコードは、基本機能は既存基盤を活用しつつ、一部をカスタマイズしたい場合に適しています。
開発スピードと柔軟性のバランスを取りやすく、PoCから段階的に機能を拡張したい場合にも選択肢になります。
ただし、利用する基盤によってカスタマイズ範囲や外部連携の自由度は異なるため、本番要件との適合性を確認する必要があります。
フルコードが向くケース
フルコードは、複雑な業務ロジックや独自要件が多いケースで有力です。
モデル制御、ツール実行、監査ログ、権限管理などを細かく設計できるため、本番利用を見据えた高度な実装に向いています。
その分、開発工数も保守負荷も大きくなりやすいため、費用対効果の見極めが必要です。
選定時に見たい判断軸
構築方法を決める際は、次の観点を整理しておくと判断しやすくなります。
- PoCを素早く回したいのか、本番運用を前提にするのか
- 社内にエンジニアや運用を担える人材がいるか
- 既存システムとの連携がどの程度必要か
- 挙動の細かな制御や監査性が必要か
- セキュリティ要件が厳しいか
- 運用後に自社で改善を続けたいか
迷ったときは、小規模なPoCで実現性を確認し、本番要件が見えてから必要な構築方式を選び直す進め方も現実的です。
AIエージェントの代表的な設計パターン
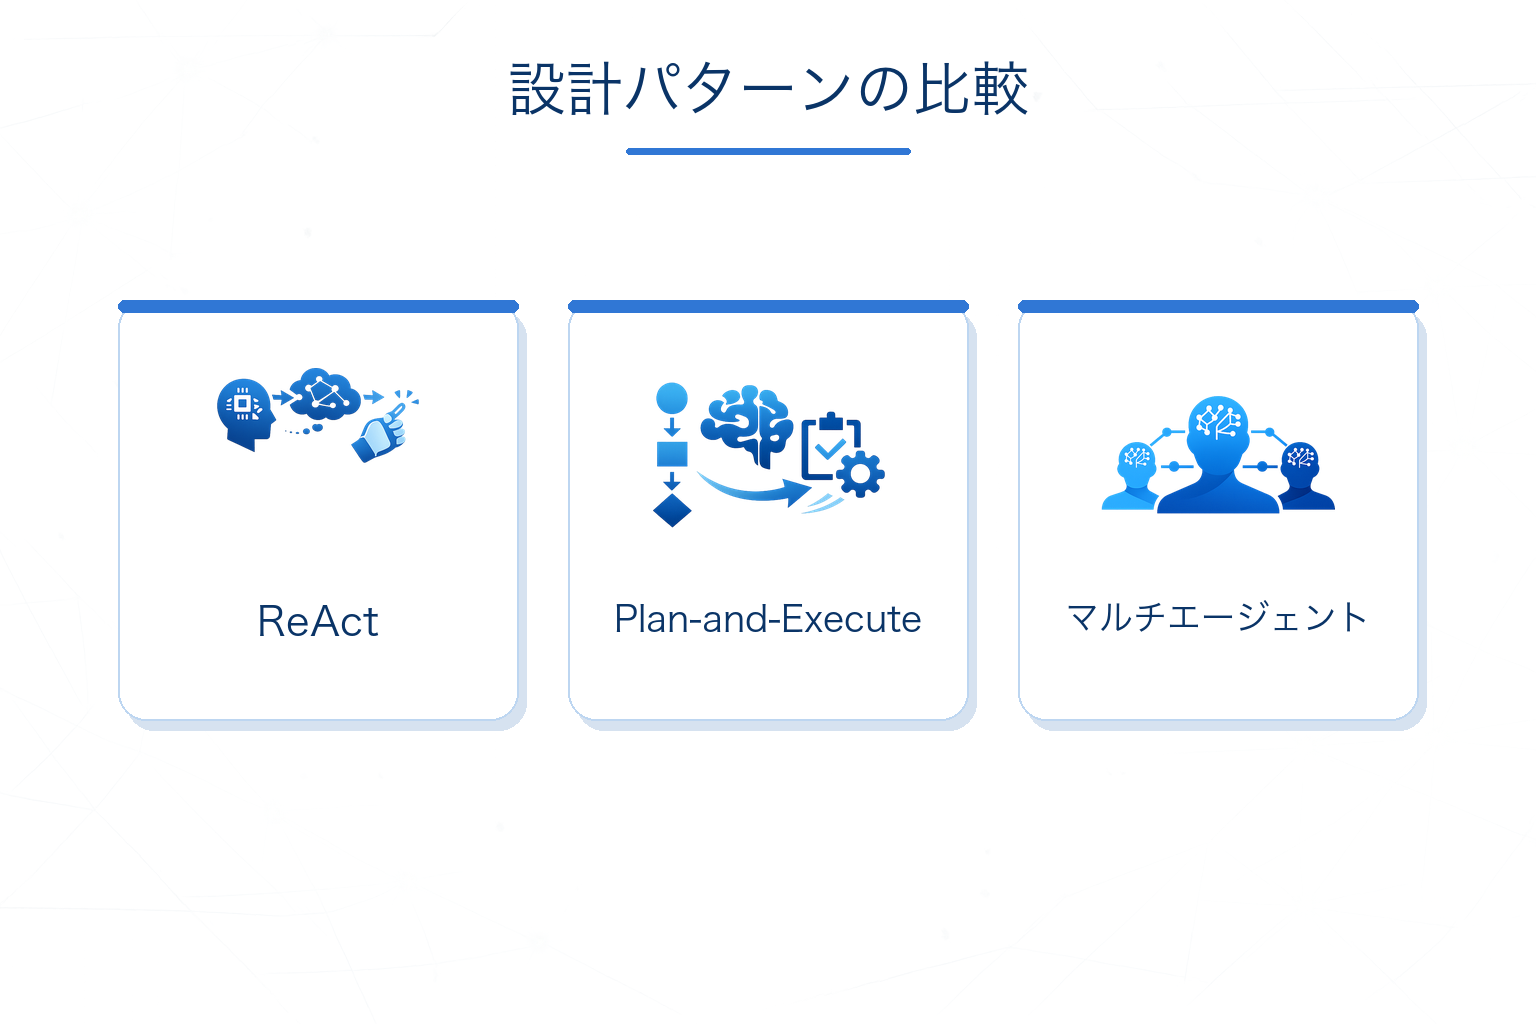
AIエージェントは、どのように判断し、どのように行動するかによって設計パターンが分かれます。
目的に合わないパターンを選ぶと、処理は複雑になるのに成果が出にくいという状態になりかねません。
ReAct型
ReAct型は、推論(Reasoning)と行動(Acting)を組み合わせ、必要に応じてツールを実行しながらタスクを進めるパターンです。
たとえば、質問に対して必要な情報を判断し、検索などのアクションを実行し、その結果を踏まえて次の処理を決めるといった流れを構成できます。
情報検索やツール利用を伴うタスクなどで活用される代表的な考え方の1つです。
Plan-and-Execute型
Plan-and-Execute型は、最初に全体計画を立て、その後に各ステップを実行していく方式です。
複数工程にまたがるタスクに向いており、処理の見通しを持ちやすいのが利点です。
ただし、計画が長くなるほど途中変更への対応やエラー処理が難しくなる場合があります。
マルチエージェント型
マルチエージェント型は、役割の異なる複数のエージェントを連携させる設計です。
たとえば、調査担当、要約担当、確認担当のように役割を分けることで、複雑なタスクを分担して処理できます。
一方で、エージェント間の連携や状態管理、エラー発生時の原因切り分けなどが複雑になりやすいため、最初から採用する必要があるかは慎重に見極めるべきです。
ワークフロー主導型
あらかじめ固定された業務フローの中で、特定の判断や文章生成だけをAIに任せる設計もあります。
これはエージェントの自律性を限定した構成ですが、処理の流れを管理しやすい点が特徴です。
とくに監査性や再現性が求められる業務では、完全自律型よりも固定ワークフローとAIを組み合わせた構成が適することがあります。
設計パターンは高度であれば良いわけではありません。
単一タスクなら単純な構成から始め、必要性が確認できてから複数ステップ化やマルチエージェント化を検討する方が、過剰設計を防ぎやすくなります。
AIエージェント構築の全体フロー
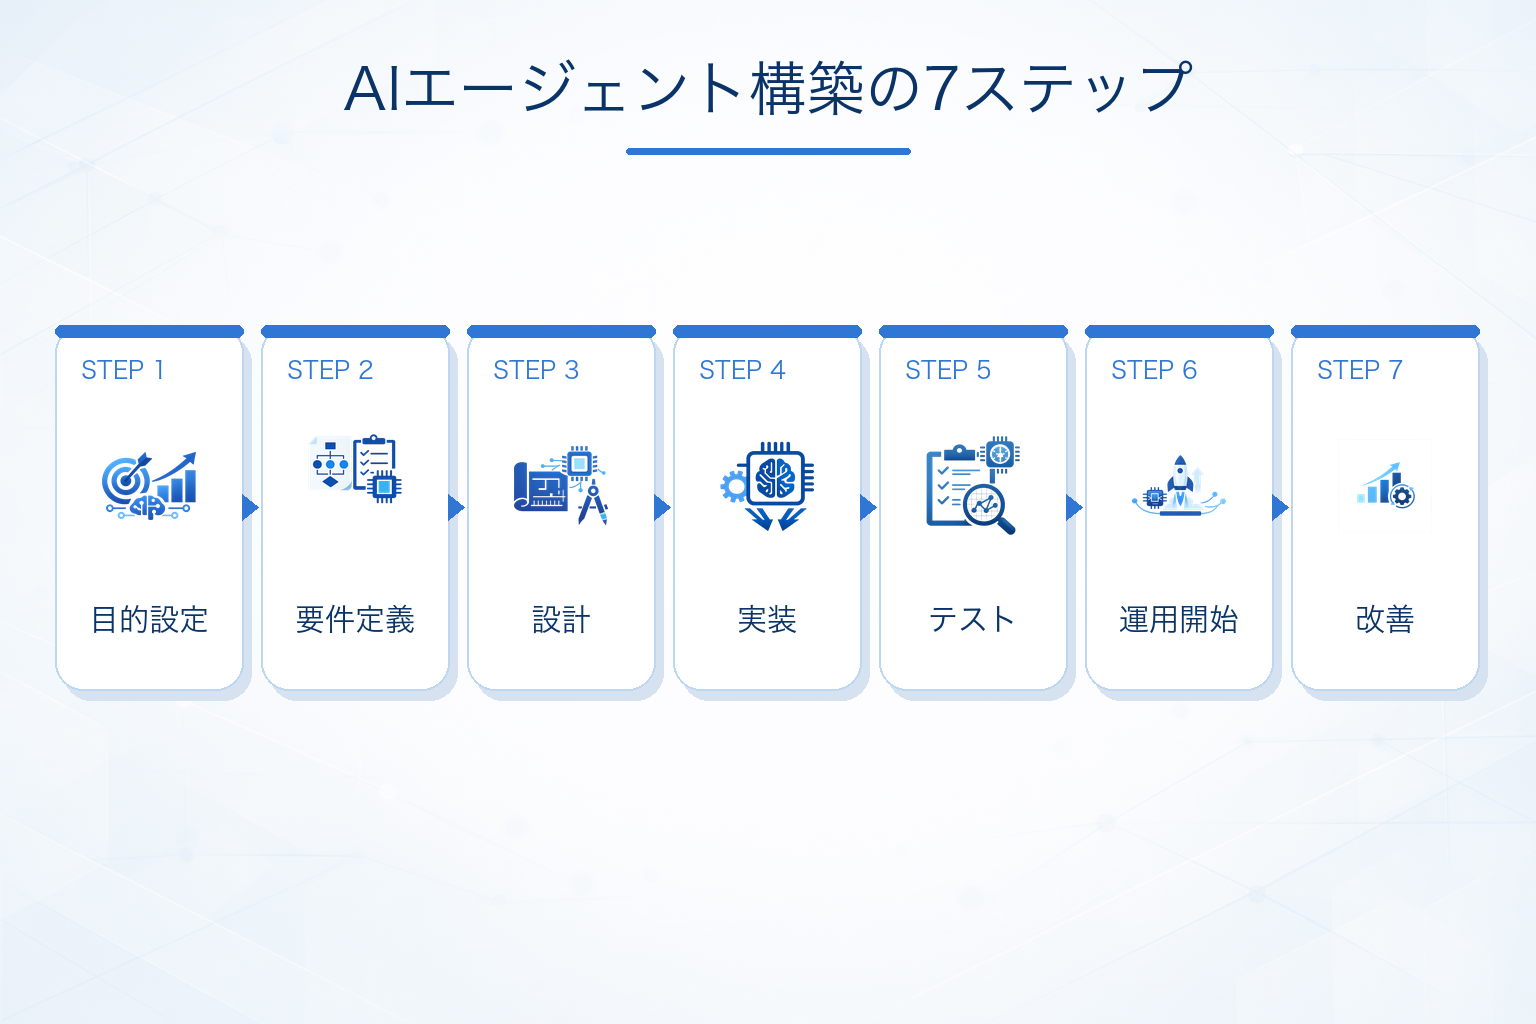
企業がAIエージェントを構築する場合は、プログラムを書くことだけでなく、要件整理から本番運用までを一連のプロジェクトとして考える必要があります。
一般的には、次のような流れで進めます。
- 目的と対象業務を整理する
- 要件と成功基準を定義する
- 構築方法と設計パターンを決める
- データ・ツール連携を設計する
- 実装してプロンプトやロジックを調整する
- テストと評価を行う
- 本番運用を開始し、継続改善する
最初の工程では、解決したい業務課題をできるだけ具体化しましょう。
「問い合わせ対応を効率化したい」だけでは広すぎるため、「一次回答にかかる時間を短縮したい」「社内マニュアル参照を効率化したい」のように絞り込むことが必要です。
次に、要件と成功基準を定義します。
この段階で、入力形式、出力形式、利用者、連携先、権限範囲、人の確認ポイントまで整理しておくと、後工程の手戻りを減らせます。
設計段階では、ノーコード・ローコード・フルコードのどれを採用するかに加え、どこまでAIに判断を任せ、どこを固定フローにするのかも決めます。
技術的に作れるかだけでなく、本番稼働後に保守・改善できる構成かまで見ておくことが大切です。
実装に入ったら、モデルの応答そのものだけでなく、例外処理や失敗時の挙動、人へのエスカレーション設計を丁寧に詰める必要があります。
コードやツールを含めた具体的な作成方法を確認したい場合は、AIエージェントの作り方を整理した記事も参考になります。
最後に、本番運用を始めた後も改善が続きます。
プロンプト修正、ナレッジ更新、ツール連携見直し、権限調整など、運用フェーズの工数を前提に計画しておきたいところです。
ツール連携とナレッジ連携の考え方
AIエージェントの実用性は、ツール連携とナレッジ連携の質で大きく変わります。
いくら自然な応答ができても、必要な情報にアクセスできず、必要な操作も実行できなければ、業務には組み込みにくいでしょう。
ツール連携は業務アクションの起点になる
ツール連携では、CRM、SFA、チャットツール、グループウェア、社内ワークフローなどとの接続を検討します。
何に接続するかだけでなく、閲覧のみなのか、更新まで許可するのか、承認後に実行するのかといった権限設計が重要です。
安易に実行権限を広げると、誤操作や情報漏えいのリスクが高まります。
ナレッジ連携ではRAGも選択肢になる
社内文書やFAQ、規程、商品資料などを参照させる場合は、RAGを組み合わせる方法があります。
RAGによって、モデルの学習データだけに依存せず、社内固有の情報を検索して回答生成に利用できるようになります。
RAGの考え方や構築の進め方を詳しく知りたい場合は、RAG構築の基礎と実務ポイントも確認しておくとよいでしょう。
データ品質が精度を左右する
ナレッジ連携で見落とされやすいのが、元データの品質です。
文書が古い、表記がばらついている、同じ内容が複数箇所にあるといった状態では、検索精度も回答品質も安定しません。
AIエージェントの精度問題に見えて、実際はナレッジ整備が原因になっていることもあります。
そのため、連携設計では次の観点を確認しておく必要があります。
- どのシステムと接続するのか
- 読み取りだけか、更新や実行まで行うのか
- 参照するナレッジの更新頻度はどうか
- 検索対象の文書構造は整っているか
- 機密情報へのアクセス制御は十分か
構築後の社内展開や現場実装まで見据えるなら、AIエージェントの導入方法を整理した記事も役立ちます。
システムプロンプト設計の要点
AIエージェントの挙動を安定させるうえで、システムプロンプトは重要な要素の1つです。
ここが曖昧だと、同じような入力でも判断がぶれたり、不要な推測をしたりしやすくなります。
役割と目的を明確にする
まず、そのエージェントが何者で、何のために動くのかを明記します。
たとえば「社内ヘルプデスクの一次対応担当」「営業日報を要約し、CRM登録候補を作る補助役」など、役割を具体化することで応答の軸が定まりやすくなります。
使ってよい情報源とツールを制限する
何を参照し、何を実行してよいのかも定義が必要です。
許可されていない情報源を使わない、確証がないときは回答を保留する、特定操作は人の承認後にだけ実行するといった制約を入れることで、想定外の動作を抑えやすくなります。
例外時の振る舞いを決める
実運用では、情報不足、検索失敗、APIエラー、権限不足などが起こります。
その際に処理を止めるのか、ユーザーへ確認するのか、人に引き継ぐのかを事前に決めておかなければなりません。
精度を高めるだけでなく、「わからないときや失敗したときにどう振る舞うか」を設計することが、本番利用では重要です。
出力形式を固定する
社内システム連携や後続処理がある場合は、出力形式もなるべく固定します。
JSONなどの構造化形式や項目別の出力を指定しておけば、後続システムで処理しやすくなります。
テストと評価の進め方
AIエージェントは、実装できた時点では完成ではありません。
むしろ重要なのは、その後にどのような観点でテストし、業務利用に耐えるかを評価することです。
まず、代表的な利用シナリオを複数用意しましょう。
正常系だけでなく、曖昧な質問、誤記を含む入力、データ不足、権限外の依頼なども含めて検証する必要があります。
評価軸としては、回答精度、根拠の妥当性、処理完了率、エスカレーションの適切さ、処理時間などが考えられます。
単に「自然な日本語で返したか」だけでは、業務品質を判断できません。
また、ツール実行を伴う場合は、誤実行リスクの評価も欠かせません。
たとえば、誤った顧客情報を更新していないか、重複登録が起きていないか、承認なしの操作が走っていないかを確認する必要があります。
- 正常系の業務シナリオで期待通りに動くか
- 曖昧な入力や情報不足時に不適切な推測をしないか
- 参照したナレッジの根拠が妥当か
- ツール実行の成功率と失敗時の処理は適切か
- 人への引き継ぎ条件が機能しているか
- 継続運用に耐える処理速度か
PoCでは完璧さを求めすぎるより、事前に設定した成功基準に対して、業務で使える水準に達しているかを確認することが重要です。
そのうえで、本番化に向けて精度改善とガバナンス整備を進める流れがよいでしょう。
運用時の注意点とセキュリティ対策
AIエージェントは、構築して終わりではありません。
本番運用に入ると、回答品質の変動、ナレッジの陳腐化、権限の見直し、利用量増加によるコスト上振れなど、運用特有の課題が出てきます。
監視とログ管理を前提にする
どの入力に対して、どの情報を参照し、どのツールを実行し、どんな結果になったのかを追える状態にしておく必要があります。
ログがなければ、不具合時の原因究明も、改善施策の優先順位付けも難しくなります。
権限を最小限にする
とくに外部ツールを操作するエージェントでは、必要最小限の権限だけを付与する設計が基本です。
閲覧専用で足りるのか、更新が必要なのか、削除操作は人の承認を必須にするのかなど、細かく分けて考えましょう。
機密情報の扱いを明確にする
顧客情報、契約情報、人事情報などを扱う場合は、どのデータをモデルに送ってよいのか、マスキングが必要か、保存期間はどうするかを明確にしなければなりません。
外部サービスを利用する場合は、データの送信先や保存条件、学習への利用有無、監査要件なども確認しておく必要があります。
コスト管理の仕組みを用意する
AIエージェントの費用は、初期構築だけでなく運用でも発生します。
LLMのAPI利用料、クラウド費用、検索基盤、監視、保守、ナレッジ更新などが継続的なコストになる可能性があります。
利用量が増えるほど従量課金が増えるサービスもあるため、利用状況とコストを継続的に確認できるようにしておきましょう。
AIエージェント構築の費用相場
AIエージェント構築の費用は、PoCだけを行うのか、1つの業務へ本格導入するのか、複数システムをまたいで自律的に処理する仕組みまで構築するのかによって大きく異なります。
2026年時点で公開されているAIエージェント開発の料金・相場情報を横断すると、小規模なPoCでは50万〜500万円程度、部門単位の個別開発では300万〜1,500万円程度、本格開発や複数システム連携では1,000万〜5,000万円以上がひとつの目安になります。
| 開発規模 | 費用の目安 | 主な内容 |
|---|---|---|
| PoC・小規模検証 | 50万〜500万円程度 | 対象業務を絞った実現可能性の検証、簡易的なツール・データ連携など |
| 部門導入・個別開発 | 300万〜1,500万円程度 | 特定業務への組み込み、RAG、外部システム連携、権限・ログ設計など |
| 本格開発・複数システム連携 | 1,000万〜5,000万円以上 | 複数業務・システムをまたぐ処理、高度な権限制御、監視、セキュリティ対応など |
| 運用・継続改善 | 月額数十万円〜 | LLM・クラウド利用料、監視、保守、データ更新、改善など |
ただし、AIエージェント開発には国内案件を同一条件で集計した公的な統一相場があるわけではなく、公開されている料金情報にも幅があります。
たとえば、小規模なPoCを50万〜300万円程度とする情報がある一方で、要件定義や評価まで含めたPoCを150万〜500万円程度とする情報もあります。
そのため、金額だけを見るのではなく、見積もりに何が含まれているかを確認することが重要です。
とくに費用を左右しやすいのは、次のような要素です。
- 対象とする業務の数と複雑さ
- AIにどこまで自律的な判断・実行を任せるか
- 連携する外部システムやAPIの数
- RAGや社内データ連携が必要か
- データ整備や前処理にどの程度の工数がかかるか
- 認証やアクセス権限をどこまで細かく設計するか
- 監査ログや人の承認フローが必要か
- セキュリティや可用性にどの程度の要件を求めるか
- 利用するLLMやクラウドの料金
- 本番稼働後の監視・改善をどこまで外注するか
とくにAIエージェントでは、単に回答を生成するだけのシステムよりも、外部システムへ書き込みや更新を行う構成のほうが、権限制御、例外処理、テスト、監視などの実装範囲が広がりやすくなります。
また、初期開発費とは別に、LLM API、クラウド、ベクトル検索などの利用料が従量課金で発生することもあります。
見積もりを比較するときは、要件定義、PoC、本番開発、RAG・データ整備、システム連携、認証・権限、テスト、監視、API利用料、運用保守のどこまでが含まれているかを確認しましょう。
AIエージェント構築では、初期開発費だけでなく、本番稼働後のAPI利用料や監視・改善費まで含めたTCOで比較することが重要です。
AIエージェント構築でよくある失敗
AIエージェント構築では、技術的な難しさ以前に、進め方の問題で失敗することがあります。
あらかじめ典型例を知っておくと、計画段階で回避しやすくなります。
目的が広すぎる
最初から全社共通アシスタントのような大きなテーマを狙うと、要件が発散しやすくなります。
まずは特定部門の明確な業務課題に絞って、成果が出る型をつくる方が現実的です。
データ整備を軽視する
社内文書の整備不足やAPI仕様の不統一を後回しにすると、AIの精度改善だけでは解決できない問題が残ります。
エージェントの品質は、参照するデータや連携先の状態にも大きく左右されます。
過剰設計になる
最初からマルチエージェントや複雑な分岐を詰め込みすぎると、検証コストが増え、原因切り分けも難しくなります。
単純な構成で目的を達成できるなら、その方が保守しやすくなります。
人の確認工程を設けない
高リスクな業務まで完全自動化しようとすると、誤回答や誤実行の影響が大きくなります。
とくに顧客対応や重要なシステム更新では、リスクに応じて人の承認を組み込む設計を検討する必要があります。
運用改善の体制がない
本番化したあとに、誰がログを見て、誰がナレッジを更新し、誰がプロンプトや処理フローを改善するのか決まっていないと、問題が発生しても改善が進みません。
AIエージェントは、構築時だけでなく継続的な評価・改善まで含めて運用体制を考えることが重要です。
よくある質問
Q.1 プログラミング知識がなくてもAIエージェントは作れますか?
簡易的なPoCであれば、ノーコードやローコードのツールを使って作れる場合があります。ただし、本番運用を前提にして外部システム連携や権限管理、監査ログ、例外処理まで整えるなら、一定の技術知識や開発体制が必要になることが多いです。
Q.2 AIエージェントとRPAの違いは何ですか?
RPAは、あらかじめ決められた手順を定型的に実行するのが得意です。一方、AIエージェントはLLMなどを利用し、入力内容や状況に応じて情報を取得したり、利用するツールや次の処理を選択したりできる点に特徴があります。定型処理はRPA、自然言語による判断や情報取得を伴う処理ではAIエージェントが候補になるなど、業務に応じて使い分けることが重要です。
Q.3 どの構築方法から始めるべきですか?
まずは対象業務の複雑さと求める自由度で判断するのが基本です。短期間で検証したいならノーコードやローコード、厳密な制御や複雑な連携が必要ならフルコードが候補になります。迷う場合は、小さく検証してから本番要件に合わせて拡張する進め方が現実的です。
Q.4 本番運用でとくに注意すべきことは何ですか?
権限管理、監査ログ、機密情報の扱い、誤実行時のフェイルセーフ設計は優先度が高い項目です。また、運用開始後にナレッジ更新やプロンプト、処理フローの改善を続ける体制も必要です。
Q.5 AIエージェントの構築費用はいくらですか?
2026年時点の公開情報をもとにすると、小規模なPoCでは50万〜500万円程度、部門単位の個別開発では300万〜1,500万円程度、本格開発や複数システム連携では1,000万〜5,000万円以上がひとつの目安です。ただし、連携するシステム数、AIに与える実行権限、RAGの有無、セキュリティ要件などによって大きく変わります。初期開発費だけでなく、LLM APIやクラウド利用料、保守・改善費も含めて比較することが大切です。
自社に合ったAIエージェント構築の進め方を見つけよう
AIエージェント構築で大切なのは、高機能な仕組みをいきなり作ることではなく、自社の業務課題に対して、どこまで自動化し、どこを人が担うかを明確にすることです。
単に最新技術を取り入れるだけでは、現場で使われる仕組みにはなりません。
AIエージェントには、ノーコード、ローコード、フルコードといった構築方法の違いがあり、さらに設計パターンや連携方式、運用体制によって向き不向きも変わります。
自社に必要なのが簡易な業務支援なのか、本格的な業務実行基盤なのかを見極めることが欠かせません。
検討時には、目的の明確化、対象業務のスコープ、データとツール連携の条件、テストと評価方法、運用時のセキュリティと改善体制を重点的に確認しましょう。
これらが曖昧なまま進めると、PoC止まりになったり、本番化しても定着しなかったりする可能性があります。
まずは小さなユースケースから始めて、成功基準を決めたうえで検証し、必要に応じて連携範囲や自律性を広げていくのが現実的です。
自社だけでAIエージェントの設計や運用まで進めるのが難しい場合は、PoC設計、RAG連携、セキュリティ設計、運用改善などに対応するAIエージェント開発会社へ相談する方法もあります。
要件定義の段階から相談することで、自社だけでは判断しにくい構築方式やシステム連携、セキュリティ要件などを整理しやすくなるでしょう。
また、見積もりや実装案を比較する際は、初期構築だけでなく、API利用量、ナレッジ更新、監視、改善工数まで含めた全体像で判断することが重要です。
そうすることで、自社に合った無理のない構築計画を立てやすくなります。
エラビサキでは、AIエージェント開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。