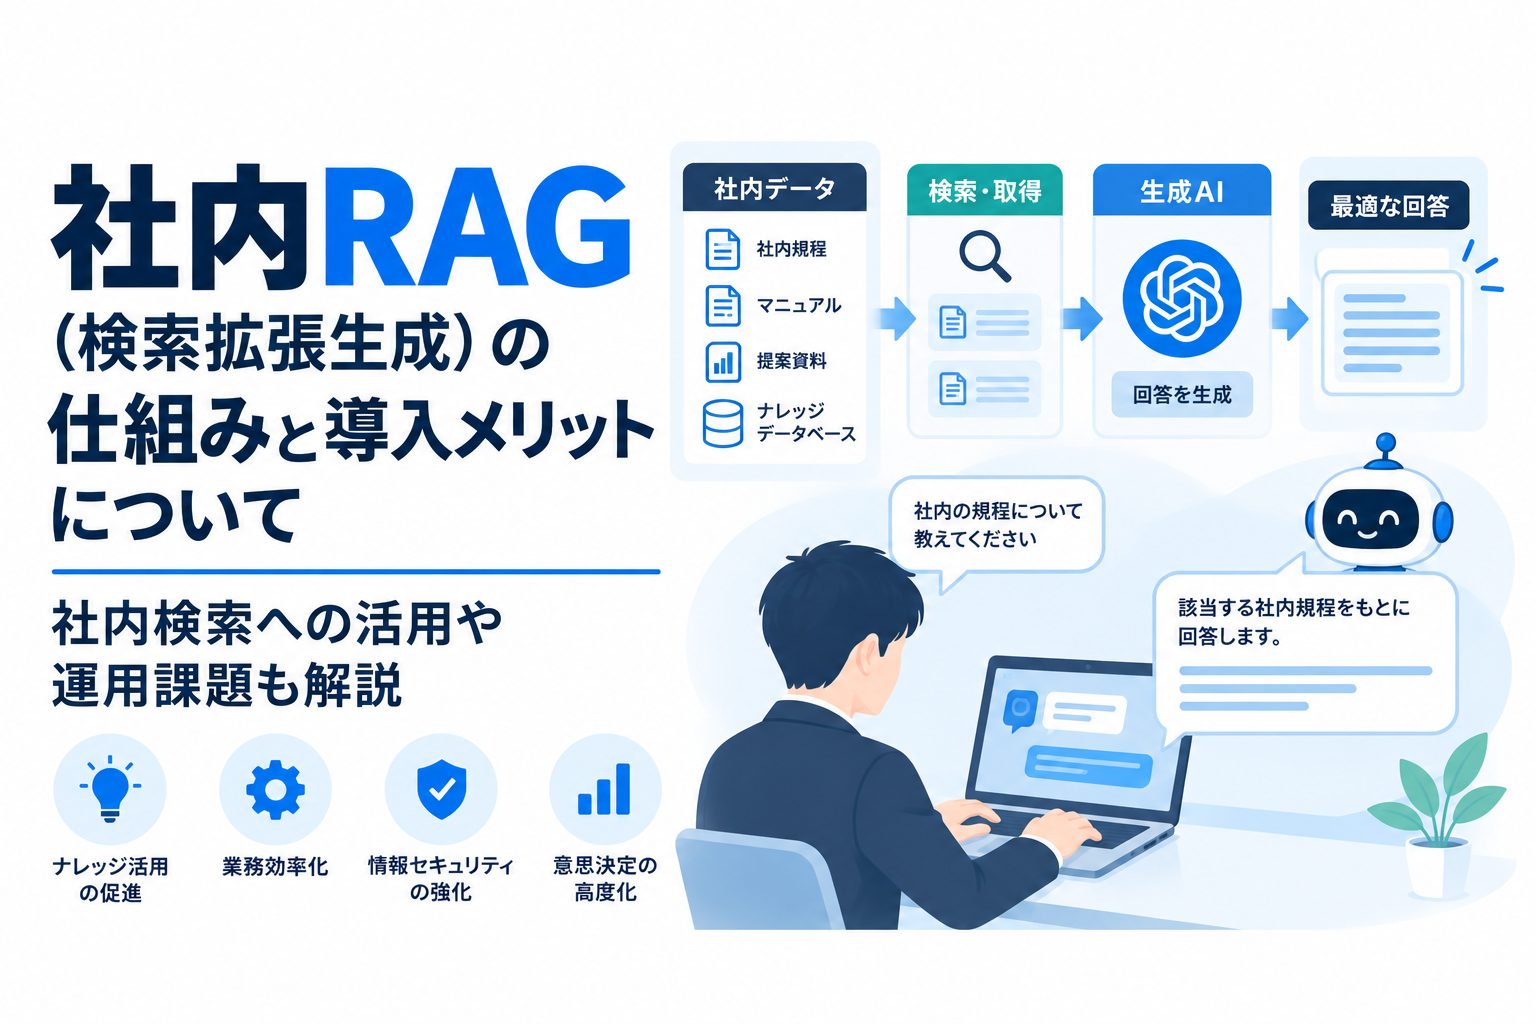
社内RAG(検索拡張生成)の仕組みと導入メリットについて|社内検索への活用や運用課題も解説
社内文書やマニュアル、FAQ、議事録といった情報は日々蓄積されますが、必要なときにすぐ見つからないという課題は多くの企業で起こりがちです。
検索しても欲しい資料にたどり着けなかったり、担当者に都度確認しないと答えが分からなかったりすると、せっかくの社内ナレッジが十分に活用されません。
そこで注目されているのが、社内データを検索しながら生成AIが回答する「社内RAG」です。
こちらの記事では、社内RAGの基本的な仕組みから、できること、導入メリット、セキュリティ対策、よくある課題、運用のコツ、費用の考え方までを整理します。
社内で安全に生成AIを活用したい方や、社内検索・社内ナレッジ活用を改善したい方は、導入前の判断材料としてぜひ参考にしてください。
社内RAGとは?
社内RAGとは、社内文書やFAQ、業務マニュアル、規程、議事録などの情報を検索し、その結果をもとに生成AIが回答を作る仕組みです。
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と呼ばれます。
通常の生成AIは、学習済みモデルの知識だけで回答するため、自社独自のルールや最新の社内情報にはそのままでは対応できません。
一方で社内RAGは、質問のたびに関連文書を参照して回答するため、社内にある一次情報を根拠にして答えやすい点が大きな特徴です。
たとえば、就業規則の確認、営業資料の参照、製品仕様書の検索、問い合わせ対応用FAQの社内利用などに向いています。
また、社内検索の延長として使える点も重要です。
単に文書一覧を返すのではなく、自然言語の質問に対して要点をまとめて答えられるため、利用者は「どの資料に何が書いてあるか」を知らなくても必要な情報へたどり着きやすくなります。
社内ナレッジ活用の全体像を広げたい場合は、RAGの活用事例もあわせて確認しておくと、導入イメージを持ちやすくなるでしょう。
社内RAGの仕組み
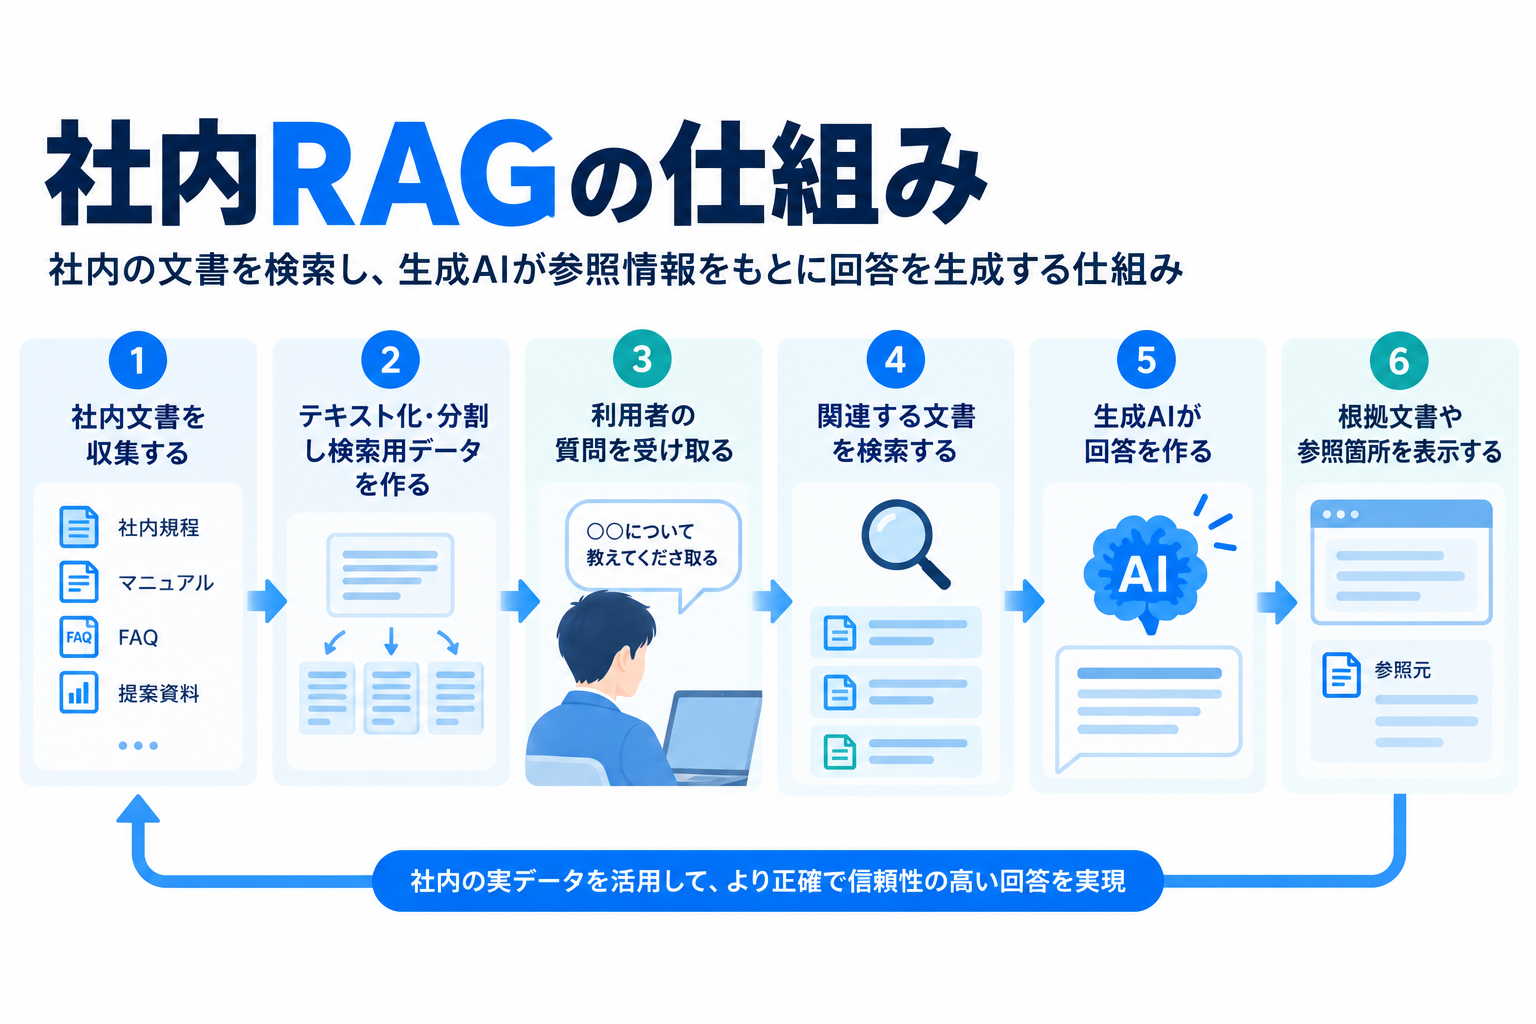
社内RAGは、大きく分けると「文書を準備する工程」と「質問に答える工程」で動きます。
まず、社内文書やFAQ、マニュアルなどを取り込み、検索しやすい形に整備します。
そのうえで、利用者が質問すると、システムが関連性の高い文書や文章の一部を検索し、その内容を参考情報として生成AIに渡します。
生成AIは、その参照情報をもとに回答を生成します。
この仕組みによって、モデルの記憶だけに頼るのではなく、社内の実データを使って答えられるようになります。
より具体的には、一般的に次の流れで処理されます。
- 対象となる社内文書を収集する
- 文書をテキスト化・分割し、検索用データを作る
- 利用者の質問を受け取る
- 質問に関連する文書を検索する
- 検索結果をもとに生成AIが回答を作る
- 必要に応じて根拠文書や参照箇所を表示する
とくに重要なのは、検索の質が回答品質に直結することです。
文書の分割方法やメタデータの付け方が不適切だと、関係ない文章が拾われたり、必要な情報が検索対象から漏れたりします。
また、社内利用では権限制御も欠かせません。
閲覧権限のない文書を参照してしまうと、便利さよりもリスクが上回ります。
社内RAGは「生成AIの精度」だけでなく、「検索基盤」「文書整備」「権限管理」がそろって初めて実用化しやすくなると考えることが大切です。
構築面をより詳しく知りたい場合は、RAG構築の考え方も参考になります。
社内RAGでできること
社内RAGの活用範囲は広く、単なるチャットボットにとどまりません。
社内に点在する情報を横断的に使えるようにすることで、検索、照会、共有、教育といった複数の業務を改善しやすくなります。
社内文書・ナレッジ検索
社内RAGの代表的な用途が、社内文書やナレッジの検索です。
たとえば「経費精算の承認期限は?」「A製品の保守対応フローは?」と自然文で質問できるため、ファイル名や保存場所を知らなくても目的の情報を探しやすくなります。
複数のフォルダや社内システムに情報が分散している企業では、必要な資料を探す時間の短縮につながります。
また、検索結果をそのまま一覧表示するだけでなく、関連文書の内容をもとに回答を生成できるため、利用者が複数ファイルを1件ずつ開いて確認する手間も減らしやすくなります。
人事・総務・情シスへの問い合わせ対応
人事、総務、情報システム部門などには、就業規則、各種申請、アカウント設定、社内ツールの使い方など、似た問い合わせが繰り返し寄せられます。
社内RAGで規程やマニュアルを参照して一次回答できれば、担当者への問い合わせ集中を減らしやすくなります。
回答とあわせて参照文書や該当箇所を表示できれば、利用者自身で根拠を確認しやすくなり、回答への納得感も高まりやすいでしょう。
判断が必要な問い合わせだけ担当者へ引き継ぐ形にすれば、定型質問への対応工数を抑えながら、例外対応へ時間を使いやすくなります。
営業・カスタマーサポートの業務支援
営業部門では、過去の提案資料、製品情報、導入事例、FAQなどを横断検索する用途に活用できます。
顧客から質問を受けた際に、社内資料を探し回るのではなく、必要な情報や回答候補を短時間で確認しやすくなります。
カスタマーサポートでは、製品マニュアルや過去の問い合わせ履歴、社内ナレッジを参照して、回答案の作成や一次対応を支援できます。
担当者ごとの経験差を補いやすくなるため、回答品質の平準化にもつながります。
オンボーディング・社内教育
新入社員や異動者向けのオンボーディングにも社内RAGを活用できます。
業務マニュアルや社内ルール、システムの使い方などを質問形式で確認できれば、教育担当者へ繰り返し質問する負担を減らしやすくなります。
また、ベテラン社員の知見が文書化されている場合は、過去のノウハウを必要なタイミングで参照できるため、属人化の緩和にも役立ちます。
ただし、社内RAGが「何でも自動化する仕組み」ではない点には注意が必要です。
曖昧な質問が多い業務や、判断基準そのものが文書化されていない業務では、十分な効果が出ないこともあります。
まずは問い合わせが多く、参照元が比較的明確な業務から始めるのが現実的です。
社内RAGを導入するメリット
社内RAGの導入には、情報検索の効率化だけでなく、業務品質の安定化という利点もあります。
とくに、社内ナレッジが増えている企業ほど効果を感じやすいでしょう。
- 必要な情報を探す時間を短縮しやすい
- 担当者への問い合わせ集中を減らしやすい
- 回答の根拠を示しやすい
- 最新文書を反映しやすい
- 属人化した知識を活用しやすい
まず大きいのは、情報探索の時間短縮です。
複数のフォルダやツールを行き来しなくても、質問ベースで必要情報へたどり着けるようになれば、日常業務の細かなロスを減らしやすくなります。
次に、問い合わせ対応の負荷軽減も期待できます。
人事、総務、法務、情報システム部門などでは、似た質問が繰り返されることが少なくありません。
社内RAGで一次回答できれば、担当者は例外対応や高度な判断が必要な相談に時間を使いやすくなります。
さらに、RAGは文書を差し替えたり更新したりすることで、新しい情報を反映しやすい点も利点です。
モデル自体を再学習しなくても参照情報を更新しやすいため、更新頻度の高い社内情報を扱う用途では、RAGが有力な選択肢になります。
一方で、導入しただけで成果が出るわけではありません。
文書整備や権限設計が不十分だと、むしろ検索ノイズが増えて使われなくなる可能性もあるため、導入前の設計が重要になります。
RAGとファインチューニングの違い
RAGとファインチューニングは混同されやすいものの、役割が異なります。
簡単に言えば、RAGは「外部の情報を検索して参照する仕組み」、ファインチューニングは「モデル自体の出力傾向や特定タスクへの適応を調整する方法」です。
| 項目 | RAG | ファインチューニング |
|---|---|---|
| 主な目的 | 外部データを参照して回答する | モデルの出力傾向や特定タスクへの適応を調整する |
| 最新情報への対応 | 文書更新で反映しやすい | 追加学習が必要になる場合がある |
| 社内文書活用 | 向いている | 知識参照そのものが主目的ではない |
| 根拠表示 | 参照文書の提示と相性がよい | 直接の根拠提示には別設計が必要 |
| 適した用途 | 社内検索、FAQ、ナレッジ参照 | 出力形式の調整、分類・抽出などの特定タスク |
社内文書や最新の社内情報を参照して回答させることが目的であれば、RAGが有力な選択肢になります。
たとえば、規程、商品情報、手順書、契約フローなどをもとに回答するケースが該当します。
一方で、特定の出力形式や応答傾向へモデルを適応させたい場合は、ファインチューニングを検討できます。
たとえば、一定のフォーマットで出力させたい、分類や抽出など特定タスクへの適応を高めたい、といった用途が考えられます。
また、RAGとファインチューニングは排他的な方法ではなく、要件によって組み合わせることも可能です。
「社内の最新情報を参照したい」のか、「モデルの出力傾向を調整したい」のかを分けて考えると、導入方法を判断しやすくなります。
社内RAGの導入でつまずきやすい課題
社内RAGは有効な仕組みですが、導入時につまずきやすい論点もはっきりしています。
とくに、生成AIそのものよりも、周辺のデータ整備や運用設計がボトルネックになりがちです。
- 参照すべき文書が整理されていない
- 古い情報や重複データが多い
- 検索精度が安定しない
- 権限制御が複雑で実装負荷が高い
- 回答精度の評価基準が曖昧
- 更新運用の担当が決まらない
まずよくあるのが、そもそも社内文書が使える状態になっていないケースです。
PDF、Word、スキャン画像、表形式データが混在しているうえ、最新版がどれか分からないと、検索対象に入れても回答品質は安定しません。
また、ハルシネーション対策のつもりでRAGを導入しても、検索結果そのものが不適切であれば、誤った根拠をもとにもっともらしい回答を返すことがあります。
つまり、RAGは万能な誤回答防止策ではなく、検索品質とデータ品質が前提になります。
さらに難しいのが権限制御です。
部門ごと、役職ごと、案件ごとに閲覧範囲が異なる企業では、検索できる文書と表示できる回答の両方を制御する必要があります。
「検索対象に入れる」と「ユーザーに見せてよい」は別問題なので、セキュリティ要件を先に整理しておきたいところです。
加えて、運用責任の所在も重要です。
誰が文書を更新し、どの部門が回答精度を確認し、改善要望をどう取り込むのかが曖昧だと、本番導入後に活用が止まりやすくなります。
社内RAGで押さえておきたいセキュリティ対策
社内RAGでは、回答精度と同じくらいセキュリティ設計が重要です。
人事情報、契約情報、顧客情報、開発資料などを扱う場合、検索対象へ登録した文書が意図しない利用者へ表示されれば、情報漏えいにつながる可能性があります。
文書ごとのアクセス権限を引き継ぐ
社内RAGでは、利用者全員が同じ文書へアクセスできるとは限りません。
人事部だけが閲覧できる資料、特定プロジェクトのメンバーだけが参照できる文書など、既存のアクセス権限をRAG側でも適切に反映する必要があります。
検索時点で閲覧権限を確認し、ユーザーが本来アクセスできない文書を検索結果や回答へ含めない構成が重要です。
入力データ・ログの保存範囲を確認する
利用者が入力した質問や生成AIの回答、参照した文書情報などがどこまで保存されるのかも確認しておきましょう。
ログは精度改善や監査に役立つ一方、機密情報や個人情報が含まれる可能性があります。
保存期間、保存先、閲覧できる担当者、削除ルールまで含めて運用方針を決める必要があります。
利用するLLM・クラウドのデータ取り扱いを確認する
外部のLLM APIやクラウドサービスを利用する場合は、入力データがどこへ送信され、どのように保存・処理されるのかを確認することが大切です。
入力内容がモデル学習やサービス改善に利用されるか、データ保持期間はどうなっているか、利用リージョンを指定できるかなど、サービスごとのデータ取り扱い条件を自社のセキュリティ基準に照らして確認しましょう。
必要に応じて、閉域ネットワークや専用環境、オンプレミス構成などを検討するケースもあります。
機密情報・個人情報を分類する
すべての社内文書を一律にRAGへ登録するのではなく、情報の重要度に応じて分類しておくことも重要です。
一般社内情報、機密情報、個人情報などに分け、RAGへ登録してよい範囲や利用部門を定義しておけば、情報管理のルールを作りやすくなります。
必要に応じて、個人情報や機密項目をマスキングしてから検索基盤へ登録する方法も検討できます。
監査ログを残せる構成にする
「誰が」「いつ」「どの情報を参照して」「どのような回答を得たか」を追跡できるようにしておくと、不正利用や誤回答が発生した際の原因確認に役立ちます。
とくに重要情報を扱う場合は、質問・回答だけでなく、参照した文書や実行した処理まで追跡できる構成が望ましいでしょう。
社内RAGでは、AIに何を答えさせるかだけでなく、「誰が、どの情報へアクセスできるか」を設計することが欠かせません。
社内RAGを成功させる運用ポイント
社内RAGを成功させるには、初期構築よりもむしろ運用の仕組みづくりが重要です。
導入直後の精度だけで判断するのではなく、継続的に改善できる状態を作る必要があります。
意識したい運用ポイントは次のとおりです。
- 対象文書の更新ルールを決める
- 回答ログと検索ログを定期的に確認する
- 利用者のフィードバックを集める
- 権限設定の変更を業務運用と連動させる
- 回答不能時の導線を用意する
まず大切なのは、対象文書の鮮度を保つことです。
就業規則や業務手順が更新されたのに検索基盤へ反映されなければ、回答の信頼性はすぐに下がります。
文書管理ルールとRAG側の更新フローを切り離さず、定期反映または更新トリガーを設計しておくべきでしょう。
次に、ログ分析も欠かせません。
どの質問で回答できなかったのか、どの文書がよく参照されているのか、誤検索はどこで起きているのかを確認すると、改善箇所が見えやすくなります。
また、現場からのフィードバックを集める仕組みも重要です。
「役に立った」「根拠が違う」「回答が古い」といった評価を収集できれば、検索改善や文書整備の優先順位をつけやすくなります。
回答品質を高めるうえでは、根拠表示も有効です。
利用者が参照元を確認できれば、誤答への気づきが早くなり、現場の安心感にもつながります。
運用設計全体を詰める際は、RAGの導入方法もあわせて見ると、PoCから本番運用までの整理がしやすくなります。
社内RAGの費用相場
社内RAGの費用は、PoCで止めるのか、部門単位で本番導入するのか、全社展開まで含めるのかによって大きく変わります。
2026年時点で公開されているRAG開発の料金情報を見ると、小規模PoCでは50万〜300万円程度、部門向けの本番導入では300万〜1,000万円程度、全社展開や大規模構築では1,000万〜3,000万円以上がひとつの目安になります。
ただし、対象文書の量や状態、権限管理、既存システムとの連携、セキュリティ要件などによって金額は大きく変動します。
| 導入規模 | 費用の目安 | 条件・補足 |
|---|---|---|
| 小規模PoC | 50万〜300万円程度 | 対象業務・文書・利用者を限定した精度検証 |
| 部門向け本番導入 | 300万〜1,000万円程度 | 認証・権限管理・ログ・文書更新などを含む構成 |
| 全社展開・大規模構築 | 1,000万〜3,000万円以上 | 複数部門・システム連携・高度な権限管理や監査対応など |
| 運用・保守 | 月額20万〜100万円程度 | API・クラウド利用、文書更新、監視、精度改善など |
| SaaS型RAGツール | 月額数万円〜 | 既製サービスを利用して小さく始める場合 |
費用が変動しやすい主な要因としては、対象データの量と品質、OCRや形式変換の有無、検索精度要件、権限管理の複雑さ、既存システムとの連携数、利用者数、API利用量などが挙げられます。
とくに社内RAGでは、生成AI部分そのものよりも、文書整備やアクセス制御、運用設計にコストがかかるケースが少なくありません。
見積もりを確認する際は、PoC費用と本番費用が分かれているか、初期費用と月額運用費が分離されているか、APIやベクトルDBの従量課金が別途発生するかを確認しましょう。
加えて、OCR、重複排除、メタデータ付与、権限管理、監査ログ、既存ツール連携が見積もりに含まれているかも重要です。
安く見える見積もりでも、データ整備や運用費が別建てだと総額は大きく変わります。
社内RAGの導入フロー
社内RAGを導入する場合は、一般的に次のような流れで進みます。
- 課題と利用目的を整理する
- 対象文書と利用部門を決める
- 権限範囲とセキュリティ要件を定義する
- PoCで検索精度と回答品質を検証する
- 運用ルールを整備する
- 本番導入し、ログを見ながら改善する
最初に整理したいのは、「何を改善したいのか」です。
社内検索の時間短縮なのか、問い合わせ削減なのか、教育支援なのかで、対象文書も評価指標も変わります。
次に、PoCの範囲設定が重要です。
最初から全社文書を対象にすると、データ整備や権限設計が重くなり、検証に時間がかかります。
そのため、まずは特定部門のFAQや手順書など、効果を測りやすい領域に絞ると進めやすくなります。
PoCでは、回答の正答率だけでなく、根拠の妥当性、回答不能時の振る舞い、権限違反が起きないかも確認する必要があります。
そして本番導入前には、更新運用、問い合わせ窓口、改善サイクルまで決めておくことが大切です。
自社だけで要件整理やPoC、本番構築まで進めるのが難しい場合は、RAG開発会社を比較した記事も参考に、必要な支援範囲に合う相談先を検討してみてください。
よくある質問
Q.1 RAGとは何ですか?
RAGは、外部データを検索してから生成AIが回答を作る仕組みです。社内RAGでは、社内文書やFAQ、マニュアルなどを参照しながら回答するため、自社固有の情報を活用しやすくなります。
Q.2 なぜ企業に社内RAGが必要なのでしょうか?
社内情報が増えるほど、必要な資料を探す時間や担当者への問い合わせ負荷が大きくなりやすいためです。社内RAGを使うことで、自然言語で必要情報へたどり着きやすくなり、ナレッジ活用や業務効率化につながります。
Q.3 RAGとファインチューニングの違いは何ですか?
RAGは外部データを検索して参照する仕組みで、ファインチューニングはモデル自体の出力傾向や特定タスクへの適応を調整する方法です。社内文書の最新情報を使いたい場合はRAGが有力で、出力形式や特定タスクへの適応を強めたい場合はファインチューニングが選択肢になります。
Q.4 社内検索でRAGを使うと何が変わりますか?
キーワード一致だけの検索に比べて、自然文の質問で情報を探しやすくなります。また、関連文書の要点をまとめて返せるため、利用者が文書を1件ずつ開いて確認する手間を減らしやすくなります。
Q.5 導入しても精度が出ない原因は何ですか?
主な原因としては、対象文書の品質不足、古い情報や重複データの混在、文書分割や検索設計の不備、質問と文書の表現差、権限制御の影響などが考えられます。生成AIだけでなく、検索基盤とデータ整備をあわせて見直すことが必要です。
Q.6 導入後にはどのような運用が必要ですか?
文書更新の反映、検索ログや回答ログの確認、利用者フィードバックの収集、権限設定の見直し、回答根拠の検証などが必要です。社内RAGは一度作って終わりではなく、改善サイクルを回しながら精度と使いやすさを高めていく運用が重要になります。
Q.7 社内RAGの導入費用はいくらですか?
2026年時点の公開情報をもとにすると、小規模PoCでは50万〜300万円程度、部門向けの本番導入では300万〜1,000万円程度、全社展開や大規模構築では1,000万〜3,000万円以上がひとつの目安です。実際の費用は、文書量、データ整備、権限管理、システム連携、セキュリティ要件などによって変わります。
社内RAGを自社に合う形で導入しよう
社内RAGを検討する際に最も重要なのは、単に「生成AIを使うこと」ではなく、自社のどの情報活用課題を解決したいのかを明確にすることです。
社内検索の改善、問い合わせ削減、ナレッジ共有の強化など、目的によって必要な設計は変わります。
また、社内RAGはAIモデルだけで成り立つものではありません。
文書整備、検索設計、権限制御、更新運用、ログ分析といった周辺要素の出来が、実用性を大きく左右します。
導入前に確認したいのは、対象文書の品質、閲覧権限の設計、PoCでの評価基準、本番後の更新運用です。
これらが曖昧なままだと、精度が安定せず、現場に定着しにくくなります。
まずは対象業務を絞って課題を整理し、小規模なPoCで検索精度や回答品質を検証してみましょう。
そのうえで、必要な連携や権限要件、運用体制を明確にしながら、本番導入の範囲を広げていく進め方が現実的です。
自社だけで文書整備、検索設計、権限管理、PoC評価まで進めるのが難しい場合は、RAG構築やAI導入支援の専門家に相談する選択肢もあります。
要件定義や費用の切り分け、運用設計を初期段階で整理できると、導入後の手戻りを減らしやすくなるでしょう。
エラビサキでは、RAG開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。