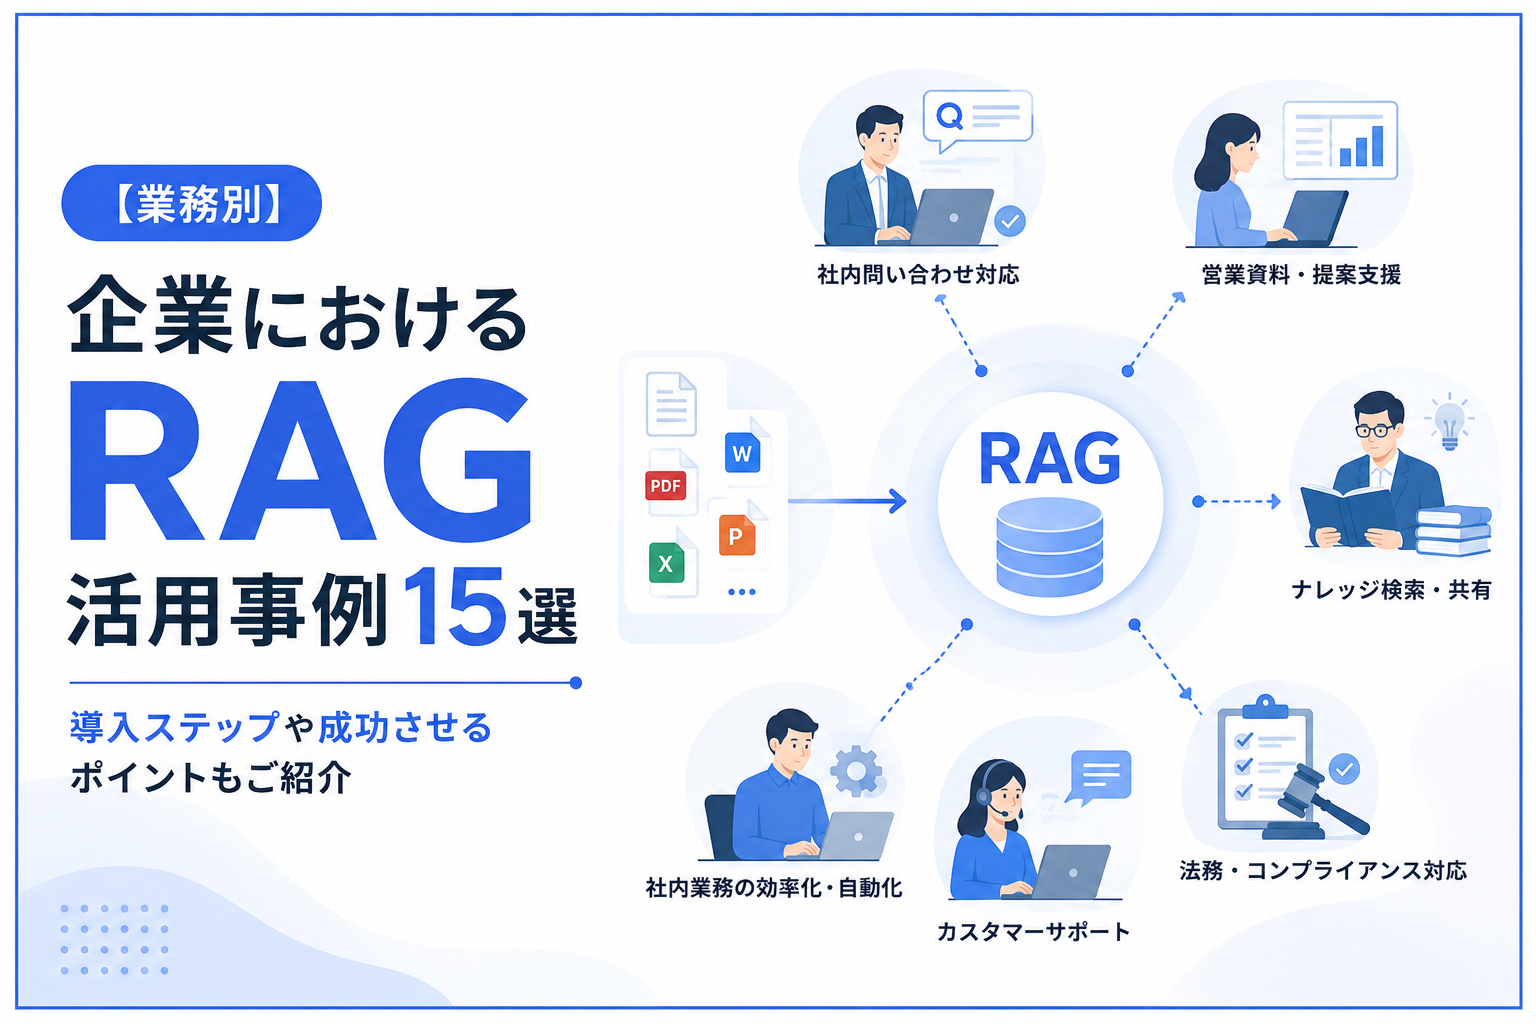
【業務別】企業におけるRAG活用事例15選|導入ステップや成功させるポイントもご紹介
RAGは、社内文書やマニュアル、規程、FAQ、過去の対応履歴などを検索し、その結果を踏まえて生成AIが回答を作る仕組みです。
そのため、単なるチャットボットよりも自社固有の情報に基づいて答えやすい点が、導入検討の中心になりやすいでしょう。
一方で、RAGは「何に使えるのか」が見えないままだと、自社への当てはめが難しくなります。
とくに知りたいのは、どの企業が、どの業務に、どんな構成で導入し、どのような成果を出したのかという具体像ではないでしょうか。
この記事では、RAGの基本や仕組みを押さえたうえで、実在企業・組織の公式情報をもとにした活用事例を業務別に整理して紹介します。
あわせて、導入の流れ、費用相場、精度を高める考え方、運用時の注意点までまとめているので、RAG導入の判断材料として役立ててください。
RAGとは
RAGは「Retrieval-Augmented Generation」の略で、日本語では検索拡張生成と呼ばれます。
生成AIが回答を作る前に、関連する外部データや社内データを検索し、その情報を参照して回答する仕組みです。
通常のLLM単体では学習済み知識の範囲に依存しますが、RAGを組み合わせると、最新の社内文書や業務マニュアル、製品資料などを根拠にした回答を返しやすくなります。
RAGの活用事例を見る意義は、単に「導入できるか」を知ることではなく、自社のどの業務なら効果が出やすいかを具体化できる点にあります。
とくに問い合わせ対応、社内ナレッジ検索、営業支援、研究開発、規制文書確認のように、文書量が多く、検索負荷が高い業務では導入イメージを持ちやすいはずです。
RAGの仕組み
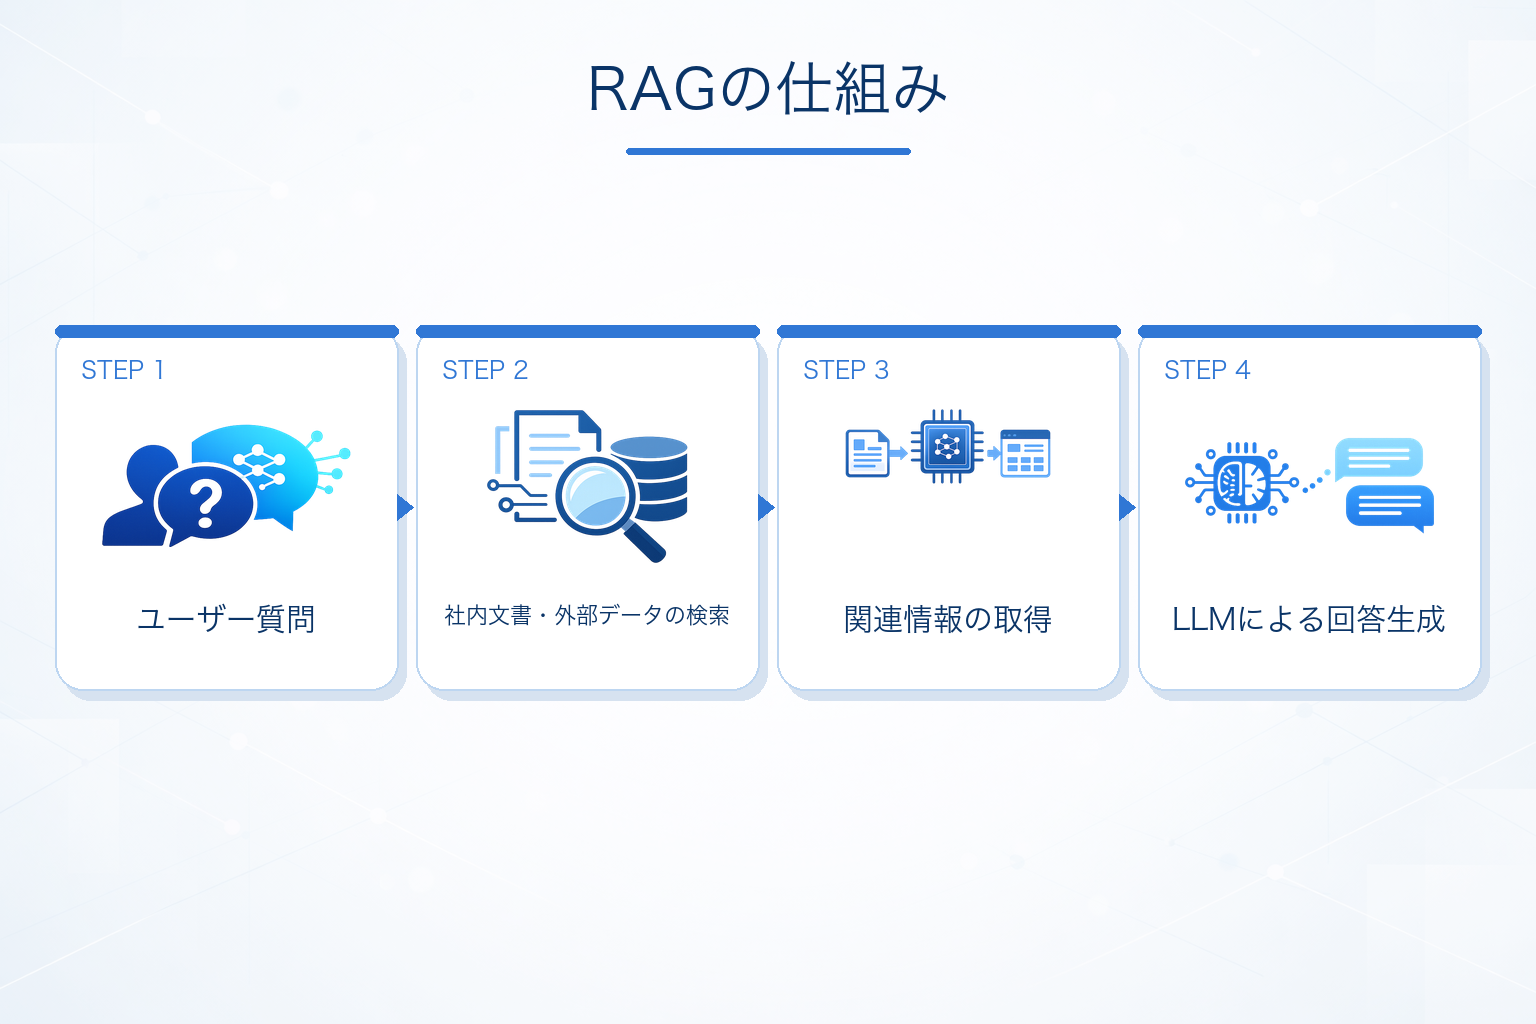
RAGの基本的な流れは、質問を受けたあとに関連文書を検索し、その検索結果をLLMへ渡して回答を生成するというものです。
たとえば「この製品の設定手順を教えてください」という質問に対して、社内マニュアルやFAQから該当箇所を探し、その内容を踏まえて回答文を作成します。
これにより、回答の根拠を業務データへ寄せやすくなり、ハルシネーションの抑制にもつながります。
ただし、RAGを入れれば自動的に精度が上がるわけではありません。
文書の分割方法、検索方式、権限管理、更新運用まで含めて設計しないと、関係ない情報を拾ったり、古い情報を参照したりする可能性があります。
RAGはどんな業務に向いている?
RAGが向いているのは、検索対象となる文書やナレッジがあり、その中から必要情報を探して回答する業務です。
逆に、参照すべきデータが整っていない業務や、正解基準が曖昧すぎる業務では、期待した効果が出にくいこともあります。
活用しやすい領域としては、次のようなものがあります。
- 社内FAQや規程、マニュアルの検索
- カスタマーサポートや問い合わせ対応
- 営業向けの商品資料・提案情報の検索
- 研究開発や技術文書の参照
- 医療・製薬・規制文書の確認
- 過去対応履歴を使うコールセンター支援
- 自治体や公共領域の固有文書検索
共通するのは、「人が文書を探して要約して答える」工程がすでに存在していることです。
その工程が重いほど、RAGの価値を出しやすくなります。
カスタマーサポート・問い合わせ対応でのRAG活用事例
中外製薬株式会社|照会対応の回答案作成で約57%の業務削減
中外製薬は、治験計画届出後の照会対応における回答案ドラフト作成にRAGを活用しています。
類似質問や類似事項を網羅的に検索し、回答案をまとめる作業に時間がかかっていたことが課題でした。
AWSの公式導入事例によると、Amazon Bedrockを中心に構築した「Chugai AI Assistant」にRAGを組み込み、社内データを参照しながら回答案を短時間で作成できるようにしています。
その結果、照会対応の回答案作成業務で約57%の業務削減を確認しています。
株式会社セゾンテクノロジー|サポート回答作成を最大30%短縮
セゾンテクノロジーは、HULFT Square向けの問い合わせ対応で、サポートエンジニアの回答案作成にRAGを導入しました。
複数サイトを横断して情報を探し、検索クエリを工夫しながら回答を作る負荷が高かったためです。
AWS公式ブログでは、Amazon Bedrock、Guardrails for Amazon Bedrockを活用し、Knowledge Bases、Amazon Kendra連携、Advanced RAGの3方式を比較検証したうえでAdvanced RAGを採用したと説明されています。
成果として、回答作成時間を最大30%短縮し、さらにAmazon Kendra活用RAG比で14%、Knowledge Bases比で22%の回答精度向上が確認されています。
株式会社JDSC|海運業向け専門問い合わせ工数を97%短縮
JDSCは、海運・海事関連業務の専門問い合わせ対応にRAGを活用しています。
専門用語を含む問い合わせに対し、必要データの収集や整理に手間がかかることが課題でした。
公式ニュースによると、Amazon Bedrock、Amazon Kendra、Amazon OpenSearch Service、Amazon RDS for PostgreSQLを組み合わせたRAG基盤を構築し、問い合わせ分析からデータ整理、提供方法の設計まで進めています。
その結果、専門的な工数を97%削減し、従来システム比で回答精度を30%向上しています。
株式会社クリエイティブ・ウェブ|コールセンターで過去対応履歴を検索して回答支援
クリエイティブ・ウェブは、コールセンターのお問い合わせ管理システムにRAG機能を組み込みました。
オペレーターが過去の対応履歴や関連情報をすばやく参照する必要があることが背景です。
AWS公式ブログによると、Amazon BedrockのRAG機能を使い、過去対応履歴を検索して回答支援に活用できる構成を実現しています。
定量成果は公開されていませんが、問い合わせ対応の再現性と検索効率の向上を狙った事例として参考になります。
株式会社メタバーズ|メタバース空間のAIコンシェルジュで文脈に沿った案内を実現
メタバーズは、メタバース空間上のAIコンシェルジュにRAGを活用しています。
複数モデルに対応する開発負荷を抑えつつ、利用者の文脈に沿った案内精度を高める必要がありました。
AWS公式ブログによると、Amazon Bedrockを利用し、テキストチャット用の言語モデルとRAG用の埋め込みモデルを使い分けるバックエンドを実装しています。
成果として、生成AIモデル対応数増加に伴う開発工数削減が示されていますが、具体数値は公開されていません。
営業・社内ナレッジ検索でのRAG活用事例
株式会社サンブリッジ|Slack連携の社内RAGで1週間累計1,750分を削減
サンブリッジは、社内問い合わせ対応と自己解決支援を目的に、Slack連携の社内向けRAGチャットボットを構築しました。
人的な問い合わせ対応負荷が高く、必要情報にたどり着くまでにも時間がかかっていたためです。
同社公式ブログでは、Amazon BedrockとAmazon Kendraを活用し、約9,000件の社内文書を登録したうえで、回答と一次情報を紐付けて提示できる仕組みを整えたと説明しています。
成果として、1週間で累計1,750分の業務時間削減、1回の質問あたり平均7分削減が公表されています。
株式会社サンエー|社内FAQ検索とデータ分析でRAG活用を推進
サンエーは、社内FAQ検索とデータ分析支援の用途でRAG活用を進めています。
生成AIの活用を一部門にとどめず、事業部門でも使える共通基盤へ広げることが課題でした。
AWSの導入事例では、Amazon BedrockやGenerative AI Use Cases JP(GenU)を用いながら、将来的なAdvanced RAGも視野に入れて社内分科会で活用を推進していることが確認できます。
定量数値は明示されていませんが、FAQ検索と分析支援をセットで進めている点が特徴です。
NTT西日本グループ|営業支援AIボットで商材情報検索を効率化
NTT西日本グループは、営業支援AIボットにRAGを組み込み、商材情報や関連マニュアルの検索を効率化しています。
営業現場で必要な情報へすぐアクセスできないことが課題でした。
AWS公式ブログでは、Amazon Bedrock Knowledge Basesを活用し、Amazon S3にナレッジ文書を格納することで、対象商材に特化した検索基盤を自動構築したと紹介されています。
回答時に関連マニュアルのページ番号も明示できるため、回答の根拠確認まで行いやすい構成です。
三協立山株式会社|生成AIアシスタントにRAGを組み込み議事録作成時間を75%削減
三協立山は、生成AIアシスタントにRAGを組み込み、議事録作成や社内情報参照に活用しています。
議事録作成に時間がかかることが大きな課題でした。
AWS公式ブログでは、Amazon Bedrock、GenU、Amazon Kendraを活用し、自社データを参照できる生成AIアシスタントを約1か月でリリースしたと紹介されています。
その結果、議事録作成時間を75%削減しています。
研究開発・技術文書でのRAG活用事例
トヨタ自動車株式会社|共有RAG基盤で研究効率と部門横断活用を推進
トヨタ自動車は、研究・開発部門での社内文書検索と知識共有のために共有RAG基盤を構築しました。
部門ごとに知見が分散し、共有利用やアクセス権限管理に課題があったことが背景です。
AWS導入事例では、AWS上にAmazon OpenSearch Serviceを用いた共有RAG基盤を整備し、社内認証システムと統合したうえで、アップロード文書ごとのアクセス権限分離も行ったと説明されています。
運用可能なRAG環境を1年足らずで構築し、開発担当部署の工数削減を実現したとされています。
日産自動車株式会社|R&D向けRAGシステムの評価基盤をAWS上で構築
日産自動車は、研究開発向けRAGシステムそのものの品質改善を進めるため、評価基盤を構築しました。
RAGを業務利用するうえでは、検索精度や回答品質を継続的に評価する仕組みが欠かせないためです。
AWS公式導入事例によると、評価対象RAGシステム、自動評価バックエンド、結果確認とQ&Aレビュー機能の3コンポーネントをAWS上に整備し、LLMによるQ&A自動作成と専門家レビューを組み合わせています。
定量成果は公開されていませんが、RAGは導入して終わりではなく、評価運用の仕組みまで作ることで実務利用しやすくなることがわかる事例です。
医療・製薬・規制文書でのRAG活用事例
中外製薬株式会社|SOP検索システムで医薬安全性業務の文書検索を高度化
中外製薬は、医薬安全性業務で使うSOPや関連文書の検索・収集業務にRAGを活用しています。
多数のSOPや関連文書から必要情報を探し、適切な手順で業務を進める負荷が高かったことが課題でした。
Google Cloudの公式顧客事例によると、Google Cloud上でRAGを用いたSOP検索システムを構築し、2024年3月頃に開始したプロトタイプ検証を経て、2024年11月からChugai AI Assistantの一機能として利用を始めています。
定量成果は公表されていませんが、製薬業界でRAGを文書検索の実務へ組み込んだ代表例の一つです。
IQVIAサービシーズ ジャパン合同会社|規制文書確認向けの社内RAGチャットをフルサーバレスで構築
IQVIAサービシーズ ジャパンは、臨床試験、市販後調査、医薬品関連文書作成時の規制文書確認にRAGを活用しています。
治験業務や規制対応では、一般公開されている規制文書の内容確認がたびたび必要になるためです。
AWS公式ブログでは、Amazon Bedrock Knowledge Bases、AWS Amplify、AWS Lambda、Amazon DynamoDBを用いたフルサーバレス構成の社内RAGチャットシステムを構築し、公開規制文書を参照しながら業務確認できるようにしたと紹介されています。
定量数値は非公開ですが、規制文書確認のような高頻度・高重要度の確認業務にRAGが適していることを示しています。
Amazon Pharmacy|医療関連ワークフローでRAGを組み合わせた安全な生成AI活用を実装
Amazon Pharmacyは、医療関連文書や業務ワークフロー支援にRAGを組み合わせています。
規制産業である医療領域では、患者プライバシーを守りながら生成AIを業務へ組み込む必要がありました。
AWS公式ブログによると、ファインチューニング済みLLMとAmazon OpenSearch Serviceを使ったRAGのハイブリッド構成を採用し、既存バックエンドと統合しながら厳格なデータガバナンスのもとでワークフローをオーケストレーションしています。
定量成果は公開されていませんが、安全性と実務性を両立させる設計の参考になります。
自治体・公共分野でのRAG活用事例
シフトプラス株式会社|自治体向け生成AIサービスにRAGを追加し固有データ検索に対応
シフトプラスは、自治体向け生成AIサービス「自治体 AI zevo」にRAGを追加しました。
自治体では一般的な生成AI利用にとどまらず、各自治体固有の文書やデータを参照したいニーズが高まっていたためです。
AWS導入事例によると、Amazon Kendraを活用し、2023年12月にRAG対応を追加して自治体固有データを検索・参照できるようにしています。
自治体業務では文書の個別性が高いため、汎用回答ではなく固有情報を引けるRAGの相性がよいことがわかります。
RAGを導入する流れ
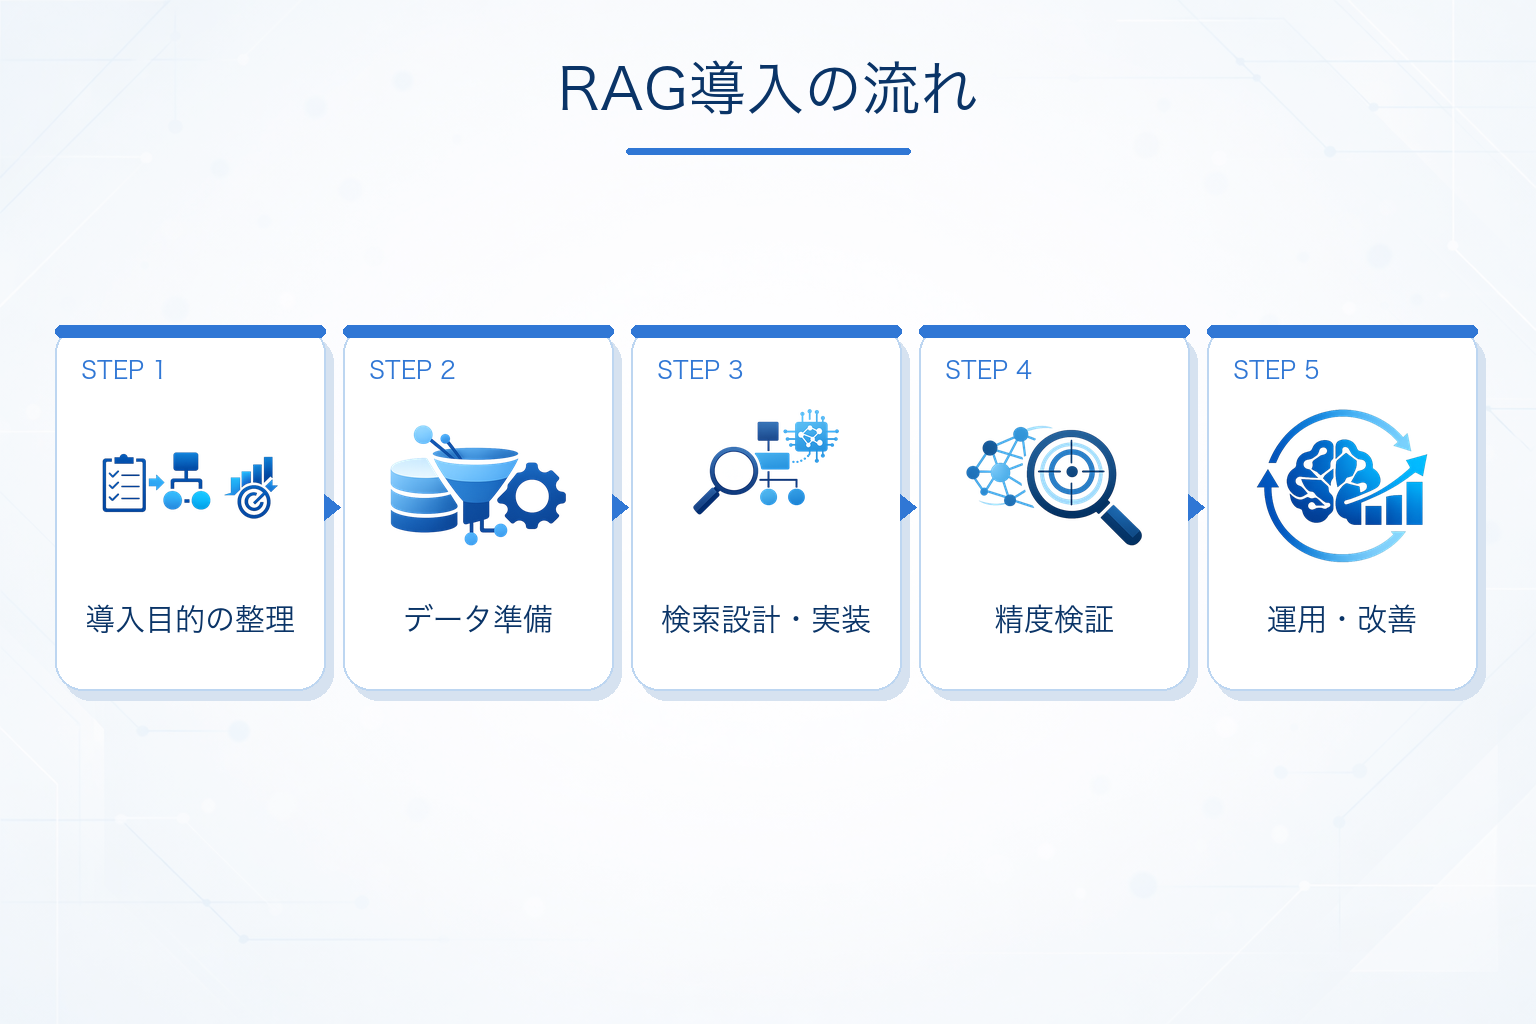
RAG導入は、一般的に次のような流れで進みます。
- 導入目的と対象業務を整理する
- 参照するデータを収集・整備する
- 検索設計と回答生成の仕組みを実装する
- 精度検証と安全性確認を行う
- 本番運用と継続改善を進める
最初に重要なのは、どの業務の何を改善したいのかを明確にすることです。
「社内問い合わせを減らしたい」「規制文書確認を速くしたい」のように対象業務を絞ると、必要なデータや評価指標も定めやすくなります。
次に、参照データの品質確認が欠かせません。
古い版の文書が混在していたり、PDFのテキスト抽出精度が低かったりすると、検索精度のボトルネックになります。
実装後は、単に動くかどうかではなく、正しい文書を引けているか、根拠を示せているか、権限外の情報を出さないかまで検証したいところです。
RAGの精度を高めるポイント
RAGの精度は、LLMの性能だけでなく、検索設計とデータ整備の影響を大きく受けます。
改善の観点は複数ありますが、とくに実務で重要なのは次の点です。
- 文書をどう分割するかというチャンク設計
- キーワード検索とベクトル検索の使い分け
- 必要に応じたハイブリッド検索の導入
- 検索結果の並び替えを行うリランキング
- 最新版だけを参照できる更新ルールの整備
- 回答時に根拠文書を表示するUI設計
たとえば、セゾンテクノロジーの事例では、Knowledge Bases、Kendra連携、Advanced RAGの3方式を比較し、精度検証のうえで方式を選んでいます。
このように、RAGは構成を試しながら評価する前提で考える方が現実的です。
また、日産自動車のように評価基盤を別途整備する考え方も有効です。
検索品質が安定しないまま全社展開すると、利用が広がるほど不信感につながるため、精度評価の仕組みづくりは後回しにしない方がよいでしょう。
RAG導入時の注意点
RAGは便利な仕組みですが、運用を誤ると情報漏えいや誤回答のリスクを招きます。
導入時には、次のような点を確認する必要があります。
- アクセス権限に応じて検索対象を分離できるか
- 古い文書や誤った文書が混入していないか
- プロンプトインジェクション対策が必要か
- 回答根拠をユーザーが確認できるか
- 監査ログや利用ログを取得できるか
- 継続的にデータ更新できる運用体制があるか
トヨタ自動車の事例では、社内認証システムとの統合や文書ごとのアクセス権限分離が行われています。
また、医療・製薬領域の事例では、規制やプライバシーへの配慮が前提になっています。
RAGは「検索して答える」仕組みである以上、検索対象データの統制がそのまま安全性に直結します。
技術選定だけでなく、文書管理ルールや更新責任者の設計もセットで考えることが大切です。
RAG活用を成功させるための判断軸
RAGを成功させるには、まず「LLMを入れたい」ではなく「どの業務の検索負荷を減らしたいか」から考えることが重要です。
検索対象が明確で、参照すべき文書があり、人がそれを探して答える業務なら、RAGの適用余地は大きくなります。
導入判断では、次の観点を整理しておくと比較しやすくなります。
- 対象業務に十分な文書データがあるか
- 文書の版管理や更新運用ができているか
- 正答率よりも検索補助で価値が出る業務か
- 権限管理や監査ログが必要な業務か
- PoCで測るべき効果指標を定義できるか
また、スモールスタートも有効です。
中外製薬や三協立山のように、業務を絞って効果を確認し、その後に共通基盤や機能拡張へ進む進め方は再現性があります。
最初から全社共通の万能検索を目指すより、成果が見えやすい領域から始めた方が、現場定着と投資判断の両面で進めやすくなるでしょう。
RAG導入にかかる費用相場
RAGの費用は、PoCなのか本番導入なのか、またSaaS利用か個別開発かによって大きく変わります。
以下は、公開情報をもとに整理した代表的な費用帯です。
| 支援内容 | 費用相場 | 条件・補足 |
|---|---|---|
| PoC | 50万〜200万円 | 小規模PoC・プロトタイプ。複数ソースで確認。 |
| 本番開発 | 300万〜1,500万円 | 標準的な本番導入。複数ソースで確認できる代表帯。 |
| 大規模開発・公開/全社展開 | 1,500万〜3,000万円以上 | 一般公開規模や大規模展開で高額化。用途差があるため条件付きで表示。 |
| SaaS型RAGツール | 月額数万〜数十万円 | 自社開発ではなくSaaS利用時。複数ソースで確認。 |
| 運用・保守 | 初期開発費の20〜30%/年 | 年間保守費の相場として複数ソースで一致。 |
金額差が大きい理由は、参照データの整備、権限管理、既存システム連携、評価基盤、監査ログ、UI設計などの要件差がそのまま費用へ反映されるためです。
見積もりを見る際は、PoC費用と本番開発費が分かれているか、初期費用と月額費用が分離されているか、従量課金の対象がLLM利用料なのか検索基盤なのかまで確認しておきましょう。
とくに、データ整備費やOCR対応、認証連携、回答根拠表示の設計が別料金になっているケースもあるため、何が見積もりに含まれているかを細かく確認する必要があります。
よくある質問
Q.1 RAGとは何ですか?
RAGは、生成AIが回答を作る前に、社内文書や外部データベースから関連情報を検索して、その内容を踏まえて回答する仕組みです。LLM単体よりも、自社固有の情報や最新情報を参照しやすい点が特徴です。
Q.2 RAGとChatGPTの違いは何ですか?
ChatGPTはLLMそのもの、またはその対話サービスを指すことが多く、必ずしも自社データを参照するわけではありません。RAGは、そのLLMに検索機能を組み合わせて、必要な文書を取りに行ってから回答する構成を指します。つまり、RAGは「モデル」ではなく「仕組み」です。
Q.3 RAGはどんな業務で使えますか?
社内FAQ、問い合わせ対応、営業支援、マニュアル検索、規制文書確認、研究開発文書の検索、コールセンター支援などで使われています。共通点は、文書を探して要約しながら答える業務であることです。
Q.4 RAG導入前に何を準備すべきですか?
まずは対象業務を絞り、何を改善したいのかを明確にすることが必要です。そのうえで、参照文書の所在、版管理、更新頻度、アクセス権限、OCRの要否などを確認すると、PoCの精度と見積もりの精度が上がりやすくなります。
Q.5 RAGで精度が出ない原因は何ですか?
原因は一つではありませんが、古い文書が混ざっている、文書分割が不適切、検索方式が業務に合っていない、権限設定の都合で必要文書を参照できない、といった要因がよくあります。LLMの変更だけでなく、検索設計とデータ整備も見直すことが大切です。
Q.6 安全に運用するには何が必要ですか?
アクセス権限の分離、回答根拠の表示、利用ログや監査ログの取得、データ更新ルールの整備が重要です。とくに機密情報や規制文書を扱う場合は、検索対象データの統制と認証連携まで含めて設計する必要があります。
自社に合ったRAG活用の進め方を見極めよう
RAG活用で重要なのは、単に最新技術を導入することではなく、どの業務で、どの文書を、どの精度で参照したいのかを明確にすることです。
実際の事例を見ても、問い合わせ対応、営業支援、研究開発、規制文書確認、議事録作成など、成果が出ている領域はそれぞれ異なります。
また、企業ごとに必要な設計も変わります。
データ整備が中心になるケースもあれば、権限管理や監査ログ、評価基盤の整備が重要になるケースもあるため、業務課題と技術要件を切り分けて考える必要があります。
導入を検討するなら、まずは対象業務の明確化、参照データの整備状況、PoCで測る効果指標、本番運用時の安全性要件を整理しましょう。
そのうえで、小さく試して精度と業務効果を確かめる進め方が現実的です。
自社だけでRAGの設計や検証を進めるのが難しい場合は、PoC設計や検索基盤構築、権限制御、評価運用に詳しい外部パートナーへ相談する選択肢もあります。
費用、支援範囲、データ整備の含有範囲、運用保守の考え方まで確認しながら進めることで、自社に合ったRAG活用を具体化しやすくなるでしょう。
エラビサキでは、RAG開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。