生成AIに個人情報を入力してもいいい?判断基準や漏洩リスク、安全対策をご紹介
生成AIを業務で使う中で、「顧客情報や従業員情報を入力してよいのか」「匿名化すれば問題ないのか」と判断に迷う場面があります。
とくに、文章作成や要約、問い合わせ対応の下書きなどでは、元データに個人情報や機密情報が含まれていることも少なくありません。
ただし、生成AIへの入力可否は「全面的に禁止」か「自由に使ってよい」かの二択ではありません。
実務では、学習利用の有無、保存や保持の条件、契約内容、管理者設定、社内ルールなどを確認したうえで判断する必要があります。
この記事では、生成AIに個人情報を入力してよいかを判断する考え方を軸に、問題になりやすい理由、学習利用・保存・保持の違い、入力前に確認したい契約や設定、社内ルール整備の進め方まで整理して解説します。
生成AIに個人情報を入力してよい?まず押さえる判断の考え方
結論からいうと、生成AIに個人情報を入力してよいかは、個人情報保護法上の利用目的や提供先での取り扱い、安全管理措置に加え、ツールの種類や契約条件などを踏まえて判断する必要があります。
「生成AIだから一律に危険」なのではなく、どのデータを、どの環境で、どの条件で扱うかを分けて考えることが重要です。
まず確認したいのは、その入力が本当に必要かどうかです。
個人名や電話番号、メールアドレスを含めなくても目的を達成できるなら、匿名化や要約後データへの置き換えを優先した方が安全でしょう。
たとえば、問い合わせ返信の文面を整えたいだけなら、実名や連絡先を伏せて「顧客A」「注文番号X」と置き換えた下書きでも十分なことがあります。
次に見るべきなのは、利用する生成AIサービスの契約や設定です。
入力内容がモデル学習に使われるのか、サービス内に保存されるのか、管理者が保持期間を設定できるのかによって、リスクの大きさは変わります。
さらに、法務や情報システム部門の観点だけでなく、現場の運用も重要です。
承認なく私用アカウントで利用していないか、アクセス権限が適切か、ログを確認できるかといった点まで含めて判断しないと、ルールがあっても漏洩は防ぎにくくなります。
実務上は、次のような順番で判断すると整理しやすくなります。
- 入力するデータが個人情報・機密情報・営業秘密に当たるかを分類する
- そのデータを入力しない代替手段があるかを確認する
- 利用する生成AIの契約条件と設定を確認する
- 社内ルール上、入力が許可されている用途かを確認する
- 必要なら匿名化や承認フローを経て利用する
とくに大切なのは、便利だから入力するのではなく、必要性・許容条件・代替可能性の3点で考えることです。
生成AIで個人情報の入力が問題になりやすい理由
個人情報の入力が問題になりやすいのは、生成AIが単なる文書作成ソフトではなく、外部サービスや大規模モデル、各種連携機能と結びついていることが多いためです。
入力した瞬間に第三者へ公開されるわけではなくても、利用者が想定していない保存、参照、連携、権限共有が起こりうる点に注意が必要です。
また、個人情報は一度漏れると影響範囲が広がりやすい特徴があります。
氏名だけでは大きな問題に見えなくても、所属、連絡先、商談履歴、健康情報、人事評価などが組み合わされると、本人特定や不利益につながる可能性が高まります。
生成AIでは、利用者が入力欄へ自然文で貼り付けることが多いため、構造化された基幹システムよりも「何を入れたか」を意識しにくいのも厄介な点です。
さらに、社内では「学習されない設定なら大丈夫」「保存されないなら安全」といった誤解も起こりがちです。
しかし実際には、学習利用されないことと、保存や保持が一切ないことは同じではありません。
この違いを曖昧にしたまま運用すると、現場判断がばらつきやすくなります。
また、管理部門が把握していない未承認利用、いわゆるシャドーAIも統制上のリスクになりえます。
承認済みの法人契約環境ではなく、従業員が個人アカウントや未承認ツールに情報を入力してしまうと、統制の前提そのものが崩れてしまいます。
学習利用・保存・保持の違いを整理する
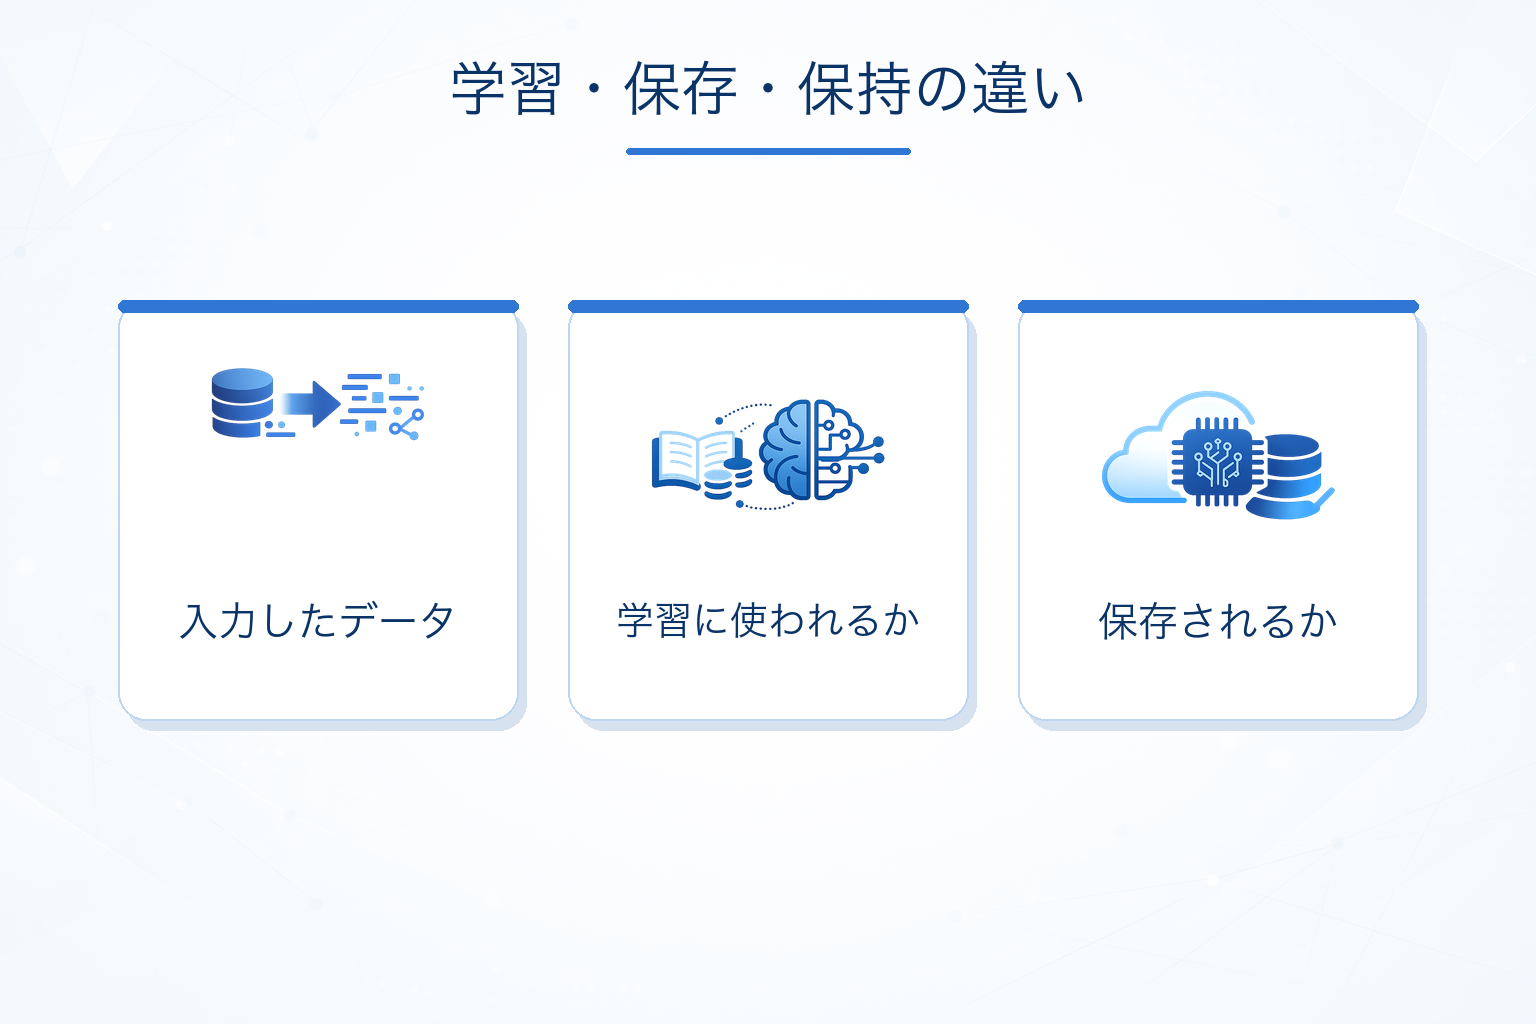
生成AIの安全性を判断するときに混同されやすいのが、「学習利用」「保存」「保持」の違いです。
この3つは似ているようで意味が異なるため、区別して確認する必要があります。
学習利用とは、入力データや会話内容が将来のモデル改善や再学習に使われることを指します。
利用規約や法人向け契約で、学習への利用有無が分かれるケースがあります。
一方、保存は、やり取りした内容が履歴やログ、機能改善、監査、障害対応などの目的でシステム上に残ることです。
学習に使われなくても、保存自体は行われる場合があります。
保持は、その保存されたデータがどれくらいの期間残るかという観点です。
短期間で削除されるのか、管理者設定で保持期間を制御できるのか、一定期間はベンダー側で保有されるのかによって、運用上の判断は変わります。
「学習されない」だけでは十分ではなく、保存されるか、どこまで保持されるかまで確認して初めて入力可否を判断しやすくなります。
実務では、次のように切り分けて確認すると分かりやすいでしょう。
- 学習利用:入力内容がモデル改善や再学習に使われるか
- 保存:履歴、ログ、監査、運用のためにデータが残るか
- 保持:保存されたデータがどのくらい残るか、削除や制御ができるか
- 共有範囲:ベンダー、管理者、連携先など、誰が参照しうるか
また、サービスによっては、通常のチャット機能とAPI利用、個人向けプランと法人向けプランで条件が異なることもあります。
同じ製品名でも契約形態によって扱いが変わるため、一般的な印象だけで判断しないことが大切です。
個人情報と機密情報・営業秘密はどう切り分けるか
生成AIへの入力可否を考える際は、個人情報だけを見れば十分というわけではありません。
実際には、個人情報、機密情報、営業秘密は重なり合うこともあり、それぞれ別の観点で判断する必要があります。
個人情報は、特定の個人を識別できる情報や、他の情報と容易に照合して本人を特定できる情報を含みます。
顧客名簿、従業員情報、問い合わせ履歴、履歴書、面談記録などは代表例です。
機密情報は、個人情報に限らず、社外に漏れると事業運営へ影響がある情報全般を指します。
たとえば、未公開の事業計画、価格戦略、契約条件、開発仕様、インシデント対応内容などが該当しやすいでしょう。
営業秘密は、その中でも秘密として管理され、有用性があり、公然と知られていない情報として扱われるものです。
顧客リストや製造ノウハウ、アルゴリズム、独自の営業手法などが該当することがあります。
ここで重要なのは、個人情報でなければ自由に入力してよい、とは限らない点です。
氏名を消していても、未公開の提案内容やソースコード、原価情報を入力すれば、別の意味で重大なリスクになりえます。
社内では、自社ルールの一例として、次のような分類を設けておくと運用しやすくなります。
- そのまま入力禁止の情報
- 匿名化・要約すれば入力可の情報
- 承認を得れば限定的に入力可の情報
- 通常業務で入力してよい情報
たとえば、顧客の氏名・住所・電話番号を含む問い合わせ原文は「そのまま入力禁止」、会議議事録から固有名詞を伏せた要点だけなら「匿名化後に入力可」といった整理です。
この切り分けが曖昧だと、現場は「名前だけ消せば大丈夫」と自己判断しやすくなります。
データ分類の基準を明文化し、迷いやすい例をガイドラインへ落とし込んでおきたいところです。
生成AIで起こりやすい情報漏洩の原因
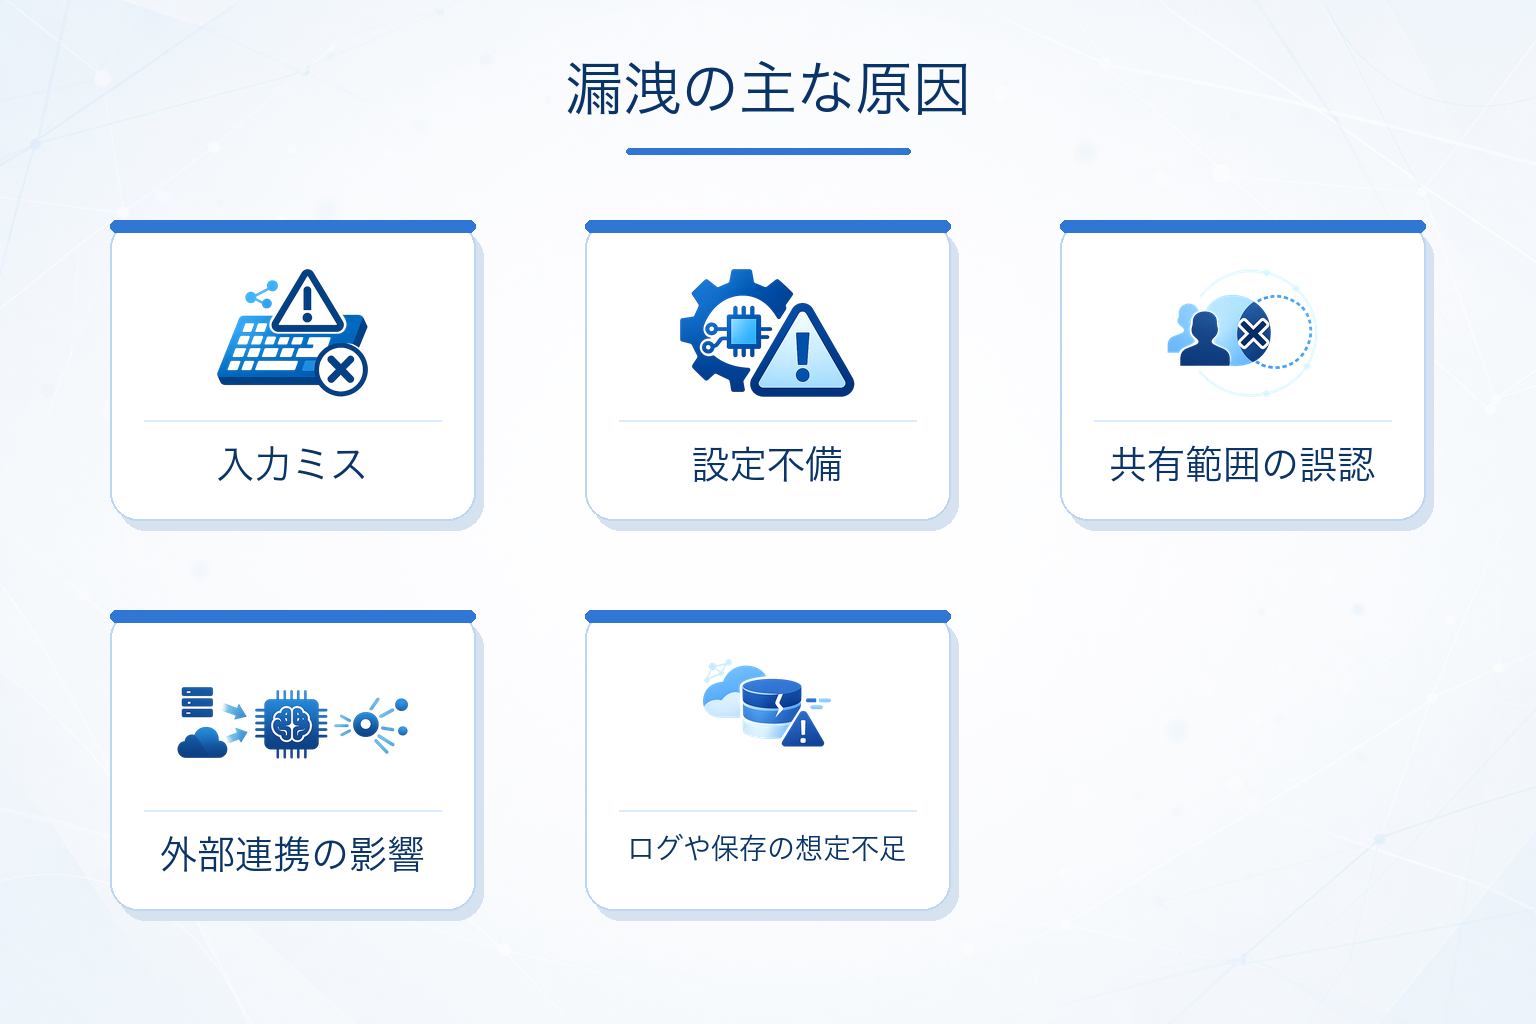
生成AIの情報漏洩は、システムの脆弱性だけで起こるわけではありません。
日常業務の中で起きる入力ミスや設定不足、認識違いも原因になりえます。
代表的な原因は、次のとおりです。
- 氏名、住所、メールアドレスなどをそのまま貼り付けてしまう
- 学習利用オフと保存なしを同じ意味だと誤解する
- 共有リンクや共同編集範囲を誤認する
- 外部ストレージやSaaS連携で想定以上のデータにアクセスさせる
- 私用アカウントや未承認ツールを業務利用する
- ログや履歴の残り方を確認しないまま運用する
とくに起こりやすいのは、業務効率を優先するあまり、元の文書を丸ごと貼り付けてしまうケースです。
要約や文章校正だけが目的でも、元文に個人情報や契約情報が含まれていれば、その時点で入力リスクが発生します。
また、外部連携は便利な一方で見落としやすい論点です。
社内ストレージ、CRM、チャット、メールなどと接続した場合、利用者自身が意識していないデータまで参照範囲に入ることがあります。
たとえば、議事録作成用のアシスタントにカレンダーやドライブへの広い権限を与えると、当初想定していなかった添付資料や連絡先まで扱える状態になることがあります。
より広い観点から対策を整理したい場合は、生成AI情報漏洩の論点もあわせて確認すると全体像をつかみやすくなります。
さらに、アクセス権限の設計不足も見逃せません。
管理者だけが使う前提の設定が一般ユーザーへ広がったり、退職者アカウントが残っていたりすると、漏洩リスクは技術面ではなく運用面から高まります。
入力前に確認すべき契約・設定・権限
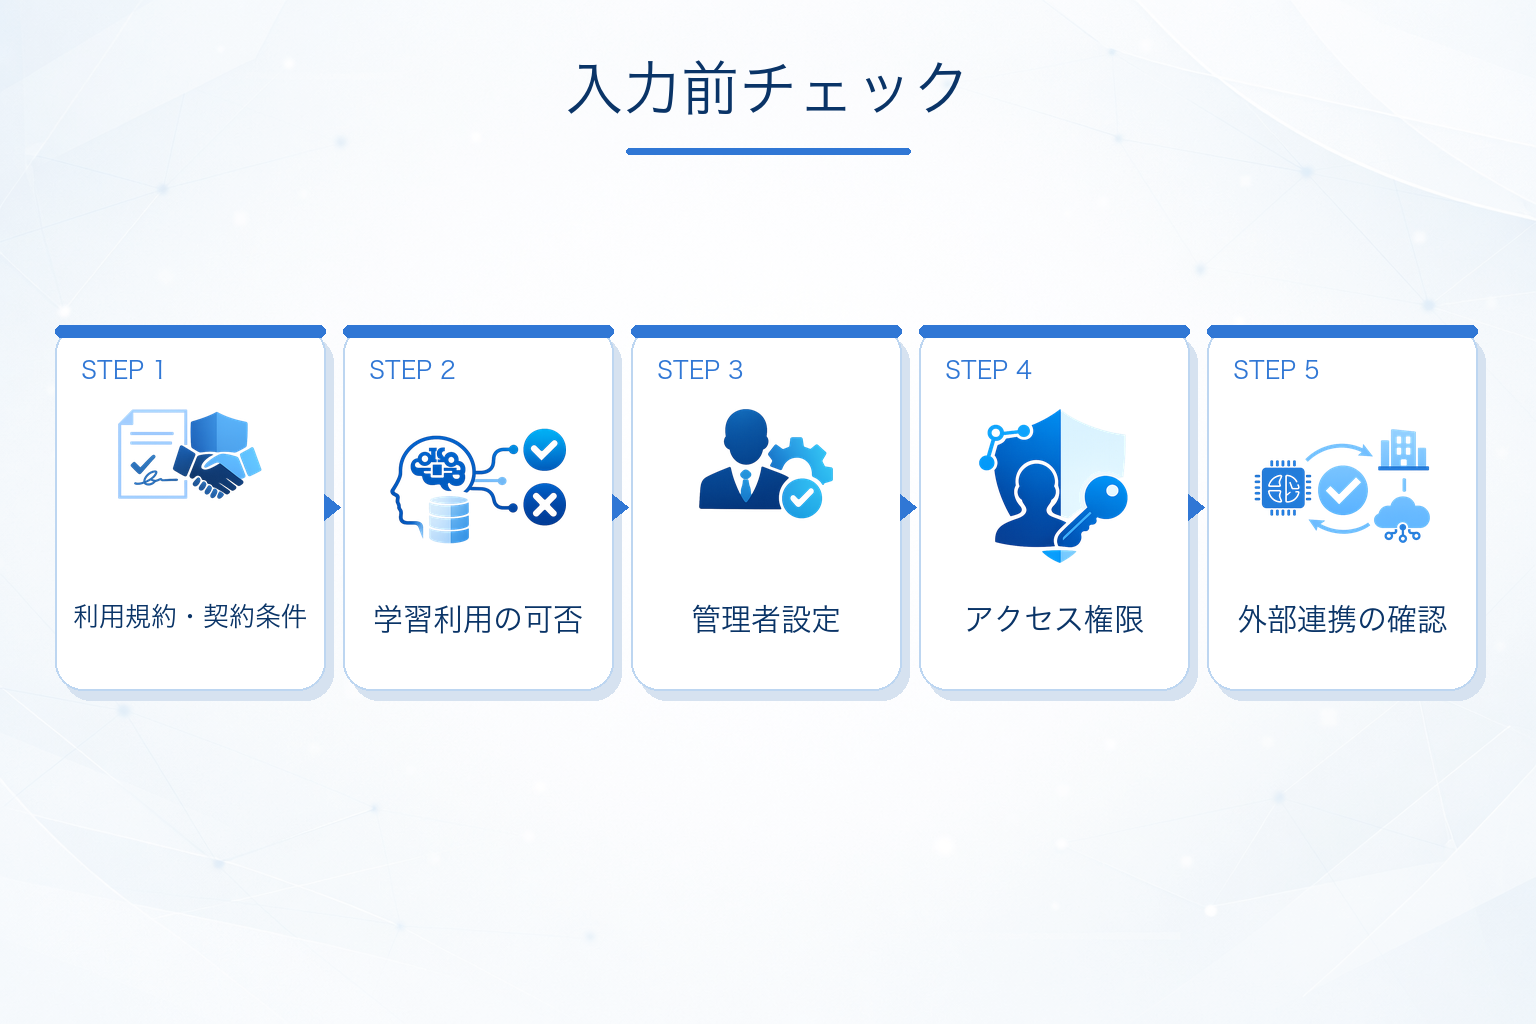
個人情報を扱う可能性があるなら、入力前に実務上よく確認される項目があります。
現場判断に任せきりにせず、導入時点でチェックリスト化しておくと事故を減らしやすくなります。
まず確認したいのは、利用規約や契約条件です。
入力データが学習に使われるか、保存されるか、どのリージョンに保存されるか、削除要件はどうなっているかなどは、契約形態によって差が出やすい部分です。
次に、管理者設定を見ます。
履歴保存の制御、外部連携の許可、共有機能の範囲、監査ログ、SSO、多要素認証など、法人向け機能が使えるかどうかで統制のしやすさは大きく変わります。
さらに、権限設計も欠かせません。
全社員が同じ機能を使える必要はなく、部門や役割に応じて利用範囲を分けた方が安全な場合もあります。
確認事項が多いため、次のように整理すると実務で使いやすいでしょう。
- 利用規約・契約で学習利用や保存条件がどう定められているか
- 保持期間や削除方法を確認できるか
- 管理者機能、監査ログ、アクセス制御を使えるか
- 外部連携やコネクタの参照範囲を制御できるか
- 私用アカウントの利用を禁止または制限できるか
- 社内承認済みの利用用途が明確か
「設定で防げる事故」と「運用で防ぐべき事故」を分けて考えることが、実効性のある統制につながります。
より広く統制設計を考えるなら、生成AIセキュリティの観点もあわせて押さえておくと判断しやすくなります。
個人情報を扱うときの安全な運用ルール
契約や設定が整っていても、運用ルールが曖昧だと現場での事故は防ぎにくくなります。
大切なのは、禁止事項だけを並べるのではなく、「どうすれば安全に使えるか」を具体化することです。
まず実施しやすいのは、入力前の匿名化です。
氏名を役職や顧客Aへ置き換える、連絡先を削除する、自由記述の一部を要約するなど、用途に応じて識別性を下げる工夫が有効です。
ただし、単純なマスキングだけでは再識別の可能性が残ることもあります。
文脈全体で個人が推測できないかまで確認する必要があります。
次に、例外承認の流れを決めておくことも重要です。
通常は入力禁止でも、契約済みの閉域環境や社内専用環境でのみ許可するケースはありえます。
その場合、誰が承認し、何を記録し、いつ見直すかを明確にしておきましょう。
運用ルールとしては、次の項目を整えると実務に落とし込みやすくなります。
- 入力禁止データの明示
- 匿名化してから入力すべきデータの例示
- 例外利用時の承認フロー
- 利用ログの確認方法と保存期間
- 外部連携利用時の事前確認事項
- 退職・異動時の権限見直し
また、文章生成の下書きや要約では、まずダミーデータで試し、問題がないことを確認してから実データへ進む流れが有効です。
現場にとって無理のないルールにしないと、かえって未承認利用へ流れてしまうため、利便性とのバランスも考えたいところです。
社内で生成AI利用ルールを整備するポイント
社内ルールを整備する際は、「禁止事項を並べた文書」を作るだけでは不十分です。
現場が迷わず判断できるように、利用可否の基準と例外処理をセットで示す必要があります。
まず整えたいのは、データ分類です。
個人情報、要配慮情報、機密情報、営業秘密、公開情報などを分け、それぞれについて「入力禁止」「匿名化すれば可」「承認後のみ可」といった扱いを定義します。
次に、利用目的ごとの基準を設けます。
要約、翻訳、議事録作成、問い合わせ草案、社内検索など、用途によって必要な情報量やリスクは異なるため、用途別ルールの方が現場に浸透しやすくなります。
たとえば、翻訳は匿名化した文面のみ可、議事録要約は参加者名を伏せれば可、顧客対応履歴の投入は承認後のみ可、といった形です。
さらに、運用体制も重要です。
誰がルールを所管するのか、法務・情シス・現場部門の責任分界をどうするのか、例外承認を誰が行うのかを曖昧にしないことが大切です。
整備項目としては、次のような内容を含めると実用的です。
- 対象ツールと利用を許可する環境
- 入力禁止データと匿名化ルール
- 学習利用・保存・保持に関する確認方法
- 例外承認フローと記録方法
- ログ管理、権限管理、定期監査の方法
- 教育・周知・見直しのタイミング
実務上は、ルールを一度作って終わりにせず、ツールの仕様変更や業務拡大に応じて見直しやすい形で設計しておくことが大切です。
社内文書として整備する際は、生成AIガイドラインの考え方を参考にすると、利用可否の線引きや承認フローを整理しやすくなります。
また、個別の禁止ルールだけでなく、責任分界や継続的な統制まで含めて考えるなら、AIガバナンスの視点も欠かせません。
生成AIに個人情報を入力する前のFAQ
Q.1 生成AIに個人情報を入れてもよいですか?
一律に可否を決められるわけではありません。利用するサービスの契約条件、学習利用の有無、保存や保持の条件、社内ルール、入力の必要性を確認したうえで判断する必要があります。代替できるなら、個人情報をそのまま入力しない運用が基本です。
Q.2 学習されない設定なら安全ですか?
学習されないことは重要ですが、それだけで安全とは言い切れません。保存の有無、保持期間、管理者や連携先の参照範囲、アクセス権限、ログ管理なども確認が必要です。学習利用オフと保存なしは同じ意味ではありません。
Q.3 保存されないことと学習されないことの違いは何ですか?
学習されないとは、入力内容が将来のモデル改善や再学習に使われないことを指します。保存されないとは、履歴やログとしてデータが残らないことを指します。さらに、保持はどれくらいの期間そのデータが残るかという別の論点です。
Q.4 個人情報と機密情報はどう違いますか?
個人情報は特定の個人を識別できる情報です。一方、機密情報は社外に漏れると事業へ影響する情報全般を指し、個人情報でない情報も含みます。そのため、氏名を消していても、未公開の契約条件や設計情報を入力すれば問題になる可能性があります。
Q.5 営業秘密を生成AIに入力してもよいですか?
慎重に考えるべきです。営業秘密は、秘密として管理され、有用性があり、公然と知られていない情報として扱われます。外部サービスへ入力することで秘密管理性に影響が出るおそれもあるため、原則として安易な入力は避け、必要なら法務や情報管理部門と確認した方がよいでしょう。
Q.6 情報漏洩を防ぐには何を確認すべきですか?
入力前のデータ分類、匿名化の可否、契約条件、学習利用の有無、保存・保持条件、アクセス権限、外部連携、監査ログ、社内承認フローを確認することが重要です。加えて、未承認ツールや私用アカウントの利用を防ぐ運用も欠かせません。
生成AIを安全に活用するための判断基準を整えよう
生成AIに個人情報を入力してよいかは、単に「便利だから使う」「有名なツールだから安心」といった理由だけでは判断できません。
本当に重要なのは、入力の必要性、データの性質、契約や設定、社内統制をあわせて確認し、再現可能な基準で判断することです。
比較や検討の際には、学習利用の条件、保存・保持の扱い、管理者機能と監査ログ、外部連携の制御、社内ルールへの適合性をとくに確認したいところです。
まずは自社で扱うデータを分類し、どこまでを入力禁止にするか、どこから匿名化で対応するかを整理してみましょう。
そのうえで、利用中または導入予定の生成AIについて、契約条件や設定、保持期間、権限管理の実態を確認すると、判断を進めやすくなります。