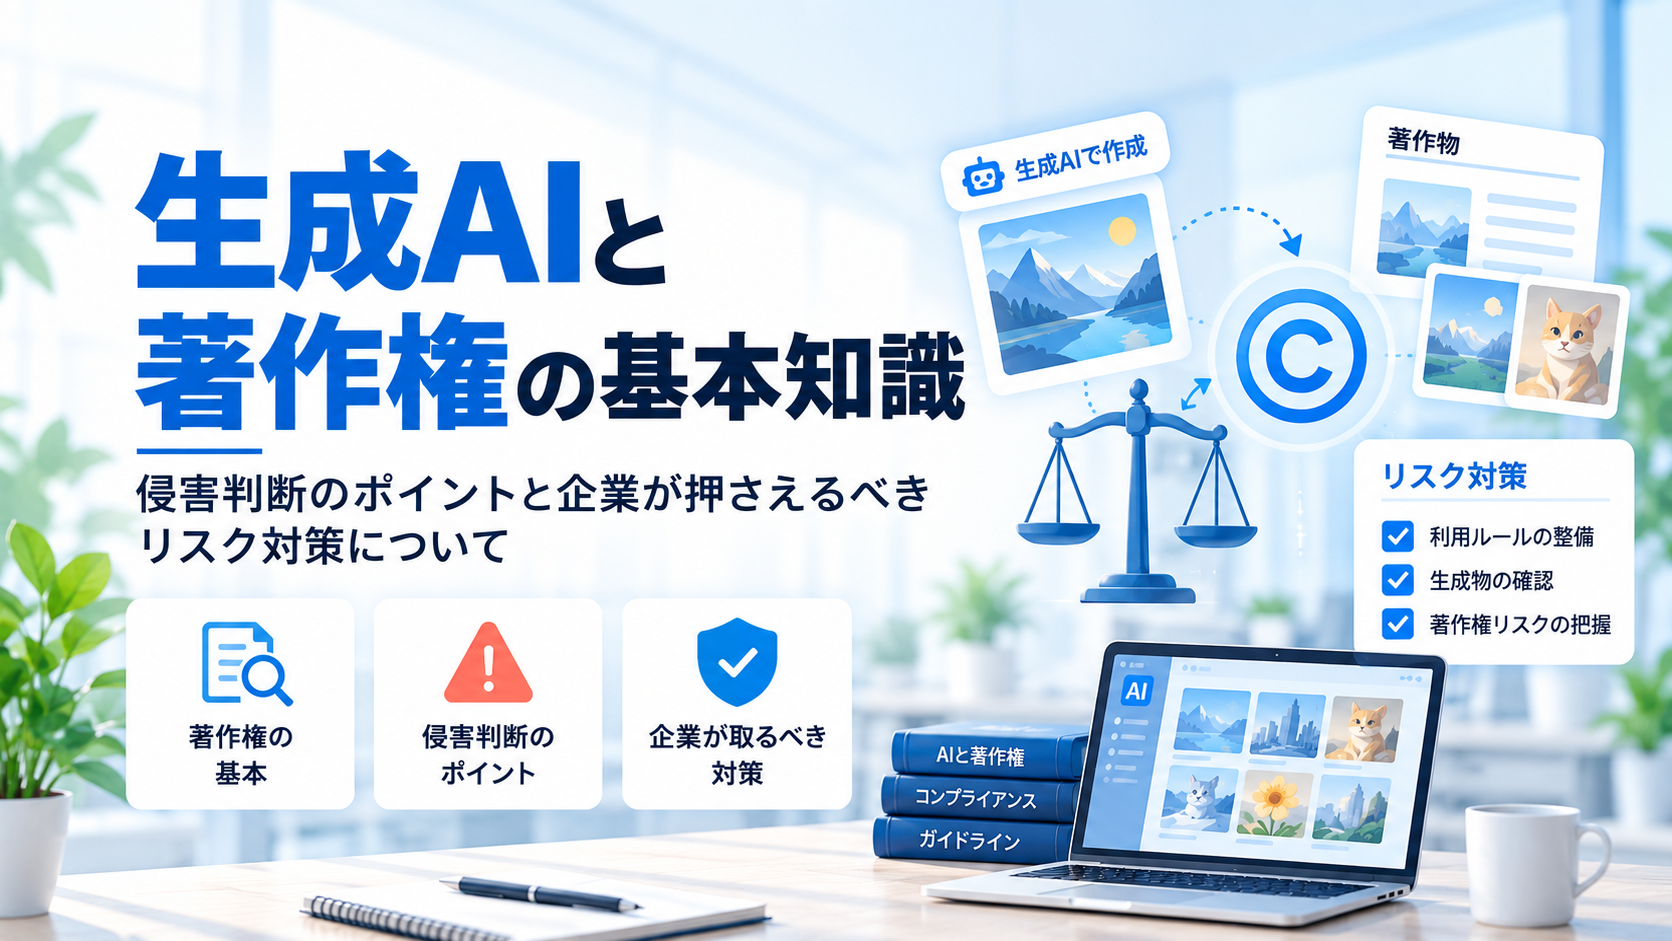
【生成AIと著作権の基本知識】侵害判断のポイントと企業が押さえるべきリスク対策について
生成AIを業務で使う場面では、避けて通れないのが著作権の問題です。
文章作成、画像生成、企画のたたき台作成など便利な使い方が広がる一方で、「どこからが著作権侵害になるのか」「AIが作ったものに権利はあるのか」と判断に迷うケースも少なくありません。
とくに企業では、個人利用とは違って公開物や商用利用、顧客向け資料、広告クリエイティブなどに生成AIを使うことがあるため、誤った運用が法的リスクや信用低下につながる可能性があります。
また、生成AIの著作権は一括りには整理できません。
学習データをどう扱うかという「学習段階」の論点と、生成されたアウトプットをどう使うかという「生成・利用段階」の論点は分けて考える必要があります。
この記事では、生成AIと著作権の基本的な考え方から、著作物・類似性・依拠性といった重要用語、侵害が問題になる具体的な場面、企業が取るべき実務対策までを整理して解説します。
生成AIと著作権の基本的な考え方
生成AIと著作権の関係を理解するうえで大切なのは、「AIを使っているから自動的に違法になる」わけでも、「AIが作ったから自由に使える」わけでもないという点です。
実際の判断では、どのデータを使って学習したのか、どのような指示を与えたのか、生成物が既存作品とどの程度似ているのか、そしてその生成物をどう利用したのかが重要になります。
著作権は、著作物として保護される表現を無断で利用されないための権利です。
そのため、生成AIに関する問題も、最終的には「保護される表現にどこまで触れているか」という観点で整理されます。
一方で、生成AIには従来の著作権実務にはなかった論点もあります。
たとえば、AIの学習に既存作品を使う行為、AIが大量の既存表現を参照しうる環境、生成結果の再現性の低さなどです。
こうした事情があるため、企業では著作権だけでなく、利用規約、商用利用条件、社内ルール、証跡管理まで含めて考える必要があります。
著作権に関する基本用語を整理する
生成AIと著作権を理解するには、まず基本用語を押さえておきたいところです。
言葉の意味が曖昧なままだと、学習段階と利用段階の論点が混ざってしまいます。
- 著作物:著作権法上、思想または感情を創作的に表現したもの
- 著作権:著作物を複製、公衆送信、翻案などされないよう保護する権利
- 複製:既存の著作物をコピーすること
- 翻案:元の表現の本質的特徴を保ちながら別の形に作り変えること
- 類似性:既存作品と生成物の表現上の似方がどの程度あるか
- 依拠性:既存作品を知ったうえで、それに基づいて作成したといえるか
- 非享受目的:著作物に表れた思想や感情を人が楽しむためではなく、情報解析など別目的で利用すること
とくに実務でよく出てくるのが、類似性と依拠性です。
一般に、著作権侵害の判断では類似性・依拠性が主要な検討要素になるとされますが、最終的な判断は個別の事案や利用態様によって異なります。
また、学習段階では「非享受目的」が論点になることがあります。
これは、作品を鑑賞するためではなく、AIの学習や情報解析のために使う場面を考えるうえで重要です。
生成AIの著作権は『学習段階』と『生成・利用段階』で分けて考える
生成AIの著作権問題は、大きく分けると学習段階と生成・利用段階の2つに整理できます。
この切り分けを理解すると、何が問題になっているのかが見えやすくなります。
学習段階では、AIモデルの開発や追加学習のために、どのようなデータを収集し、どう利用するのかが問われます。
ここでは、学習用データの取得方法や利用目的、権利者の利益を不当に害するかといった点が論点になりやすいでしょう。
一方の生成・利用段階では、AIが出力した文章、画像、音声、コードなどを、公開・配布・販売・社内利用するときに著作権侵害が起きないかが問題になります。
つまり、既存作品と似たアウトプットを使った結果として、権利侵害になるかどうかが中心です。
学習段階の適法性と、生成物の利用が適法かどうかは別問題です。
仮に学習段階に一定の整理があっても、生成されたアウトプットが既存作品に酷似していれば、利用段階でリスクが生じる可能性があります。
企業としては、この2段階を分けてルールを作ることが重要です。
導入時の整理には、著作権だけでなく運用設計も必要になるため、全体像は生成AI導入方法の記事とあわせて確認すると理解しやすくなります。
開発・学習段階で著作権侵害が問題になるケース
開発・学習段階で問題になりやすいのは、学習データの収集方法と利用態様です。
既存の著作物を学習に使うこと自体が常に違法と決まるわけではありませんが、無条件で許されると考えるのも危険です。
たとえば、公開されているコンテンツを機械的に収集して学習に使う場合でも、その利用目的や利用形態によっては権利者との関係で問題視されることがあります。
また、海賊版サイトや不正取得データのように、取得経路そのものに問題があるデータを使えば、著作権以外の法的リスクも生じやすくなります。
とくに企業が独自モデルを作る、既存モデルに追加学習させる、社内文書を学習素材として使うといった場合には、次の点を確認したいところです。
- 学習データの取得元は適切か
- 利用規約で学習利用が制限されていないか
- 権利者の利益を不当に害する使い方になっていないか
- 機密情報や個人情報が混在していないか
- 追加学習や再配布に関する契約上の制限がないか
また、著作権だけに注目していると見落としがちですが、社内資料や顧客データを扱うなら情報漏えいリスクも同時に考える必要があります。
入力データの扱いについては、生成AI情報漏洩の観点もあわせて確認しておくと実務上の抜け漏れを減らせます。
生成・利用段階で著作権侵害が問題になるケース
生成・利用段階では、AIが出力したものを実際に使う場面で著作権侵害が問われます。
企業実務では、生成した時点よりも、公開・納品・配布・広告利用した段階で問題が表面化することがあります。
たとえば、生成AIで作成した画像を広告バナーに使う、AIが書いた文章をコラムとして公開する、コード生成AIの出力をそのまま製品に組み込むといったケースです。
その出力が既存の著作物に類似し、しかも依拠性が認められると評価される場合には、複製や翻案の問題になりえます。
また、社外公開だけがリスクとは限りません。
社内資料、提案書、営業コンテンツでも、後に外部共有されたり、顧客に提出されたりすることで問題が顕在化することがあります。
利用段階で注意したい代表的な場面は次のとおりです。
- 生成画像を広告、LP、SNS投稿に利用する
- 生成文章を記事、ホワイトペーパー、提案資料にそのまま使う
- AI生成コードを検証不足のままサービスへ実装する
- 特定の作家や作品に酷似する出力を公開する
- 既存キャラクターやブランド表現に近い生成物を商用利用する
実務では「AIが作ったかどうか」よりも、「その出力をどのように使ったか」が問われます。
そのため、生成物の利用前チェックを設けることが重要です。
類似性・依拠性・非享受目的の見方
生成AIの著作権を考えるうえで、類似性・依拠性・非享受目的は中核となる概念です。
それぞれ役割が違うため、混同しないことが大切です。
まず類似性は、生成物が既存作品の表現上の本質的特徴をどの程度共有しているかを見る考え方です。
アイデアレベルで似ているだけでは足りず、具体的な表現としてどこまで近いかが問われます。
次に依拠性は、元作品を知ったうえで、それに基づいて作成したといえるかどうかです。
まったく同じ内容に偶然近づいた可能性と、何らかの形で元作品を参照した結果なのかでは評価が変わります。
生成AIでは、ユーザーが明示的に既存作品名や作家名を指定した場合、依拠性が疑われやすくなることがあります。
反対に、一般的な指示から偶然近い表現が出た場合でも、出力の内容次第では慎重な確認が必要です。
非享受目的は主に学習段階を考える際の概念で、作品を人が鑑賞して楽しむためではなく、情報解析や機械学習のために利用する場面に関係します。
ただし、非享受目的だからといってすべて無条件で安全だと考えるのは早計です。
利用の態様や権利者利益への影響まで含めて見なければなりません。
実務で見るなら、次のように整理するとわかりやすいでしょう。
- 類似性:出力が既存作品の表現にどれだけ近いか
- 依拠性:その既存作品を参照・学習・指定した事情があるか
- 非享受目的:学習や解析のための利用か、それとも作品の表現自体を楽しむ利用か
企業では、この3点を法務部門だけで抱え込まず、生成AI利用部門と共有できる確認項目に落とし込むことが重要です。
AI生成物に著作権は認められるのか
AI生成物に著作権が認められるかは、多くの企業担当者が気になる論点です。
結論からいえば、AIが自動的に出力しただけでは、直ちに著作物として保護されるとは限りません。
著作物として保護されるには、人の思想または感情が創作的に表現されていることが前提になります。
そのため、人間の創作的関与がどこまであったかが重要です。
たとえば、細かな構成や表現意図をもってプロンプトを設計し、出力結果を選別し、編集や加筆、修正を重ねた場合には、人の創作的関与が問題になります。
一方で、汎用的な指示を与えてAIが自動出力した結果をそのまま使っただけなら、著作物性が認められにくい可能性があります。
また、著作権が認められるかという論点と、既存作品を侵害していないかという論点は別です。
自社に著作権があると言いたくなる生成物でも、他人の著作物に類似していれば侵害リスクは残ります。
企業実務では、AI生成物を「完全に自社権利化できる」と前提にするよりも、人間による編集・選択・監修の工程を残し、その記録を保管する運用が現実的です。
生成AIによる著作権侵害の具体例
抽象的なルールだけでは判断しにくいため、どのような場面が危険かを具体例で押さえておきましょう。
- 有名イラストレーターの作風を指定し、既存作品に酷似した画像を制作して広告に使う
- 小説や記事の一部を入力し、続きや言い換えを生成して公開する
- 既存キャラクターに非常に近いビジュアルを生成し、商品販促に使う
- 学習元が不明な画像生成AIで作った素材を、権利確認なしで商用配布する
- コード生成AIの出力をライセンス確認なしで製品へ組み込む
これらに共通するのは、生成AIの便利さに引っ張られ、元作品との距離や利用条件の確認が後回しになっている点です。
とくに、特定の作家名・作品名・ブランド名をプロンプトへ入れる使い方は、社内で明確にルール化したほうがよいでしょう。
また、侵害の有無は見た目の印象だけで決まるわけではありませんが、第三者から「似ている」と指摘された時点で、説明責任や対応コストが発生します。
その意味でも、事後対応より事前予防のほうが負担を抑えやすくなります。
なお、既存キャラクターやブランド表現に近い生成物を扱う場面では、著作権に加えて商標や不正競争防止法など別の論点が生じることもあります。
企業が押さえるべきリスク
企業が生成AIの著作権問題で注意すべきなのは、単なる法的責任だけではありません。
実際には、レピュテーション、業務停滞、再制作コストなど複数のリスクが重なります。
- 法的リスク:著作権侵害を理由とする差止請求や損害賠償の可能性
- 信用リスク:無断利用や不適切運用が発覚した際の企業イメージ低下
- 業務リスク:公開停止、差し替え、再制作、社内調査の発生
- 契約リスク:顧客向け成果物に問題があった場合の責任分担の争い
- 統制リスク:部門ごとに異なる運用が行われ、管理が効かなくなること
また、著作権対応はセキュリティや情報管理とも切り離せません。
安全な利用体制を整えるには、生成AIセキュリティの観点も含めて、ルールとシステムの両面で整備することが求められます。
とくにBtoB企業では、顧客向け成果物に生成AIを使う場合の説明責任が重くなります。
制作工程、チェック体制、利用ツール、契約上の責任範囲まで含めて整理しておくことが大切です。
生成AIで著作権侵害を防ぐための対策
著作権侵害を防ぐには、担当者の注意力に頼るのではなく、企業として運用ルールを仕組み化することが実務上有効です。
場当たり的な対応では、利用場面が広がるほど漏れが出やすくなります。
まず、社内で生成AIの利用ルールを明文化しておくと、リスク低減につながります。
どのツールを使ってよいのか、どんなデータ入力を禁止するのか、どの用途で法務確認を行うのかを定めることが出発点です。
社内文書の整備では、生成AIガイドラインの考え方も参考になります。
次に、利用前・利用後の確認フローを設けておくと運用しやすくなります。
とくに対外公開物や商用利用物については、担当者だけで完結させず、レビュー工程を設けるとより安全です。
実務上の対策は、次のように整理できます。
- 利用目的と対象業務を整理する
- 使用ツールの利用規約と商用利用条件を確認する
- 入力してよい情報・禁止情報を定める
- 生成物の類似性チェックとレビュー手順を作る
- 公開前承認フローと記録保存ルールを決める
- 社員教育を継続的に行う
とくに重要なのは、プロンプト入力ルールと出力確認ルールです。
特定作家の名前や既存作品の具体指定を避ける、顧客資料や機密情報を入力しない、公開前に画像検索や文面確認を行う、といった運用を決めておくと事故を減らしやすくなります。
実務で入れておきたいチェック項目
- 対外公開前に、既存作品との酷似がないかを担当者以外も確認する
- 画像生成物は、必要に応じて画像検索や出典確認を行う
- 文章生成物は、引用の混入や固有表現の不自然な類似がないか確認する
- コード生成物は、コメントやライセンス表示、既存コードとの一致を確認する
- 利用ツールに一致参照機能などがある場合は併用する
- 利用したツール名、日時、プロンプト、編集履歴、承認者を記録する
こうした確認を残しておくと、後から問い合わせや指摘を受けた際にも、どのような手順で生成・確認したかを説明しやすくなります。
文化庁など公的情報で確認したいポイント
生成AIと著作権は、ネット上の断片的な解説だけで判断しないことが重要です。
とくに社内ルールを整備する場合は、文化庁など公的機関の整理を確認しておきたいところです。
確認したい主なポイントは次のとおりです。
- 学習段階と生成・利用段階をどう分けて考えるか
- 著作物性の判断に人の創作的関与がどう関わるか
- 類似性・依拠性がどのように扱われるか
- 非享受目的に関する考え方
- 最新の議論や実務上の留意点に変更がないか
法的な整理は今後もアップデートされる可能性があります。
そのため、一度ルールを作って終わりではなく、社内ガイドラインやレビュー基準を定期的に見直すことが大切です。
詳細を確認する際は、文化庁の「AIと著作権について」ページや、同ページから案内されている関連資料を参照するとよいでしょう。
よくある質問
Q.1 生成AIの学習段階と利用段階では何が違うのですか?
学習段階では、AIモデルがどのデータを使って学習するか、そのデータの取得方法や利用目的が主な論点になります。一方、利用段階では、AIが出力した文章や画像などを公開・配布・販売したときに、既存作品との類似性や依拠性が問題になります。つまり、学習時の適法性と、生成物の利用時の適法性は分けて考える必要があります。
Q.2 AI生成物に著作権は認められますか?
一律にはいえません。著作物として保護されるには、人の思想または感情が創作的に表現されていることが前提になるため、人間がどこまで創作的に関与したかが重要です。単なる自動出力だけでは著作物性が認められにくい場合がある一方で、詳細な指示、選別、加筆修正など人の創作的関与が強い場合には検討余地があります。
Q.3 どのような場合に生成AIが著作権侵害になりますか?
一般には、既存作品との表現上の類似性があり、さらにその作品に依拠して作成したといえる場合に問題になりやすいとされます。ただし、最終的な侵害判断は個別事情によって異なります。とくに、特定の作品名や作家名を指定して酷似した生成物を作り、それを公開や商用利用するケースは慎重な確認が必要です。
Q.4 企業はどんな対策を取るべきですか?
実務上は、利用ルールの明文化、入力禁止情報の設定、商用利用条件や利用規約の確認、生成物のレビュー体制、記録保存、社員教育を整えておくとリスク低減につながります。著作権だけでなく、情報漏えいやセキュリティ、契約面まで含めて運用を見直すことも大切です。
Q.5 プロンプト入力で注意すべき点は何ですか?
特定作家名や既存作品名を安易に指定しないこと、顧客情報や機密情報を入力しないこと、社外公開を前提とする成果物では利用条件を事前に確認することが大切です。また、出力結果をそのまま使わず、人間が内容や類似性を確認する運用も有効です。
生成AIの著作権リスクを理解して適切に活用しよう
生成AIと著作権を考えるときは、便利さだけで運用を決めないことが大切です。
学習段階と生成・利用段階では論点が異なり、同じ「AI活用」でも確認すべき項目は変わります。
実務でまず整理したいのは、利用ツールの規約、入力データの取り扱い、生成物のレビュー体制、公開前の承認フロー、記録保存の方法です。
まずは、自社でどの業務に生成AIを使うのかを整理し、入力してよい情報と禁止情報、公開前チェックの対象、法務確認を行うケースを明文化していきましょう。
判断が難しい場合は、法務、情報システム、事業部門を交えた体制で運用し、必要に応じて外部の専門家へ相談することも検討したいところです。