【完全ガイド】ローカルLLMの構築方法|必要環境やGPU/VRAM、活用例まで解説
ローカルLLMを自社PCや社内サーバーで動かしたいと考えたとき、最初に気になるのは「どのくらいの環境が必要なのか」「GPUやメモリはどこまで必要か」「クラウドLLMと比べて本当にメリットがあるのか」といった点ではないでしょうか。
実際、ローカルLLMの構築は単にモデルをダウンロードすれば終わるものではありません。
モデルサイズ、量子化の有無、推論エンジン、OS、UI連携、運用方法まで含めて整理しないと、思ったより動作が重かったり、使いどころが合わなかったりすることがあります。
そこで、こちらの記事では、ローカルLLMの基本から、構築前に確認したい必要環境、GPU・メモリの考え方、具体的な構築手順、代表的な構成パターン、活用例、注意点までを体系的に解説します。
これから個人検証を始めたい方にも、業務利用を見据えて情報を整理したい担当者にも、全体像がつかめる内容です。
ローカルLLMとは
ローカルLLMとは、クラウド上のAPIを呼び出すのではなく、手元のPCや社内サーバー上で大規模言語モデルを実行する構成を指します。
入力したプロンプトや参照データを外部サービスへ送らずに処理できるため、機密情報を扱う業務や、ネットワーク制約のある環境で検討されやすい方式です。
クラウドLLMとの大きな違いは、推論処理の実行場所にあります。
クラウド型ではOpenAIやAnthropicなどの外部基盤を利用しますが、ローカルLLMでは自社または個人の管理下にあるマシン上でモデルを動かします。
そのため、データ統制のしやすさという利点がある一方で、ハードウェア準備や性能調整は自前で行う必要があります。
また、ローカルLLMといっても構成は一つではありません。
ノートPCで軽量モデルを試す小規模な使い方もあれば、GPUを搭載したサーバーで複数ユーザーが利用する形もあります。
用途や利用人数によって必要構成は大きく変わるため、構築前に全体像を押さえておくことが重要です。
なお、LLM全体の開発工程や評価・運用まで広く整理したい場合は、LLM開発の記事もあわせて確認しておくと理解しやすくなります。
ローカルLLMを構築するメリット・デメリット
ローカルLLMには明確な利点がありますが、向いているケースと向いていないケースが分かれます。
導入判断を誤らないためにも、両面から見ておきましょう。
メリット
まず大きいのは、機密情報を外部APIへ送らずに処理しやすいことです。
法務・人事・研究開発のように取り扱う情報がセンシティブな業務では、この点が導入理由になりやすいでしょう。
外部APIの従量課金を抑えられる可能性があることも利点です。
利用頻度が高い業務ではクラウドAPIの利用料が積み上がることがありますが、ローカル環境ではハードウェアを自社で保有して継続利用できます。
ただし、機材費や電力、保守などが発生するため、必ずローカルLLMの方が低コストになるわけではありません。
ネットワーク制限がある環境でも使いやすい点も見逃せません。
閉域環境やオフラインに近い運用が必要な現場では、ローカル処理の方が要件に適合しやすいことがあります。
さらに、モデルや推論条件を細かく調整しやすいのも特徴です。
量子化モデルの切り替え、推論パラメータの調整、独自アプリへの組み込みなど、実験や最適化の自由度を高められます。
デメリット
一方で、ローカルLLMは構築と運用の負荷を伴います。
クラウドAPIのようにすぐ使えるわけではなく、GPUやCPU、メモリ、ドライバ、推論エンジン、UI、権限管理などを含めて環境を整える必要があります。
性能面の制約もあります。
とくに大きなモデルを高精度・高速に動かしたい場合、必要なメモリや計算資源が増えるため、モデル選定がそのまま実用性を左右します。
また、運用保守を自前で担う必要がある点も重要です。
モデル更新、脆弱性対応、障害対応、ログ管理など、使い始めてからの管理コストも考えておかなければなりません。
クラウドLLMの最新モデルと比べると、応答品質や多言語性能、長文処理能力などで差が出る場合もあります。
そのため、ローカル化そのものを目的にするのではなく、セキュリティ要件、コスト構造、性能要件のどれを優先するのかを先に決めることが大切です。
ローカルLLMの構築に必要な環境
ローカルLLMの必要環境は、利用するモデルと用途によって変わります。
ただし、事前に確認したい項目はある程度共通しています。
- GPUの有無とVRAM・利用可能なメモリ容量
- CPU性能
- メインメモリ容量
- ストレージ容量と読み書き速度
- 対応OSとドライバ環境
- 利用する推論エンジンとの相性
この中でも、モデルをどのメモリへ読み込めるかは重要なポイントです。
NVIDIA GPUなどを利用する構成ではVRAM容量が大きな制約になりますが、軽量・量子化モデルであればCPUのみで動かせる場合もあります。
高速な推論や複数ユーザーでの利用を想定する場合は、GPUを利用する構成が有力です。
一方、Apple Siliconを搭載したMacでは、CPUとGPUが同じユニファイドメモリを共有するため、一般的なCPU+独立GPU構成のVRAMとは考え方が異なります。
そのため、「GPUのVRAMが何GB必要か」だけでなく、利用するハードウェアの構成とモデルの実行方式をセットで確認することが重要です。
モデルサイズと量子化で必要メモリは変わる
ローカルLLMの必要メモリを考えるうえで重要なのが、モデルのパラメータ数と量子化です。
一般に、パラメータ数が多いモデルほど多くのメモリが必要になります。
モデルの重みだけを単純計算すると、FP16では1パラメータあたり約2バイト、8bitでは約1バイト、4bitでは約0.5バイトがひとつの目安になります。
たとえば7Bクラスのモデルであれば、重みだけを単純計算した場合、FP16では約14GB、8bitでは約7GB、4bitでは約3.5GBとなります。
ただし、実際の推論ではモデルの重み以外にも、KVキャッシュやランタイムなどにメモリを使用するため、単純計算した容量より余裕が必要です。
コンテキスト長を大きくしたり、複数ユーザーが同時に利用したりする場合も必要メモリは増えます。
そのため、「7Bなら何GBあれば必ず動く」と固定的に考えるのではなく、モデル形式、量子化方式、コンテキスト長、推論エンジンなどを含めて確認する必要があります。
13B、30B、70Bクラスなどモデルが大きくなるにつれて必要な計算資源も増えるため、個人PCで利用する場合は量子化モデルを選択したり、より小さなモデルから検証したりする方法があります。
つまり、「どのモデルを動かしたいか」ではなく「どの精度と速度で、何人が使うか」まで含めて環境を考えることが重要です。
メインメモリとストレージも軽視できません。
モデル本体の保存だけでなく、埋め込みデータ、ログ、参照文書、ベクトルDBなどを使う場合はストレージ使用量が増えます。
業務利用でRAGと組み合わせるなら、RAG構築を前提にしたデータ保管や検索基盤の設計も見ておきたいところです。
OS面では、Linuxを利用する構成がある一方、検証段階ではWindowsやmacOSでも始められます。
ただし、利用したい推論エンジン、GPU、ドライバなどによって対応環境が異なるため、導入前に公式ドキュメントで対応状況を確認しましょう。
GPU・メモリを考えるときの見方
GPUやメモリは、単純に高性能・大容量なものを選べばよいわけではありません。
重要なのは、使いたいモデルサイズ、量子化の有無、同時利用者数、コンテキスト長、求める応答速度をセットで考えることです。
個人検証なら多少応答が遅くても成立しますが、業務で複数人が同時に使う場合は、同じモデルでも求められる処理性能が変わります。
応答待ち時間が長すぎれば、AIそのものの精度が高くても現場で使われなくなる可能性があります。
PoC段階では、まず小さめのモデルで業務適合性を検証し、実測した応答速度やメモリ使用量をもとに本番環境を設計する進め方が現実的です。
いきなり高価なGPU環境を用意するより、必要な性能を把握してから設備を拡張した方が過剰投資を避けやすくなります。
ローカルLLMの構築手順
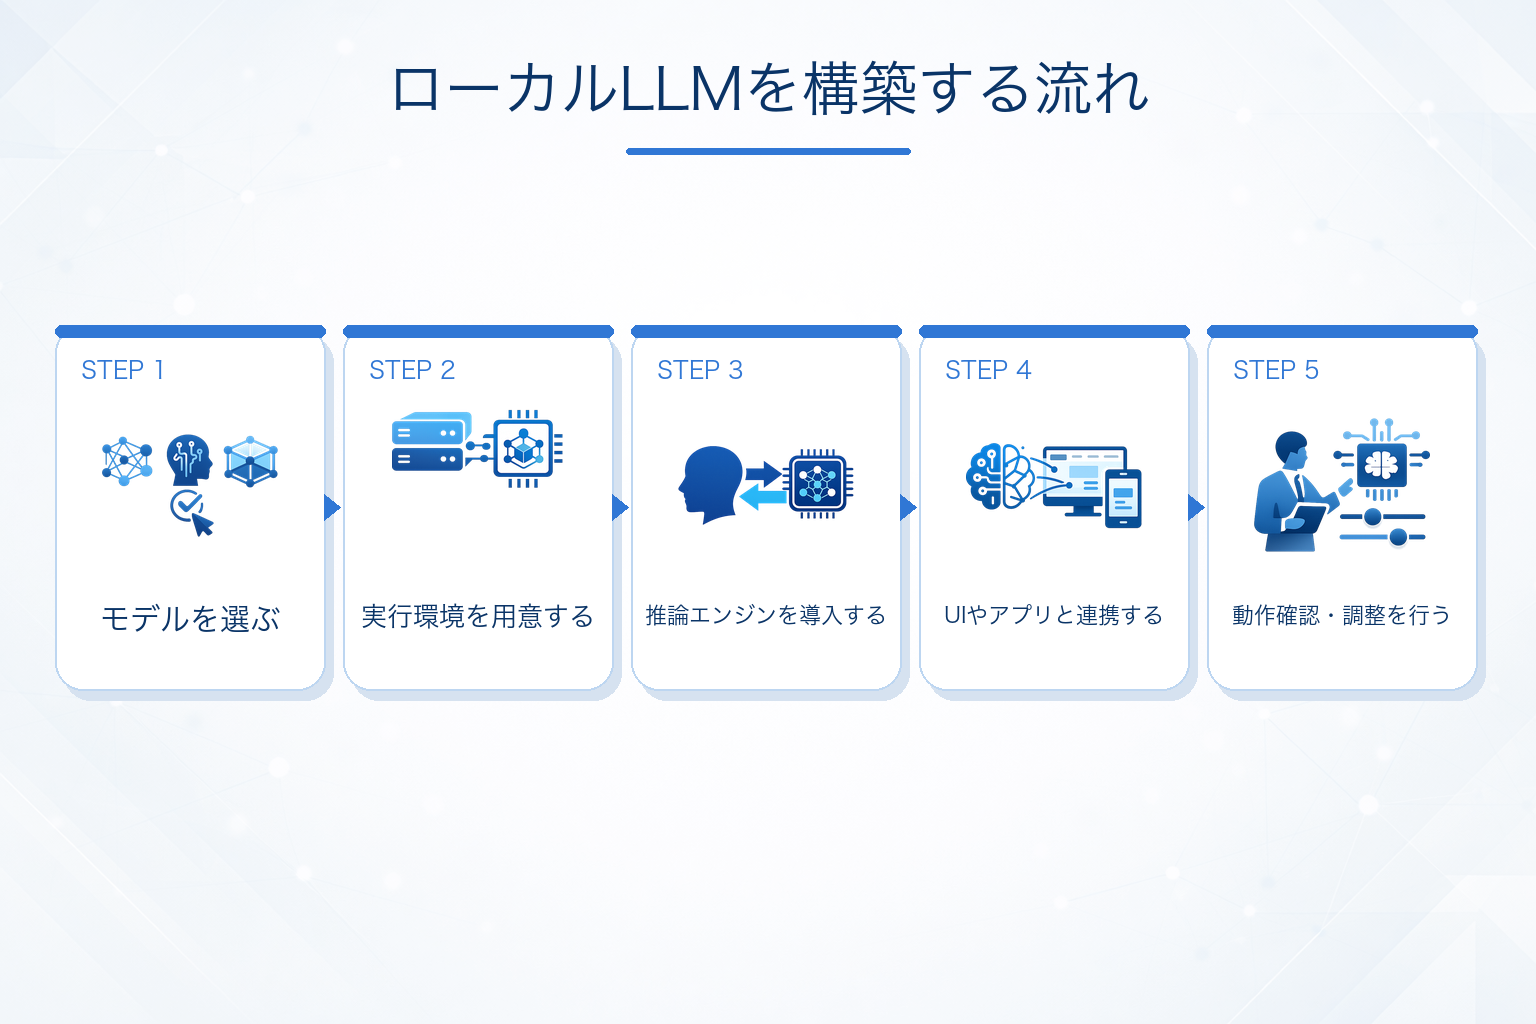
ローカルLLMの構築は、一般的に次の流れで進めます。
- 利用目的と要件を整理する
- モデルを選定する
- 実行環境を用意する
- 推論エンジンを導入する
- UIやアプリと連携する
- 動作確認と性能調整を行う
1. 利用目的と要件を整理する
最初に行いたいのは、ローカルLLMを何に使うのかを明確にすることです。
チャット、コード補完、社内文書検索、要約、定型文生成など、用途によって必要なモデルや構成は大きく変わります。
業務利用であれば、利用人数、同時接続数、許容できる応答時間、扱うデータの機密性なども整理しておきましょう。
ここが曖昧なまま構築を始めると、性能不足か過剰投資のどちらかに寄りやすくなります。
2. モデルを選定する
用途と要件を整理したら、利用するLLMを選定します。
モデル選定では、単純なパラメータ数だけでなく、日本語性能、ライセンス、コンテキスト長、量子化版の有無、利用する推論エンジンへの対応などを確認します。
最初から大規模なモデルを選ぶのではなく、軽量モデルから試し、実際の業務データで品質を確認しながら必要に応じてモデルを変更する方法もあります。
とくに商用利用する場合は、モデルごとにライセンス条件が異なるため、利用条件を必ず確認しましょう。
3. 実行環境を用意する
モデルが決まったら、実行するハードウェアとOSを用意します。
NVIDIA GPUを利用するPC・サーバー、Apple Siliconを搭載したMac、CPU中心の環境など、利用するモデルや推論エンジンに応じて構成を決めます。
必要に応じてGPUドライバや関連ライブラリ、Pythonなどの実行環境も整えます。
ハードウェアを先に決めるのではなく、利用するモデルと推論エンジンの対応環境を確認してから構成を決める方が、セットアップ時の問題を減らしやすくなります。
4. 推論エンジンを導入する
次に、LLMを実際に動かすための推論エンジンを導入します。
代表的な選択肢として、Ollama、llama.cpp、vLLMなどがあります。
Ollamaはモデルを比較的手軽に取得・実行しやすく、ローカルLLMを試し始めたい場合の選択肢になります。
llama.cppは量子化モデルや幅広いハードウェアでのローカル推論に利用されており、CPUを含めた構成で動かしたい場合にも候補になります。
vLLMはLLMをAPIサーバーとして提供し、高いスループットが求められる構成などで利用されます。
どれを選ぶかは、個人利用なのか、ブラウザから使いたいのか、自社アプリへAPIとして提供するのか、複数ユーザーで共有するのかによって変わります。
5. UIやアプリと連携する
推論環境を用意したら、利用者が使いやすい形へ接続します。
個人検証であればコマンドラインでも利用できますが、チームで使う場合はブラウザベースのチャットUIを用意すると利用しやすくなります。
たとえばOllamaとOpen WebUIを組み合わせれば、ローカルで実行しているモデルをブラウザから操作する環境を構築できます。
業務システムへ組み込む場合は、推論エンジンをAPIとして提供し、社内アプリや既存システムから呼び出す構成も考えられます。
ローカルLLMを単体で終わらせず、業務ツールに統合したい場合は、生成AIシステム開発の観点も重要になります。
6. 動作確認と性能調整を行う
最後に、実際の利用条件に近い状態で動作確認を行います。
確認したいのは、回答内容だけではありません。
応答速度、メモリ使用量、同時利用時の安定性、長文入力時の挙動、エラー発生時の復旧方法なども確認します。
業務利用では、自社の実際の質問や文書を使って評価し、必要に応じてモデル、量子化方式、コンテキスト長、推論設定などを調整します。
「モデルが起動したか」ではなく、「実際の業務条件で必要な品質と速度を満たせるか」まで確認して、はじめて構築可否を判断できます。
代表的な構成パターン
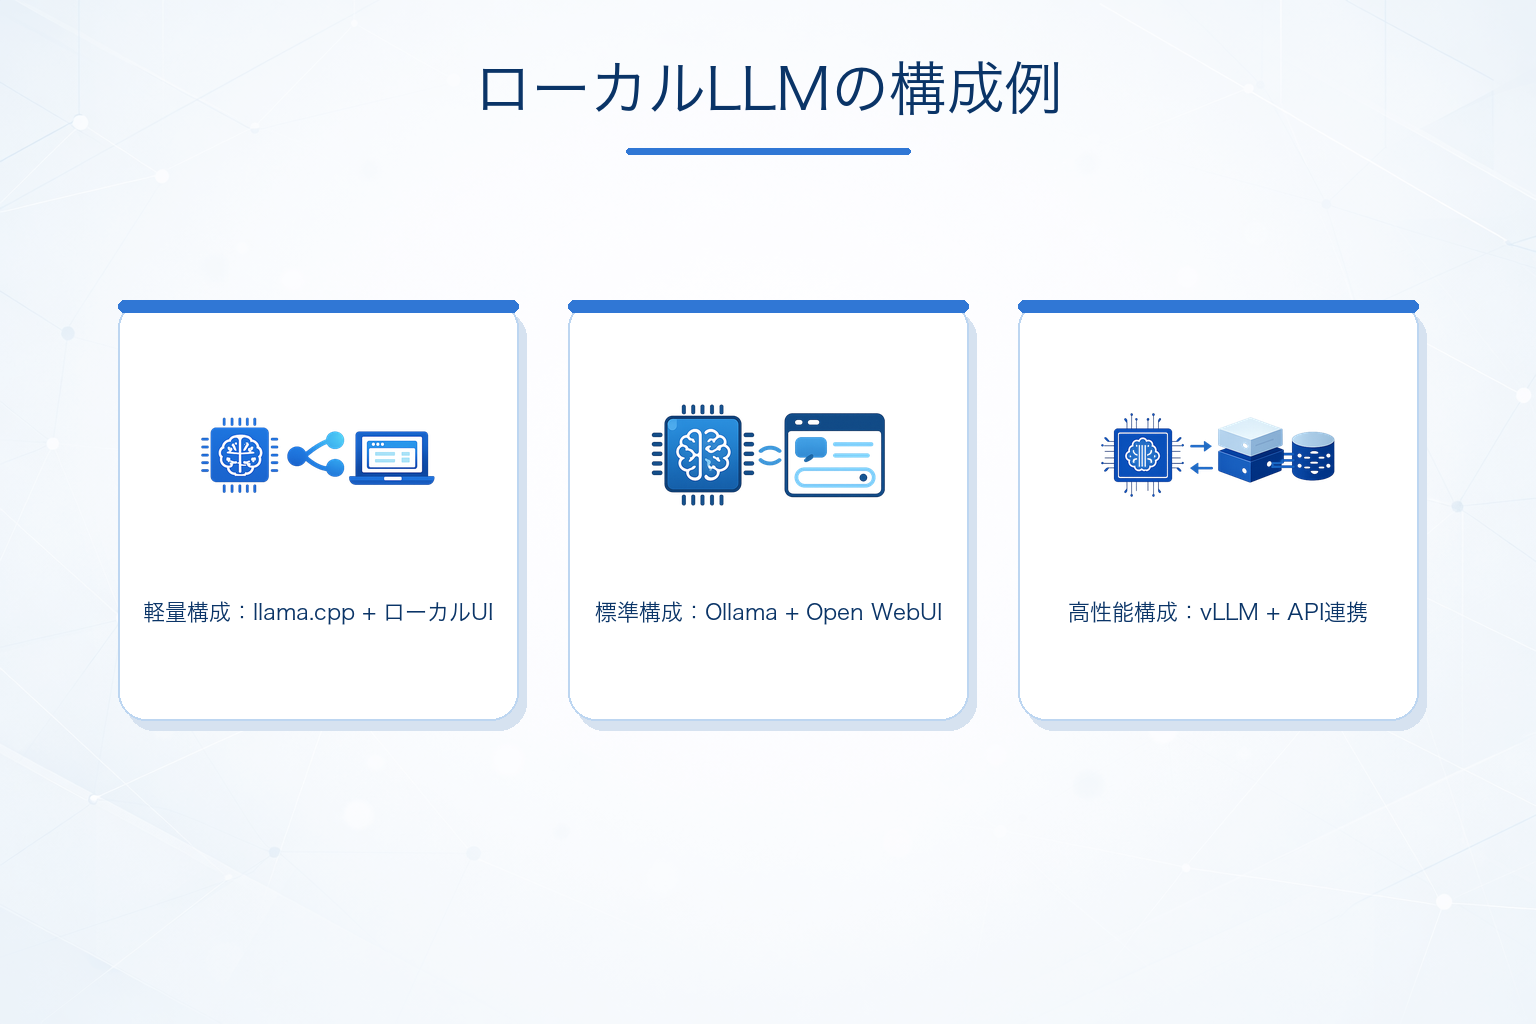
ローカルLLMにはさまざまな構築方法があるため、単純な性能の高低ではなく、用途に合わせて構成を選ぶことが重要です。
ここでは代表的な3つのパターンを紹介します。
個人検証向け:llama.cpp
手元のPCで量子化モデルを試したい場合などに使いやすい構成です。
llama.cppはCPUを含む幅広い環境でLLMを実行でき、GPUを利用した高速化にも対応しています。
量子化されたモデルを使ってメモリ使用量を抑えながら実行できるため、個人PCでローカルLLMを試したい場合にも候補になります。
モデルの挙動確認、量子化方式の比較、ローカルアプリへの組み込みなど、柔軟に検証したい場合と相性があります。
手軽なチャット環境:Ollama + Open WebUI
ローカルLLMをブラウザから手軽に利用したい場合に考えやすい構成です。
Ollamaでモデルの取得・管理・実行を行い、Open WebUIを接続することで、ブラウザベースのチャット環境を構築できます。
コマンドライン操作に慣れていない利用者でも触りやすくなるため、個人利用だけでなくチーム内でのPoCにも利用できます。
複数のモデルを試しながら現場の利用感を確認したい場合にも向いています。
APIサーバー・複数ユーザー向け:vLLM
自社アプリや複数ユーザーからLLMを利用する場合は、推論モデルをAPIとして提供する構成が必要になることがあります。
vLLMは高スループットなLLMサービングを目的とした推論・サービングエンジンで、API経由で複数のアプリケーションから利用する構成などで候補になります。
利用人数が増えるほど、単にモデルが動くことだけでなく、同時リクエストへの対応やGPUメモリの効率的な利用、監視なども重要になります。
そのため、個人検証からいきなりvLLM環境を構築するのではなく、利用人数や処理量などの要件が固まってから検討する方法もあります。
また、社内文書を参照して回答させる用途では、社内RAGと組み合わせることで、社内データを利用した回答基盤へ発展させることもできます。
ローカルLLMの活用例
ローカルLLMはチャット用途だけでなく、さまざまな形で活用できます。
- 個人開発での実験・学習
- 社内チャットボット
- コード補完や開発支援
- 社内文書検索や要約
- 定型文作成やナレッジ支援
- 閉域環境でのAI活用
個人開発では、モデルごとの応答差を試したり、プロンプト最適化やエージェント実装を試したりする土台として使えます。
外部APIを呼び出さずに反復検証できるため、モデルの挙動やローカル推論の仕組みを学ぶ用途にも向いています。
業務利用では、社内向けチャットや文書検索との相性がよく、規程類、マニュアル、議事録などを対象にした回答支援へ発展させることができます。
とくに、外部サービスへ送信したくない情報を扱う部署ではローカル実行を検討する意味があります。
開発部門ではコード補完、設計案のたたき台作成、ログ解析支援などへの活用も考えられます。
ただし、この場合はIDE連携やAPI化まで見据えて構成を選ぶ必要があります。
さらに、ローカルLLMは単体利用だけでなく、ワークフローや社内システムの一部として組み込むことで活用範囲を広げられます。
「チャットができる」で終わらせず、どの業務時間を減らすのか、どの判断を補助するのかまで設計することが重要です。
導入前に知っておきたい注意点
ローカルLLMは魅力的な選択肢ですが、導入前に確認しておきたい点も多くあります。
- 期待する精度がローカル環境で出るとは限らない
- ハードウェア投資だけでなく運用負荷もかかる
- 電力・冷却・保守を含めた総コストで考える必要がある
- モデルライセンスや利用条件の確認が必要
- 業務利用では権限管理や監査ログも重要になる
まず注意したいのは、クラウドの高性能モデルと同等の品質をそのままローカル環境で得られるとは限らないことです。
軽量化や量子化によってモデルを動かしやすくなる一方、用途によっては期待する精度を満たせない場合があります。
そのため、モデルのベンチマークだけで判断するのではなく、自社で実際に発生する質問やタスクを使って評価することが重要です。
また、ローカルLLMだからといってセキュリティ対策が不要になるわけではありません。
モデルへのアクセス権限、参照できる社内データ、ログの保存範囲、ネットワーク設定、管理者権限などを適切に設計する必要があります。
利用するモデルのライセンス確認も欠かせません。
モデルによって商用利用や再配布などの条件が異なるため、業務利用する場合は導入前に利用条件を確認しましょう。
費用は初期投資と運用コストの両方で考える
ローカルLLMのコストは、モデルサイズ、ハードウェア構成、利用人数、運用方法などによって大きく変わるため、一律の相場だけで判断するのは難しいでしょう。
オンプレミスで構築する場合は、GPUやサーバーなどの機材費だけでなく、ストレージ、ネットワーク、電力、冷却、バックアップ、監視、保守なども考慮する必要があります。
既存のPCやサーバーを利用して小規模に検証する場合と、複数ユーザー向けにGPUサーバーを新設する場合では、必要な投資は大きく異なります。
一方、クラウド上に専用GPU環境を用意してモデルを実行する場合は、大きな初期設備を用意せず始めやすい反面、GPUインスタンスの利用時間、ストレージ、通信、監視などに応じた継続費用が発生します。
オンプレミスとクラウドのどちらが低コストになるかは、利用頻度、必要なGPU性能、同時利用者数、運用期間などによって変わります。
そのため、PoCでは実際の処理量やGPU使用率を確認し、本番時の利用量を試算したうえで構成を決めることが重要です。
また、初期費用だけでなく、モデル更新、障害対応、ログ管理、バックアップなどの運用作業も継続します。
とくに業務システムとして利用する場合は、障害時の復旧方法や代替手段まで含めて設計しておきましょう。
ローカルLLMに関するよくある質問
Q.1 ローカルLLMは何に使えますか?
ローカルLLMは、チャット、文書要約、社内ナレッジ検索、コード補完、定型文作成、ログ解析支援などに活用できます。
とくに、機密情報を外部APIへ送らずに扱いたい場面や、ネットワークが制限された環境で生成AIを使いたい場合に検討しやすい方式です。
Q.2 個人開発でもローカルLLMを構築する意味はありますか?
あります。個人開発では、モデルの挙動、量子化による違い、ローカルアプリとの連携などを自由に検証できます。
最初から大規模な環境を用意する必要はなく、手元のPCで動かせる軽量モデルから始めると全体像をつかみやすくなります。
Q.3 どのくらいのVRAMが必要ですか?
必要なVRAMやメモリ容量は、モデルのパラメータ数、量子化方式、コンテキスト長、同時利用者数、推論エンジンなどによって変わります。
モデルの重みだけを単純計算すれば、4bit量子化では1パラメータあたり約0.5バイトが目安になりますが、実際にはKVキャッシュやランタイムなどの領域も必要です。
また、Apple SiliconではCPUとGPUがユニファイドメモリを共有するため、独立GPUのVRAM容量だけで比較することはできません。
固定的な必要容量だけで判断するのではなく、利用予定のモデルと推論エンジンで実測するのが確実です。
Q.4 OllamaとvLLMはどう違いますか?
Ollamaはモデルを取得・管理し、ローカル環境で比較的手軽に実行したい場合に利用しやすいツールです。
一方、vLLMは高スループットなLLMサービングを目的としており、APIサーバーとして複数のアプリやユーザーから利用する構成などで候補になります。
単純にどちらが高性能かで選ぶのではなく、個人検証、チャット利用、API連携、複数ユーザー利用など、目的に応じて選ぶことが重要です。
Q.5 クラウドLLMよりローカルLLMが有利なのはどんな場面ですか?
外部サービスへデータを送信したくない業務、閉域環境での利用、モデルや実行環境を自社で細かく管理したい場合などでは、ローカルLLMを検討するメリットがあります。
一方で、最新モデルの性能をすぐ利用したい場合や、インフラの管理負担を抑えたい場合にはクラウドLLMが適していることもあります。
セキュリティ、性能、運用負荷、コストなどを比較して判断することが大切です。
ローカルLLM構築を自社要件に合わせて進めよう
ローカルLLMの構築で大切なのは、単に「ローカルで動かすこと」ではなく、何の業務に使い、どの水準の性能と安全性が必要なのかを先に決めることです。
高性能な構成ほどよいとは限らず、用途に対して過剰な投資になるケースもあります。
実際には、モデルサイズ、量子化、推論エンジン、UI連携、RAGの有無、利用人数、運用体制によって最適な構成は変わります。
個人検証向けの軽量構成と、複数ユーザーへの提供を前提にしたAPIサーバー構成では、必要なハードウェアや設計も大きく異なります。
検討時には、モデルとメモリ要件、同時利用者数、応答速度、初期費用と運用費、セキュリティと権限管理を重点的に確認しておきたいところです。
まずは小規模なPoCで業務適合性を確かめ、実際の応答品質、速度、メモリ使用量などを確認したうえで、本番構成へ広げる進め方が現実的です。
自社だけで設計や検証を進めるのが難しい場合は、ローカルLLMや生成AI基盤に詳しい専門家へ相談する選択肢もあります。
要件整理、モデル選定、構成設計、RAG連携、運用ルール整備まで支援を受けられれば、過剰投資や構築後のやり直しを減らしやすくなるでしょう。
エラビサキでは、AI開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。