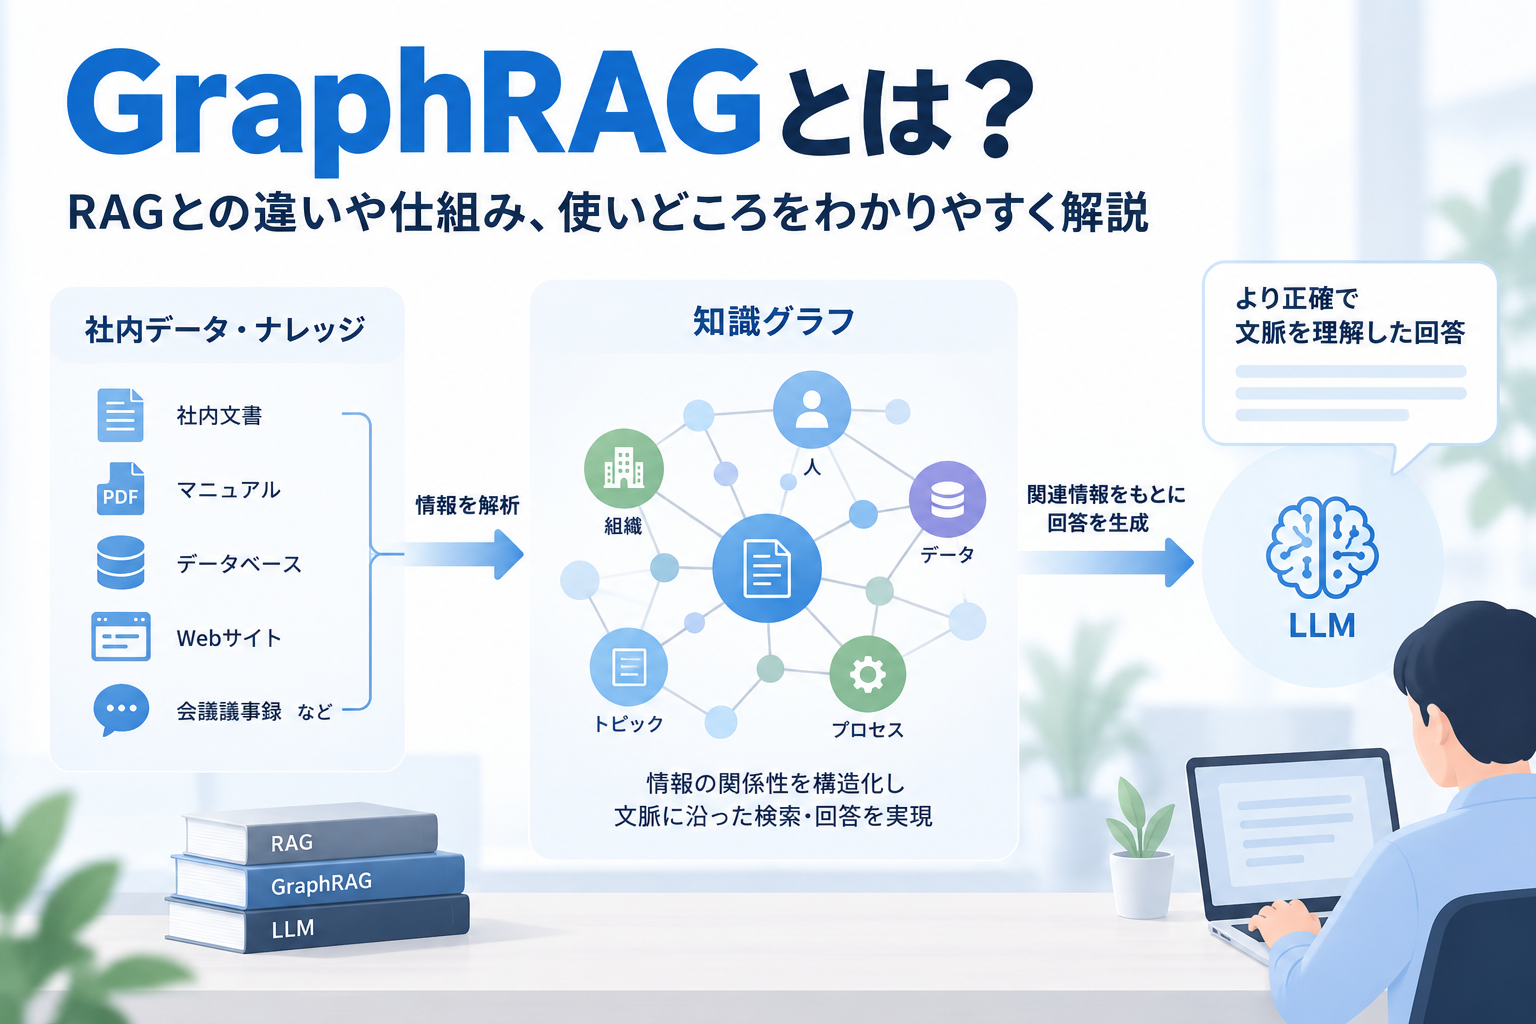
GraphRAGとは?RAGとの違いや仕組み、使いどころをわかりやすく解説
GraphRAGは、通常のRAGでは拾いにくい「情報同士のつながり」まで踏まえて回答したいときに検討されるアプローチです。
社内文書や議事録、報告書、仕様書、問い合わせ履歴など、情報が複数の文書に分散している場合、「従来のRAGと何が違うのか」「本当にGraphRAGが必要なのか」「構築や運用はどこまで重くなるのか」と疑問を持つ担当者も少なくありません。
こちらの記事では、GraphRAGの基本概念から従来RAGとの違い、仕組み、向いているユースケース、メリット・デメリット、費用、導入判断のポイント、実装イメージまでを整理します。自社で採用すべき技術か見極めたい方は、順番に確認していきましょう。
GraphRAGとは
GraphRAGとは、検索拡張生成であるRAGに、知識グラフやグラフ構造の考え方を組み合わせた手法です。
通常のRAGでは、質問に近い文書やチャンクをベクトル検索で取り出し、その内容をもとにLLMが回答します。
これに対してGraphRAGでは、文書中のエンティティや概念、それらの関係性をノードとエッジとして整理し、単なる類似検索だけでなく、情報のつながりをたどりながら回答を組み立てるのが特徴です。
たとえば「ある製品で発生している不具合が、どの顧客、どの部門、どの過去施策と関係しているか」を横断的に見たい場面では、個別文書の一致だけでは十分でないことがあります。
そのような場合、GraphRAGは関係性を明示的に扱えるため、複数資料をまたぐ要約や関連性の把握に向きやすくなります。
ただし、すべてのRAGをGraphRAGに置き換えるべきというわけではありません。ベースとなるRAGの考え方を整理したい場合は、RAG 構築もあわせて確認しておくと理解しやすくなります。
GraphRAGと従来RAGの違い
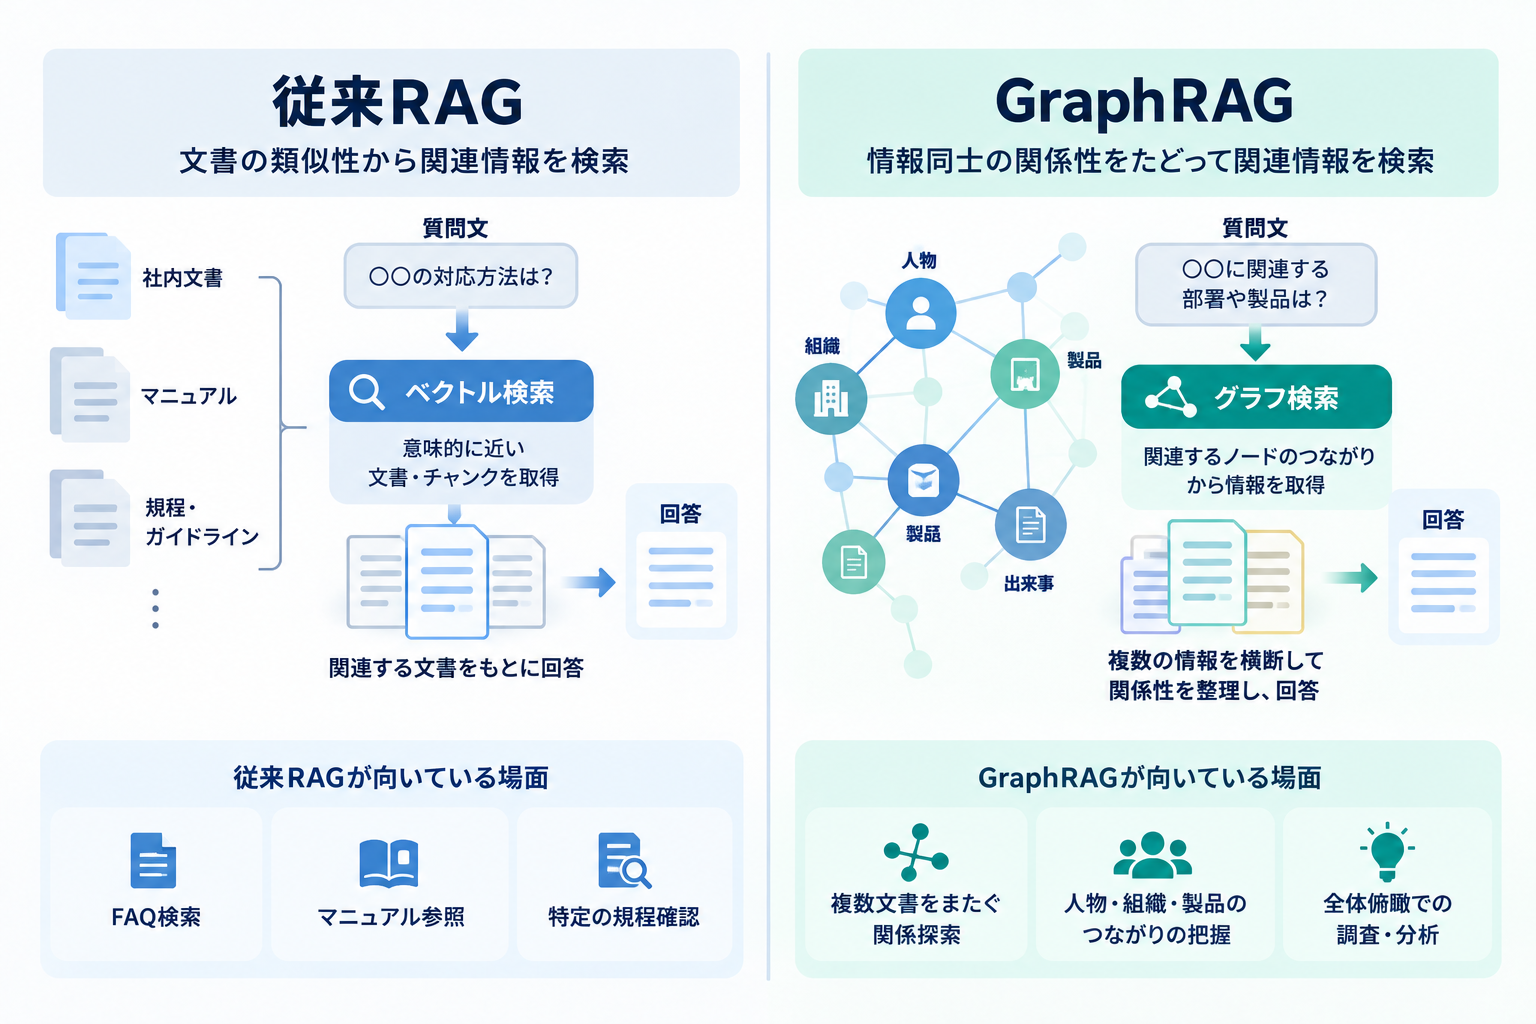
GraphRAGと従来RAGの違いは、検索対象を「文書の類似性」中心で見るか、「情報同士の関係性」まで含めて扱うかにあります。
従来RAGは、質問文と意味的に近いチャンクを見つけるのが得意です。そのため、FAQ検索、マニュアル参照、特定の規程確認のように、答えが比較的はっきりした問い合わせには適しています。
一方でGraphRAGは、関係する人物、組織、製品、課題、出来事などをグラフとして保持し、複数のノード間のつながりをもとに回答候補を集めます。その結果、複数文書を横断して情報の関係を整理しやすくなります。
| 観点 | 従来RAG | GraphRAG |
|---|---|---|
| 検索の考え方 | ベクトル検索で近い文書・チャンクを取得 | グラフ上の関係性をたどって関連情報を取得 |
| 得意な質問 | 単一文書で答えやすい事実確認 | 複数文書をまたぐ関係探索や横断要約 |
| 文脈の扱い | 局所的な関連文脈が中心 | 全体構造や周辺関係まで扱いやすい |
| 構築の複雑さ | 比較的シンプル | グラフ生成や更新設計が必要 |
| 向いている場面 | まずRAGを早く導入したい場合 | 関係性理解が価値に直結する場合 |
「検索精度を少し上げたい」程度であれば従来RAGで十分なことも多く、GraphRAGは関係性の把握が成果に直結するかどうかで判断するのが現実的です。
GraphRAGは全体俯瞰や複数情報の関係探索に強みがある一方、そのぶん前処理やインデックス設計は複雑になりやすい傾向があります。
GraphRAGの仕組み
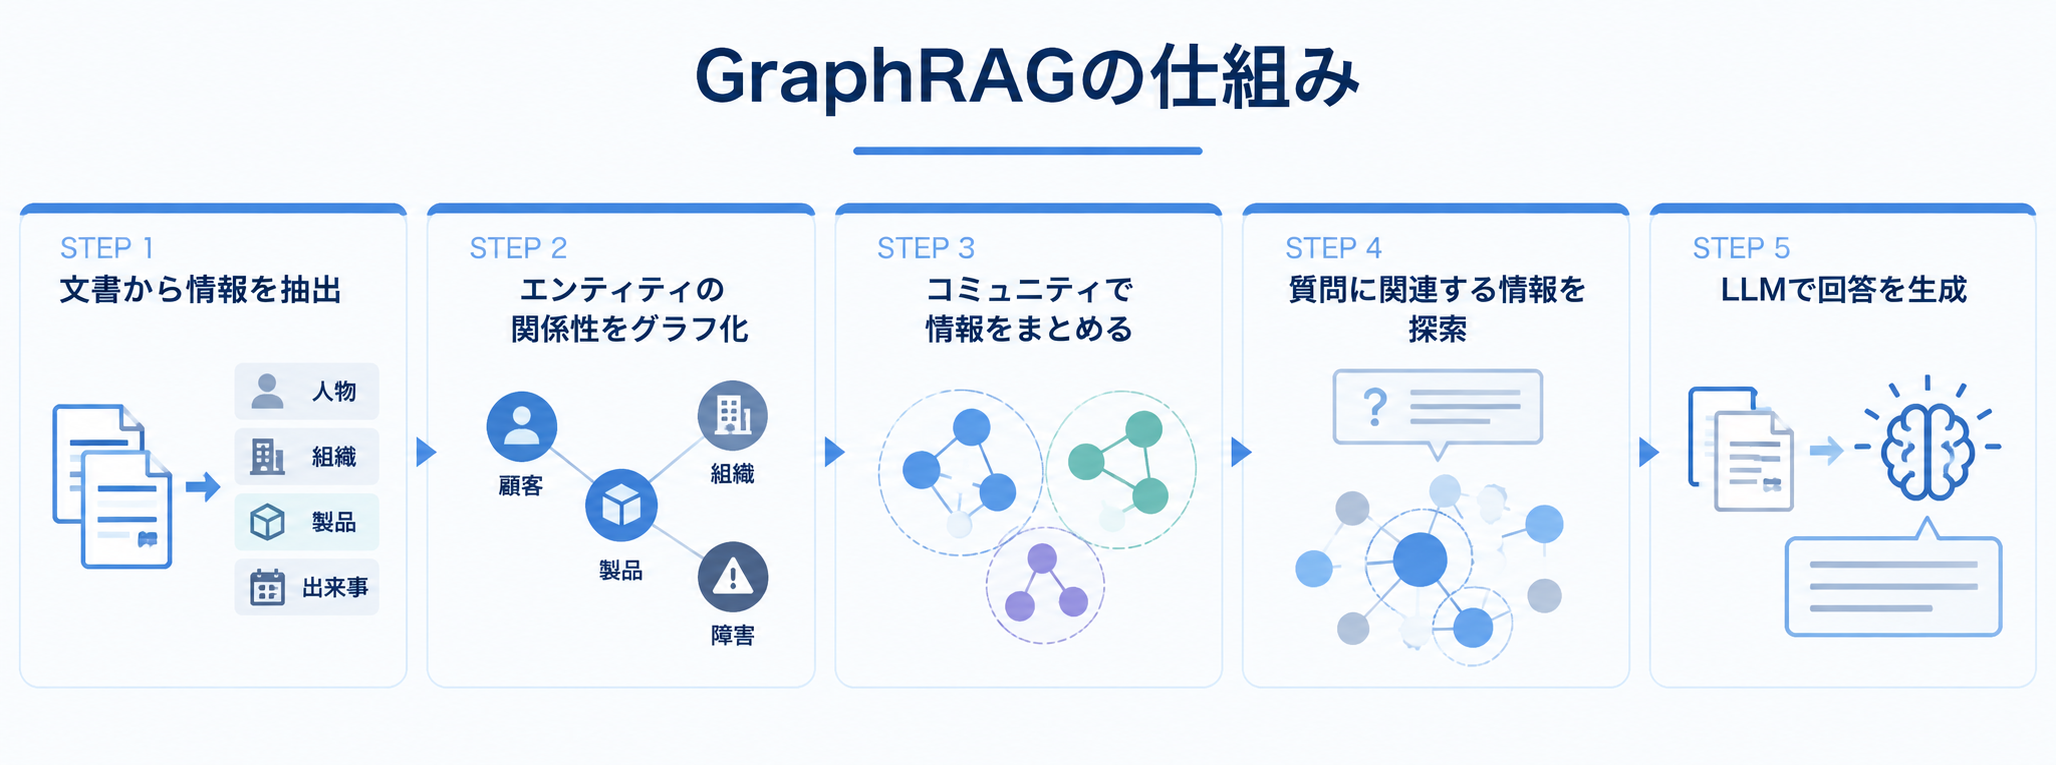
GraphRAGでは、文書から人物、組織、製品、出来事などのエンティティと、それらの関係性を抽出してグラフとして整理します。
たとえば、「製品A」「顧客B」「障害C」という情報が別々の文書に記載されていても、「顧客Bが製品Aを利用している」「製品Aで障害Cが発生した」といった関係をグラフとして結び付けることで、情報同士のつながりを探索できるようになります。
さらに、関連するノード群をコミュニティとしてまとめ、テーマごとの要約情報を作成する方法もあります。これにより、個々の文書だけではなく、データ全体に存在するテーマや関係を把握しやすくなります。
質問を受けた際には、質問に関連するノードやコミュニティを探索し、周辺の情報を集めます。その情報をLLMへ渡して回答を生成することで、単純な類似チャンク検索よりも、複数の情報のつながりを踏まえた回答を目指せます。
つまり、従来RAGが「質問に近い文章を探す」ことを中心とするのに対し、GraphRAGは「質問に関係する情報と、そのつながりを探す」という考え方を取り入れている点が大きな違いです。
GraphRAGが向いているユースケース
GraphRAGが向いているのは、複数の情報源をまたいで関係性を読み解く必要があるケースです。
単純な文書検索よりも、「点」と「点」をつないで意味を取り出したい場面で力を発揮しやすくなります。
- 部門横断のナレッジ検索
- 障害やインシデントの原因関係の整理
- 顧客、案件、製品、問い合わせ履歴を横断した分析
- 法務・規程・契約情報の関係把握
- 研究開発や技術文書の概念マップ化
- 経営会議資料やレポートの全体俯瞰
たとえば社内ナレッジ活用では、ある制度改定がどの業務フロー、どの部門、どの過去決定と関係しているかを横断的に確認したいことがあります。
そのような用途では、社内 RAGの発展形としてGraphRAGを検討する余地があります。
また、問い合わせ対応や保守運用では、「この不具合と似た現象は過去にどの顧客で起き、どの設定変更が影響したのか」といった探索型の質問が出やすいものです。
この種の質問は、単一文書に答えがまとまっていないことが多く、GraphRAGの適性が比較的高いでしょう。
一方で、社内規程の条文確認や製品マニュアルの一問一答のように、答えが局所的で明確なケースでは、従来RAGで十分な場合も少なくありません。
ユースケースの具体像を広く確認したい場合は、RAG 活用事例も参考になります。
GraphRAGのメリット
GraphRAGのメリットは、単なる検索結果の羅列ではなく、情報の構造を踏まえて回答しやすい点にあります。
とくに、複数文書をまたぐ業務知識の扱いでは差が出やすくなります。
- 情報の全体像を把握しやすい
- 関係性を前提にした検索・要約に向く
- 複数段階の情報探索が必要な質問に対応しやすい
- 関連トピックを横断的に探索しやすい
- テーマ単位の要約や俯瞰がしやすい
従来RAGでは、類似度の高いチャンクを複数取得できても、それぞれがどのように関係しているのかを検索段階で明示的に扱うとは限りません。
GraphRAGでは、あらかじめエンティティ同士の関係を構造化することで、関連情報をたどりながら回答に必要な文脈を集めやすくなります。
また、経営・法務・研究開発のように、個別の文章だけではなく「全体として何が起きているか」を把握することが重要な領域では、GraphRAGを検討する価値があります。
個別の事実検索だけでなく、横断要約や背景整理まで求める場合は、GraphRAGを採用する意義が大きくなります。
GraphRAGのデメリット・課題
GraphRAGには利点がある一方で、導入負荷も無視できません。
とくに、従来RAGより前処理と運用設計が複雑になりやすい点は、事前に理解しておく必要があります。
- 初期構築が複雑になりやすい
- エンティティ抽出や関係抽出の品質に左右される
- データ更新時の再構築や差分更新が課題になりやすい
- グラフDBなど追加インフラが必要になることがある
- 構築時・検索時のLLMコスト設計が必要
- PoCでは効果が見えても本番運用で負荷が増えやすい
GraphRAGでは、文書を入れれば自動で高品質な知識グラフが完成するわけではありません。
抽出したエンティティの粒度が粗すぎたり、関係定義が曖昧だったりすると、検索結果に不要な情報が含まれやすくなる可能性があります。
また、文書更新が頻繁な環境では、グラフの再構築タイミングや差分更新方法まで含めて運用設計しないと、保守負荷が大きくなるでしょう。
導入失敗を防ぐには、回答品質の検証だけでなく「更新運用まで継続して回せるか」を早い段階で確認することが大切です。
GraphRAGの費用
GraphRAGの費用については、公開情報の多くが特定環境での実測値やクラウド構成に依存しており、一般的な市場相場として一律にまとめるのは難しい状況です。
そのため、導入判断では単純な金額相場よりも、どの処理や基盤で費用が発生するのかという「費用構造」を把握する方が実務的です。
- LLM API従量課金型:エンティティ抽出、コミュニティ要約、クエリ生成などでトークン課金が発生する形です。
- インデックス/構築単位課金型:初回構築や再構築、差分更新のたびに費用が発生します。
- グラフデータベース運用費型:NeptuneやNeo4jなどを常時稼働させる場合の基盤コストです。
- クラウド環境時間課金型:検証環境や分析基盤を立ち上げている時間に応じて課金される形です。
- 個別見積もり型:導入規模、利用モデル、更新頻度、精度要求に応じて金額が変動します。
費用を左右しやすい要因としては、ドキュメント件数、チャンク数、使用するLLMの単価、コミュニティ要約の生成有無、再構築頻度、グラフDBの運用方法などが挙げられます。
フル機能のGraphRAGにするのか、対象範囲を限定した軽量な構成で始めるのかによっても、必要な処理量や運用負荷は変わります。
見積もりを取る際は、初回構築費と更新費が分かれているか、構築時API費用と検索時API費用が別建てか、グラフDBの運用費が含まれているかを確認しておきたいところです。
さらに、PoC用データ件数と本番件数を分けて試算しているか、人手レビューや知識グラフ品質改善の工数が見積もりに含まれているかも重要です。
GraphRAGを導入すべきか判断するポイント
GraphRAGを導入すべきかどうかは、技術の新しさではなく、自社の質問パターンとデータ構造で判断するのが基本です。
次の観点を整理すると、従来RAGで十分か、GraphRAGが必要かを見極めやすくなります。
- 回答に複数文書の関係整理が必要か
- 全体俯瞰や横断要約のニーズが強いか
- エンティティ間の関係が業務上重要か
- データ更新頻度に運用が耐えられるか
- PoCで関係探索の効果を測定できるか
- まず従来RAGから始める余地があるか
もし質問の大半が「この規程の該当条文はどこか」「この手順書の設定値は何か」といった単一事実検索であれば、GraphRAGを導入しても追加の構築・運用負荷に見合う効果が得られない可能性があります。
反対に、「A案件の遅延要因は、どの部門、どの意思決定、どの過去トラブルとつながっているか」のような関係探索が多いなら、GraphRAGを検討する余地が大きくなります。
最初から全面移行するより、従来RAGで限界が出ている質問タイプを特定し、その領域だけGraphRAGでPoCする進め方が現実的です。
導入の進め方そのものを整理したい場合は、RAG 導入方法も役立ちます。
GraphRAGの実装イメージと関連技術
GraphRAGを実際に構築する場合は、データ処理からグラフ構築、検索、評価、更新までを一連のパイプラインとして設計する必要があります。
ここでは、前述したGraphRAGの回答原理ではなく、システムとして構築・運用する際の流れを整理します。
- 対象データとGraphRAGで解決したい質問を決める
- データを収集し、文書分割やメタデータ整理を行う
- LLMや抽出器でエンティティと関係を抽出する
- 知識グラフを構築して保存する
- グラフ探索と必要に応じたベクトル検索を組み合わせる
- 取得した情報をLLMへ渡して回答を生成する
- 回答品質を評価し、抽出・探索方法を改善する
- データ追加・更新に対応する運用フローを設計する
関連技術としては、LLM、ベクトル検索基盤、グラフデータベース、ETL処理、評価基盤などが関わります。
保存先にはNeo4jやNeptuneのようなグラフDBが使われることがあります。また、GraphRAGだからといってベクトル検索が不要になるとは限らず、用途に応じてグラフ探索とベクトル検索を組み合わせる構成も考えられます。
実装時に重要なのは、単に利用技術を決めることではなく、「何をノードにするか」「どの関係を重要とみなすか」「どの質問をGraphRAGで改善したいか」を先に定義することです。
さらに、本番運用を想定する場合は、データが追加・変更された際にグラフ全体を再構築するのか、差分更新するのか、抽出結果を人がレビューするのかといった運用方法も決める必要があります。
PoCでは、従来RAGとGraphRAGへ同じ質問セットを与え、回答品質や必要な情報の取得率などを比較すると、GraphRAGを追加する価値を判断しやすくなります。
標準的なRAGの設計フローを先に確認したい場合は、RAG 作り方もあわせて読むと、GraphRAGで追加される設計・運用上の論点を整理しやすくなります。
GraphRAGに関する質問
Q.1 GraphRAGとは何ですか?
GraphRAGは、RAGに知識グラフの考え方を組み合わせた手法です。文書内の概念やエンティティ、その関係性をグラフとして整理し、質問時にそのつながりをたどりながら回答を生成します。単なる類似文書検索よりも、複数情報の関係を踏まえた回答に向きやすいのが特徴です。
Q.2 GraphRAGと通常のRAGの違いは何ですか?
通常のRAGは、質問に近い文書やチャンクをベクトル検索で取り出す考え方が中心です。一方、GraphRAGは情報同士の関係性を構造化し、その関係を探索して回答を組み立てます。そのため、単一文書の参照なら通常のRAGで十分なこともありますが、複数文書をまたぐ横断要約や関係探索ではGraphRAGが向く場合があります。
Q.3 GraphRAGはどんな質問に強いですか?
複数の情報源をまたいで関連性を整理したい質問に向いています。たとえば、ある障害に関連する部門や製品、過去の対応履歴を横断して確認したい場合や、複数の資料からあるテーマの全体像を整理したい場合です。反対に、単純な事実確認だけなら従来RAGの方がシンプルに運用しやすいこともあります。
Q.4 どんなケースでは従来RAGで十分ですか?
FAQ、手順書参照、規程確認、製品マニュアル検索のように、答えが局所的な文書にまとまっているケースでは従来RAGで十分なことが多いです。GraphRAGは関係性を扱える反面、構築や更新の負荷が増えるため、その追加コストに見合う課題があるかを見極める必要があります。
Q.5 GraphRAGの導入は何から始めるべきですか?
まずは自社で扱いたい質問を整理し、従来RAGで答えにくいパターンが本当に情報同士の関係性に起因しているのかを確認することが重要です。そのうえで、小規模データを使ったPoCを行い、回答品質だけでなく、グラフ更新の運用負荷や費用構造まで検証すると判断しやすくなります。
GraphRAGを導入すべきか、質問とデータ構造から見極めよう
GraphRAGを検討するときに大切なのは、新しい手法だから採用するのではなく、自社の課題が「情報同士の関係性を十分に扱えないこと」にあるのかを見極めることです。
単一文書の検索やFAQ対応が中心なら、従来RAGの方がシンプルで運用しやすい可能性があります。一方で、複数文書をまたぐ横断要約や部門横断の知識探索などでは、GraphRAGを検討する価値があります。
導入判断では、どんな質問に答えたいのか、情報同士の関係が成果に直結するのか、更新運用まで含めて継続できるのかを確認しましょう。
費用面でも、単純な導入価格だけではなく、構築時の抽出処理、グラフの更新・再構築、グラフDBの運用、回答品質の評価・改善に必要な工数まで視野に入れる必要があります。
まずは自社で想定する質問パターンを棚卸しし、従来RAGでは十分に回答できないケースを明確にしたうえで、小規模なPoCから検証するのが進めやすいでしょう。
自社だけでGraphRAGの設計や検証を進めるのが難しい場合は、RAGや知識検索の実装経験がある外部パートナーへ相談する方法もあります。
エラビサキでは、RAG開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。