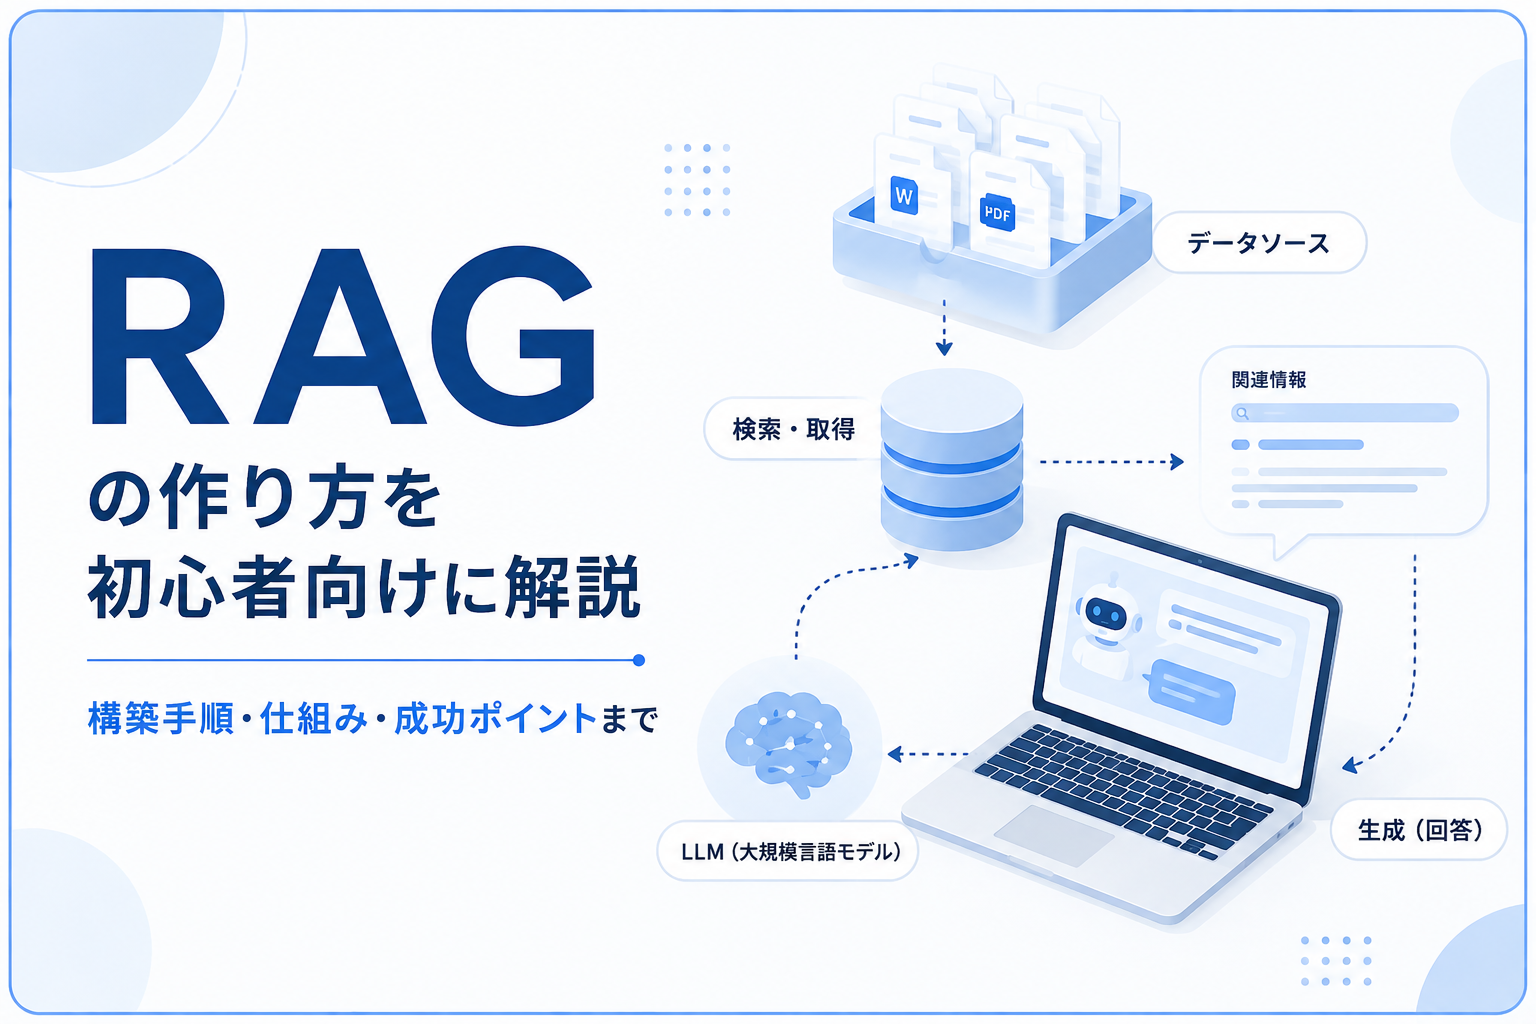
RAGの作り方を初心者向けに解説|構築手順・仕組み・成功ポイントまで
RAGを作ってみたいと思っても、最初は「何から手を付ければいいのか」が見えにくいものです。
生成AIに社内文書や業務マニュアルを参照させたい、FAQの回答精度を上げたい、といった場面でRAGは有力な選択肢になりますが、単にLLMをつなぐだけでは期待した精度にはなりません。
実際には、データの準備、文書の分割、ベクトル化、検索設計、回答生成、改善運用まで、一連の流れを押さえて設計する必要があります。
また、RAGとファインチューニングの違い、チャンク分割の考え方、精度を高めるコツ、導入時のコスト感など、構築前に整理しておきたい論点も少なくありません。
この記事では、RAGの基本的な仕組みから、ゼロから作るときの全体像、各工程の実務上の考え方、費用の目安、活用事例までを初心者向けに順を追って解説します。
RAGとは
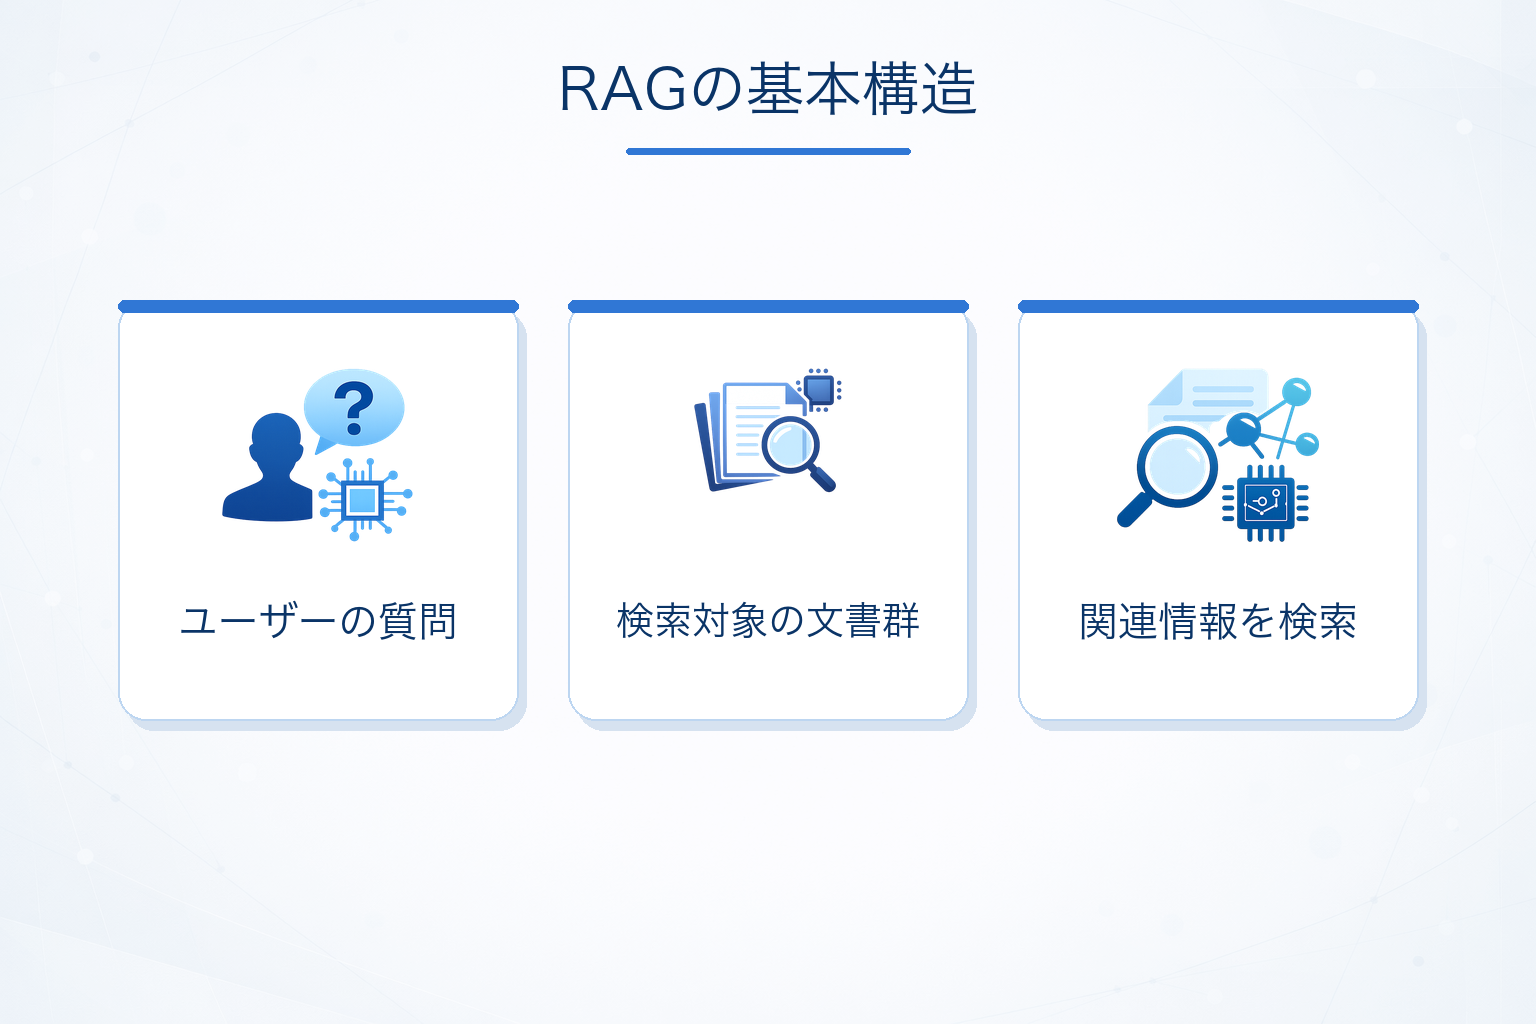
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と呼ばれます。
簡単に言えば、LLMが回答を作る前に、外部の文書やデータベースから関連情報を検索して、その内容を踏まえて回答する仕組みです。
通常のLLMは、学習済みの知識だけをもとに回答するため、社内の最新資料や独自ルールのような情報には弱い傾向があります。
一方でRAGを使えば、社内マニュアル、規程集、製品仕様書、ナレッジベースなどを検索対象にできるため、回答の根拠を業務データに寄せやすくなります。
この仕組みが役立つのは、情報の更新頻度が高い場面や、一般知識ではなく自社固有の情報を参照させたい場面です。
たとえば社内ヘルプデスク、営業支援、問い合わせ対応、法務・人事の社内照会などでは、RAGの有効性を実感しやすいでしょう。
ただし、RAGは「検索すれば何でも正しく答えられる」魔法の仕組みではありません。
元データの質、チャンク分割の設計、検索精度、プロンプト設計が噛み合ってはじめて、実務で使える回答品質に近づきます。
RAGとファインチューニングの違い
RAGと比較されやすいのが、ファインチューニングです。
どちらもLLMを業務に合わせて使う方法ですが、アプローチはかなり異なります。
RAGは、モデル自体を大きく作り替えるのではなく、外部データを検索して回答に反映させます。
つまり、知識をモデル内部へ覚え込ませるというより、必要なときに必要な情報を取り出して使う発想です。
一方でファインチューニングは、追加データを使ってモデルの振る舞いや出力傾向そのものを調整します。
そのため、特定の文体に寄せたい、分類精度を高めたい、決まった形式で出力させたい、といった用途ではファインチューニングが向くことがあります。
整理すると、最新情報や社内文書を参照させたいならRAG、回答スタイルや判定ロジックをモデル側で最適化したいならファインチューニング、という考え方が基本です。
社内ナレッジ検索や文書参照型のQAでは、まずRAGから検討するのが現実的でしょう。
なお、両者は排他的ではありません。
実務ではRAGをベースにしつつ、一部タスクだけファインチューニングを組み合わせる構成もあり得ます。
RAGの作り方の全体像
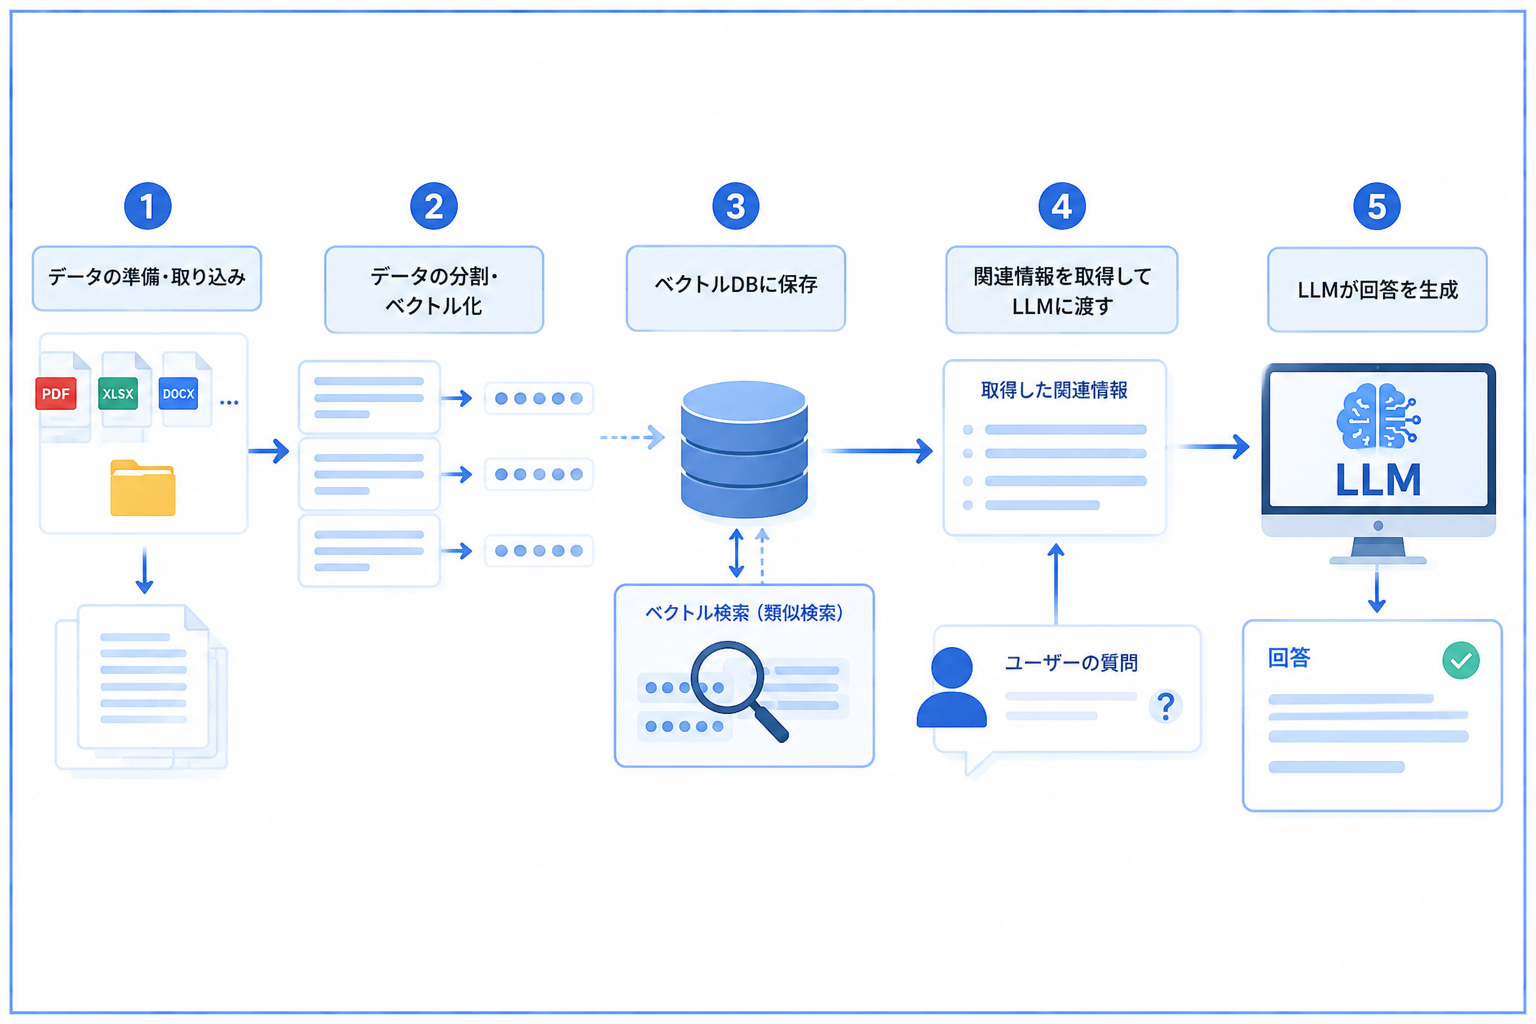
RAGは、次のような流れで構築するのが一般的です。
- 目的とユースケースを定める
- 検索対象となるデータを集める
- 文書を分割してチャンクを設計する
- 文書をベクトル化する
- ベクトルデータベースへ格納する
- 質問文をもとに関連情報を検索する
- 検索結果をLLMへ渡して回答を生成する
- 評価と改善を繰り返す
この流れの中で、とくに見落とされやすいのが「評価と改善」です。
RAGは一度作って終わりではなく、実際の質問ログや回答ミスを見ながら、検索条件やチャンク設計を調整していくことで精度が上がります。
また、最初から全社展開を目指すより、対象業務を絞ったPoCから始めるほうが進めやすいケースも多くあります。
たとえば「人事規程だけを対象にした社内問い合わせ対応」や「製品マニュアル検索だけを対象にしたサポート支援」のように、範囲を限定すると改善サイクルを回しやすくなります。
RAGに使うデータを準備する
RAGの品質は、土台となるデータの品質に大きく左右されます。
そのため、最初に考えるべきなのはモデル選びではなく、どの文書を検索対象にするかです。
候補になるのは、社内マニュアル、FAQ、議事録、規程類、製品仕様書、提案書テンプレート、ナレッジ記事などです。
ただし、何でも入れればよいわけではありません。
古い版の文書、内容が矛盾している資料、OCR精度の低いPDF、見出し構造が崩れたファイルをそのまま取り込むと、検索結果のノイズが増えます。
まずは、対象業務に本当に必要なデータソースを絞り込みましょう。
そのうえで、最新版かどうか、権限上問題なく利用できるか、情報の粒度が揃っているかを確認する必要があります。
データ準備では、次の点を確認しておくと進めやすくなります。
- 対象ユースケースに直結する文書だけを選ぶ
- 重複文書や旧版を整理する
- PDF、Office文書、画像など形式の違いを把握する
- OCRやテキスト抽出の品質を確認する
- 見出し、章立て、作成日、文書種別などのメタデータを整える
- アクセス権限の扱いを決める
RAGの精度改善はモデル側より先に、データの整理で大きく伸びることが少なくありません。
とくに業務文書は、AI以前に文書管理そのものが整っていないケースもあるため、データ整備を別工程として見積もる発想が大切です。
文書を分割してチャンク設計を行う
RAGでは、長い文書をそのまま検索対象にするのではなく、小さな単位に分割して扱うのが一般的です。
この分割単位を「チャンク」と呼びます。
チャンク設計が重要なのは、検索で取り出される情報の精度に直結するからです。
1つのチャンクが長すぎると、関係ない情報まで一緒に取得されやすくなります。
逆に短すぎると、文脈が切れてしまい、LLMが正しく理解しにくくなることがあります。
そのため、単純に文字数だけで切るより、見出しや段落、Q&A単位、手順単位など、意味のまとまりを意識して分割することが重要です。
たとえばFAQなら「質問1件ごと」、業務手順書なら「1工程ごと」、規程集なら「条文や章ごと」に近い形で分けると扱いやすくなります。
また、前後の文脈が必要な文書では、チャンク同士に少し重なりを持たせる設計も有効です。
チャンク設計で見たい観点は、次の通りです。
- 質問に答えるのに十分な情報量が1チャンクに含まれているか
- 無関係な話題が1チャンクに混ざっていないか
- 見出しや節の構造を活かせているか
- チャンク間の重なりが必要か
- 回答根拠として表示しやすい単位になっているか
ここは初心者がつまずきやすい工程ですが、正解が1つに決まっているわけではありません。
小さく作って評価し、実際の質問でどの単位が当たりやすいかを見ながら調整するのが現実的です。
ベクトル化してベクトルデータベースに格納する
チャンク化した文書は、そのままでは意味の近さで検索しにくいため、埋め込みモデルを使ってベクトル表現へ変換します。
これが「ベクトル化」です。
ベクトル化すると、文章同士の意味的な近さを数値的に扱えるようになります。
その結果、質問文と意味の近いチャンクを検索しやすくなります。
変換したベクトルは、ベクトルデータベースに保存します。
ベクトルデータベースは、大量のベクトルを高速に検索するための仕組みで、RAGの検索基盤にあたります。
ここで重要なのは、ベクトルだけを保存するのではなく、元のテキストやメタデータも一緒に保持しておくことです。
文書タイトル、更新日、部署、カテゴリ、アクセス権限などを持たせておくと、検索結果の絞り込みや表示制御に役立ちます。
意味検索だけに頼らず、メタデータ検索と組み合わせる設計が実務では有効です。
たとえば「人事部の最新規程だけを対象にする」「製品Aのマニュアルだけを検索する」といった制御がしやすくなります。
また、文書更新時に再インデックスをどう行うかも設計しておきたいところです。
初回登録だけでなく、更新頻度が高い文書をどう反映するかまで考えておかないと、実運用で古い情報を返す原因になります。
検索した情報をLLMに渡して回答を生成する
RAGの中核は、検索で見つけた情報をLLMに渡し、その内容をもとに回答を作らせる流れにあります。
まず、ユーザーの質問をベクトル化し、ベクトルデータベースから関連性の高いチャンクを取り出します。
その後、取得したチャンクをプロンプトに埋め込み、LLMへ「この情報を参考に回答してください」と指示します。
このとき重要なのは、ただ検索結果を大量に渡すのではなく、必要な情報だけを整理して渡すことです。
関連性の低いチャンクが混ざると、回答がぼやけたり、誤った内容を混ぜたりしやすくなります。
また、プロンプトには回答方針も明記しておくと安定しやすくなります。
たとえば「根拠がない場合は不明と答える」「検索結果にない内容は推測しない」「回答の最後に参照文書名を出す」といったルールです。
検索から生成までの流れは、次のように整理できます。
- ユーザーが質問を入力する
- 質問文をベクトル化する
- 関連チャンクを検索する
- 必要に応じて再ランキングする
- 検索結果をプロンプトへ組み込む
- LLMが回答を生成する
- 必要なら根拠文書や引用箇所を提示する
ここで差が出やすいのは、何件のチャンクを渡すか、どの順番で渡すか、どこまで要約するかといった細かな設計です。
実際には、検索精度とプロンプト設計を一体で見直すことで、回答品質が大きく変わることがあります。
RAGの精度を高めるポイント
RAGの精度は、単一の工夫で劇的に改善するというより、複数の調整を積み重ねて高めていくものです。
そのため、生成モデルだけに注目せず、検索前後の工程を含めて見直す必要があります。
とくに意識したいのは、検索精度、チャンク設計、プロンプト設計、評価方法の4つです。
- 検索対象データを絞り、ノイズの少ない文書群にする
- 質問に答えやすい単位でチャンクを分割する
- メタデータやフィルタ条件を活用する
- 上位検索結果の再ランキングを検討する
- プロンプトで「推測しない」「根拠を優先する」と明示する
- 実際の質問ログを使って評価する
とくに見落としやすいのが評価方法です。
「なんとなく良さそう」で判断すると、改善の方向性が定まりません。
質問セットを用意し、正答率、根拠の適切さ、回答時間、参照漏れの有無などを継続的に確認することが大切です。
また、ハルシネーション対策としては、検索結果にない内容を答えにくくする設計が有効です。
「答えさせる」ことよりも、「根拠がないときは答えない」設計を入れることが実務では重要です。
社内利用では、とくに誤答を自信ありげに返すことのリスクが大きいため、回答不能時の振る舞いまで設計しておきましょう。
RAGの限界と注意点
RAGは有力な手法ですが、万能ではありません。
導入前に限界を理解しておかないと、期待値とのズレが生まれやすくなります。
まず押さえたいのは、検索対象に存在しない情報は答えられないという点です。
文書が不足していたり、そもそも業務ルールが明文化されていなかったりすると、RAGだけでは対応できません。
また、文書に正しい情報があっても、検索で拾えなければ回答に反映されません。
つまり、RAGの課題はLLMの性能だけではなく、文書整備と検索設計にもあります。
さらに、権限制御や監査ログが必要な環境では、単純な試作より本番設計の難易度が上がります。
とくに社内文書を扱う場合は、閲覧権限の異なる情報をどう分けるか、ログをどこまで残すかといった非機能要件が重要です。
注意点をまとめると、次のようになります。
- 元データが不十分だと精度は上がりにくい
- 検索に失敗すると正しい文書があっても答えられない
- 文書更新のたびに再インデックス運用が必要になる
- 権限管理や監査対応を後付けするとコストが増えやすい
- 利用量が増えるとAPI費用やインフラ費用も膨らむ
PoCではうまく動いても、本番運用で文書更新やアクセス制御が課題になることは珍しくありません。
そのため、初期段階から「作れるか」だけでなく「回せるか」まで見ておく必要があります。
RAGの費用感について
RAGの費用は、PoCで小さく検証するのか、本番導入まで行うのか、さらにデータ整備や運用保守をどこまで含めるのかによって大きく変わります。
以下は、公開情報から複数ソースで確認できた代表的な費用帯です。
| 区分 | 費用相場 | 条件・補足 |
|---|---|---|
| PoC | 50万円〜200万円 | 小規模検証・限定データ・少人数利用の初期検証向け |
| 本番開発 | 300万円〜1,500万円 | 標準的な社内向け本番導入レンジ |
| データ整備 | 200万円〜1,000万円 | 非構造化データの前処理・OCR・クレンジング・メタデータ整備が必要な場合の追加費用 |
| SaaS型RAGツール | 月額数万〜数十万円 | 初期投資を抑えたい場合の月額利用型 |
| 運用保守 | 初期開発費の20%〜30%/年 | 監視、改善、障害対応などを含む年間保守の目安 |
金額差を生みやすいのは、対象データの量と品質、OCRやクレンジングの有無、権限管理や監査ログの必要性、既存システムとの連携数、利用するLLMの種類などです。
また、開発費だけでなく、API利用料、ベクトルDB、クラウド、文書更新時の再インデックス、精度改善の運用工数も継続的に発生します。
見積もりでは、初期費用と月額費用が分かれているか、従量課金の前提が明記されているかを必ず確認しましょう。
あわせて、PoC費用に評価設計や検証レポートが含まれるか、本番化時に権限管理・監査ログ・SLAなどの非機能要件が入っているかも見ておきたいところです。
RAGの活用事例
RAGは、最新情報や社内固有情報を参照させたい場面で使いやすい仕組みです。
そのため、汎用的なチャットボットというより、業務知識へのアクセスを効率化する用途で効果が出やすくなります。
代表的な活用例としては、社内ナレッジ検索があります。
人事規程、経費精算ルール、情報システム部門の手順書などを対象にすると、問い合わせ対応の一次受けを効率化しやすくなります。
また、カスタマーサポートでも活用しやすい分野です。
製品マニュアル、トラブルシューティング集、更新履歴を検索対象にすれば、オペレーター支援や顧客向け回答支援に役立つでしょう。
営業や提案業務での利用も考えられます。
過去提案書、製品比較表、導入事例、FAQをもとに回答案を作らせれば、情報収集の時間短縮につながります。
さらに、法務・コンプライアンス領域では、契約書ひな形、社内規程、ガイドラインを対象にした照会支援も候補になります。
ただし、こうした領域は誤答の影響が大きいため、回答根拠の表示や人手確認の運用を組み合わせることが前提です。
よくある質問
Q.1 どのくらいのデータ量があればRAGを構築できますか?
RAGは大量データがないと作れないわけではありません。限定的なFAQや規程集、製品マニュアルの一部など、対象を絞れば小規模なデータでもPoCは可能です。ただし、量よりも重要なのは、質問に答えるための情報が十分に含まれているか、最新版が整理されているか、文書の質が揃っているかです。
Q.2 RAGとファインチューニングは何が違うのですか?
RAGは外部文書を検索して回答に反映する仕組みで、ファインチューニングはモデル自体の出力傾向を追加学習で調整する方法です。最新情報や社内文書の参照が主目的ならRAGが向きやすく、文体統一や特定タスクの振る舞い最適化が目的ならファインチューニングが候補になります。
Q.3 RAGは初心者でもゼロから作れますか?
概念理解と簡易な試作であれば、初心者でも十分に取り組めます。とくに最近は埋め込みモデルやベクトルDB、LLM APIを組み合わせやすくなっています。ただし、本番運用ではデータ整備、権限管理、ログ管理、継続改善まで考える必要があるため、試作と実務導入では難易度が異なります。
Q.4 RAGでハルシネーションは完全になくせますか?
完全になくすのは難しいものの、一般的なLLM単体よりは抑えやすくなります。検索結果を根拠として使わせることで、社内文書に沿った回答へ寄せやすくなるためです。ただし、検索ミスや不適切なプロンプト、元データの不備があると誤答は起こり得るため、回答不能時のルールや根拠表示の設計が重要です。
Q.5 RAGを作るとき、最初に手を付けるべきなのはどこですか?
最初に決めたいのは、使いたいモデルではなく、どの業務課題を解くのかというユースケースです。その次に、検索対象とする文書を絞り込み、データの品質を確認します。目的が曖昧なまま作り始めると、評価基準も改善方針も定まらず、PoCが形だけで終わりやすくなります。
RAGをゼロから作るなら、設計と改善の流れを押さえよう
RAGをうまく作るうえで大切なのは、単に生成AIを導入することではなく、どの情報をどう検索し、どのような形で回答へつなげるかを設計することです。
実際には、データ準備、チャンク設計、ベクトル化、検索、生成、改善という複数の工程が関わるため、どこか1つだけ整えても十分とは限りません。
とくに確認したいのは、対象ユースケースに合ったデータがあるか、質問に答えやすいチャンク設計になっているか、検索結果にない内容を無理に生成しない設計になっているかという点です。
これから着手するなら、まずは対象業務を絞ったPoCを設計し、評価用の質問セットを用意したうえで、小さく検証を始めるとよいでしょう。
あわせて、初期開発費だけでなく、データ整備、運用保守、API利用料、文書更新時の改善工数まで見込んでおくことで、自社に合った進め方を判断しやすくなります。
自社だけで要件整理や技術選定、PoC設計まで進めるのが難しい場合は、RAGや生成AIの実装に詳しい専門家へ相談するのも現実的な選択肢です。
エラビサキでは、RAG開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。