【2026年最新】ローカルLLMとは?メリット・デメリット、導入方法、活用シーンを解説
ローカルLLMは、生成AIを自社PCや社内サーバー、ワークステーションなどの手元に近い環境で動かしたいときに検討される選択肢です。
クラウドのAIサービスを使えばすぐに始めやすい一方で、機密情報の扱い、継続的なAPI利用料、ネットワーク依存といった論点が気になる場面もあるでしょう。
そのため、「ローカルLLMとは何か」「クラウドLLMと何が違うのか」「自社や個人開発で本当に使えるのか」といった基本から整理したい方は少なくありません。
また、導入を考え始めると、メリットだけでなく、必要なスペック、実行ツールの選び方、運用時の注意点まで確認しておきたくなるはずです。
この記事では、ローカルLLMの基本概念と仕組みを整理したうえで、クラウドLLMとの違い、メリット・デメリット、向いている用途、導入方法、主な活用業務、費用の考え方まで実務目線で解説します。
ローカルLLMとは?基本概念と仕組み
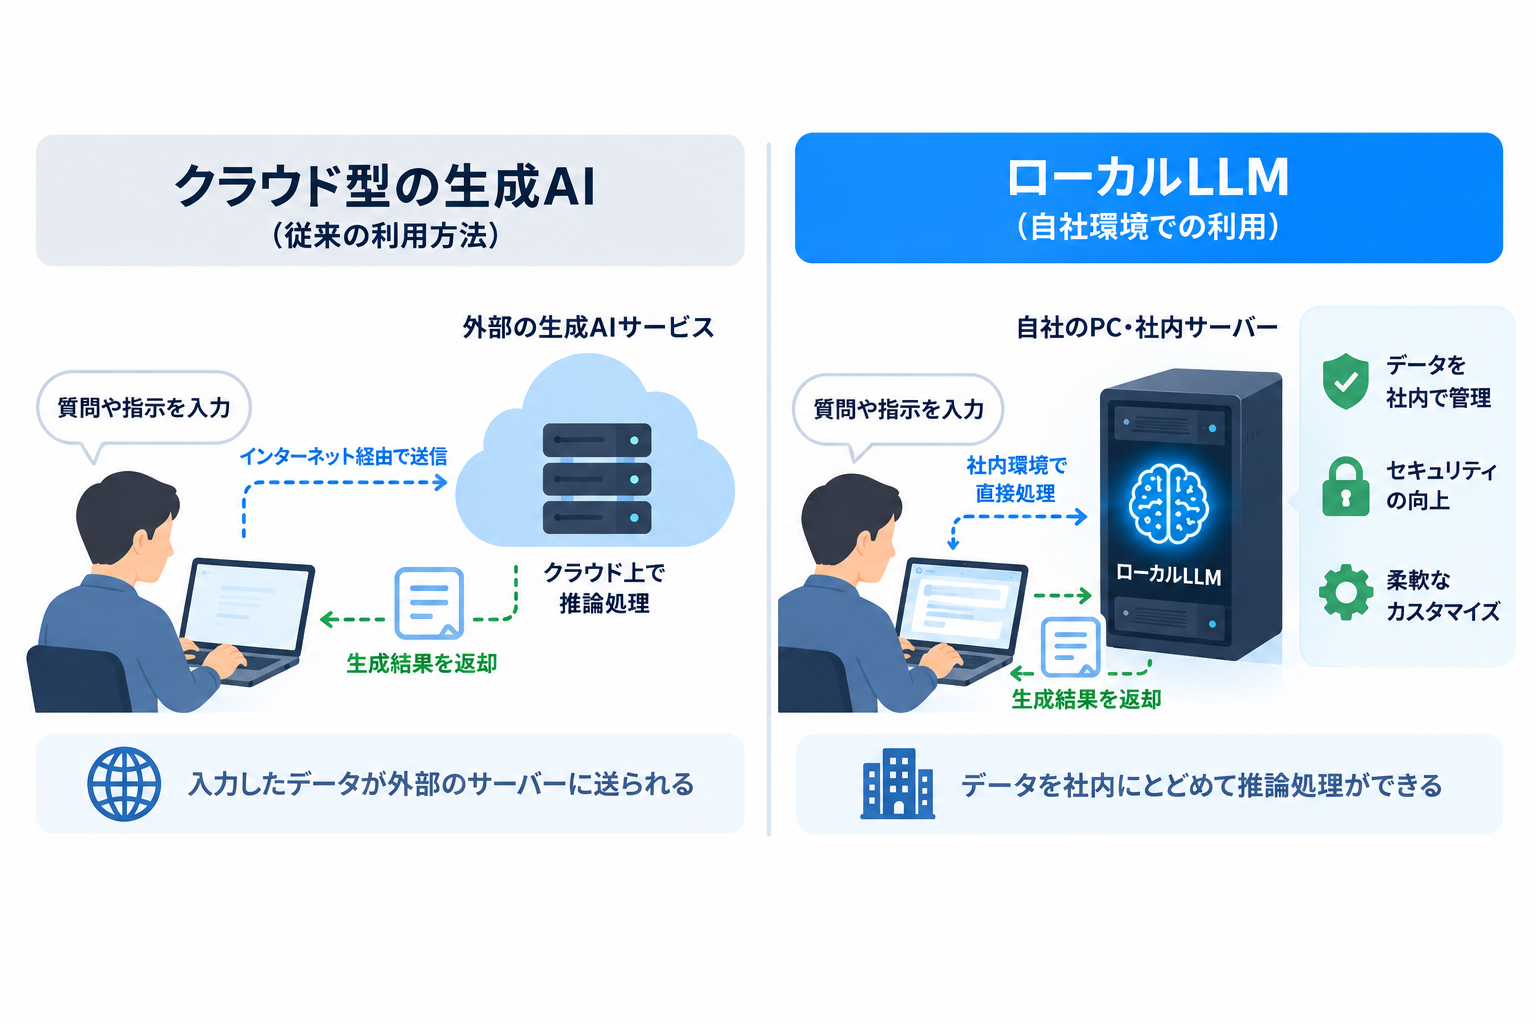
ローカルLLMとは、大規模言語モデルを外部の生成AIサービスへAPI経由で問い合わせるのではなく、自分のPCや社内サーバーなど、自社で管理できる環境にモデルを配置して実行する形態を指します。
一般的なクラウド型の生成AIでは、入力したテキストが外部サービスのサーバーへ送られ、そこで推論された結果が返ってきます。
一方、ローカルLLMでは推論処理そのものを手元や社内環境で完結させやすいため、データの取り扱いを自社側でコントロールしやすい点が特徴です。
仕組みとしては、まずモデル本体の重みデータを端末やサーバーへ配置し、それを実行ツールや推論基盤で読み込んで応答を生成します。
利用するモデルのサイズや量子化の有無によって、必要なメモリやGPU性能は大きく変わります。
そのため、ローカルLLMは単に「無料でAIを使う方法」ではなく、モデル、ハードウェア、運用方法を含めて設計する仕組みとして理解することが大切です。
なお、LLMそのものの開発や構築の全体像から整理したい場合は、LLM開発の基本を解説した記事もあわせて確認すると理解しやすくなります。
クラウドLLMとの違い
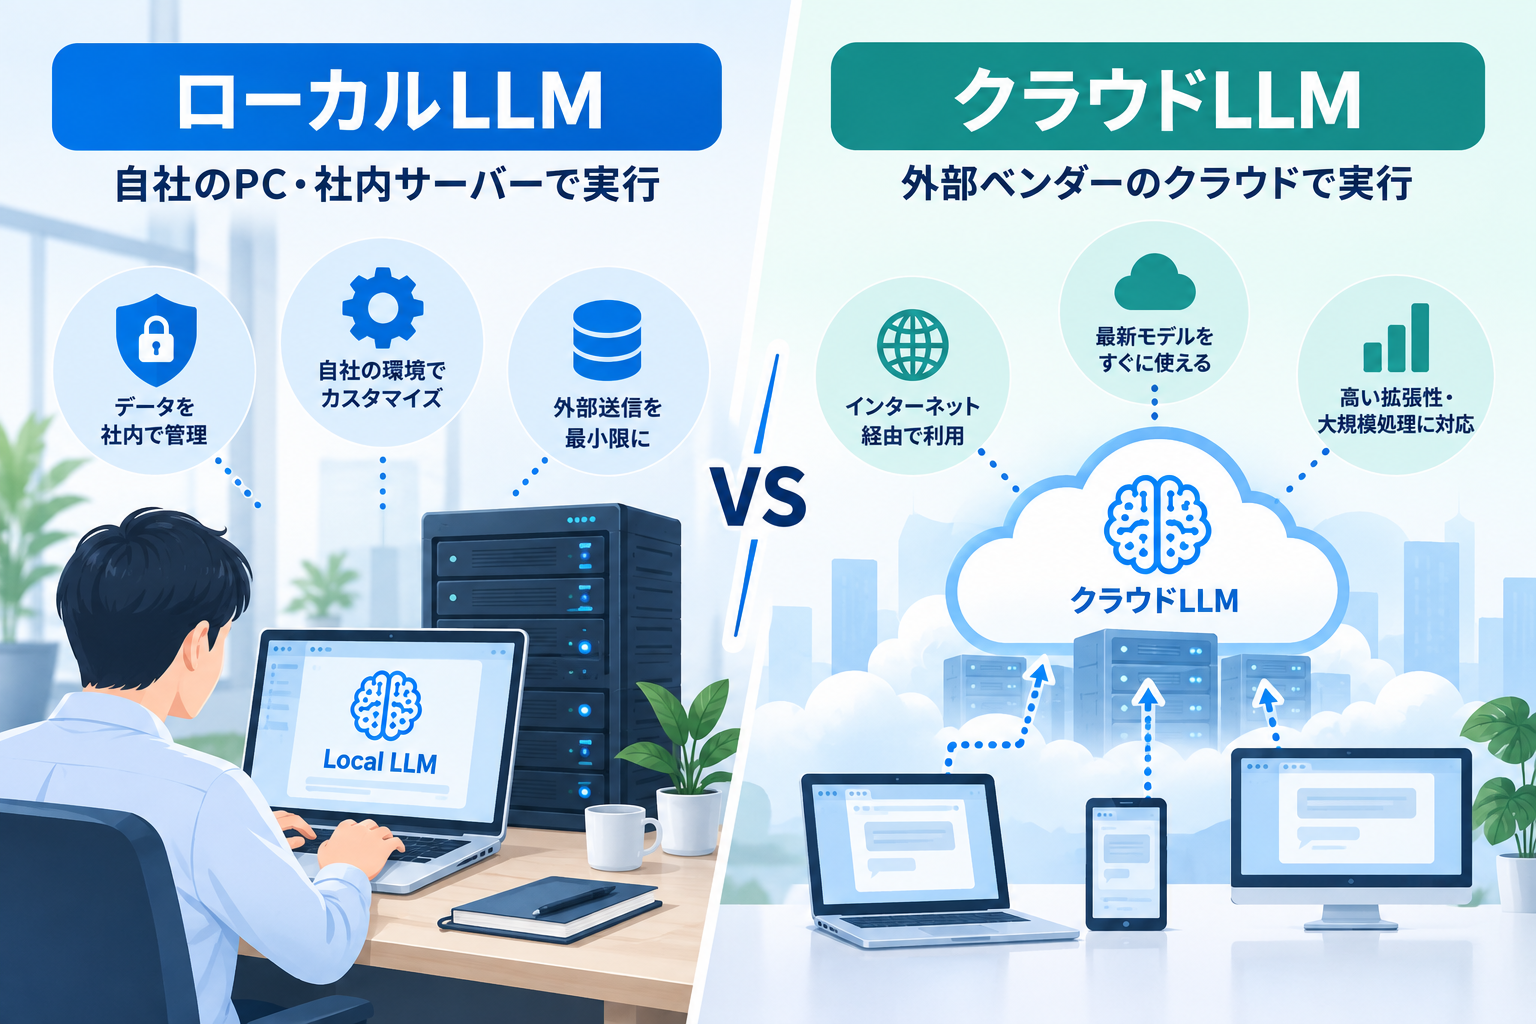
ローカルLLMとクラウドLLMの違いは、どこでモデルを実行するかにあります。
クラウドLLMはベンダーのサーバー上で推論し、ローカルLLMは自社端末や社内環境で推論します。
この違いは、セキュリティだけでなく、コスト構造、性能、運用負荷にも影響します。
| 比較観点 | ローカルLLM | クラウドLLM |
|---|---|---|
| 推論の実行場所 | 自社PC・社内サーバー・自社管理環境 | 外部ベンダーのクラウド基盤 |
| データの扱い | 自社内に閉じる構成を取りやすい | 外部サービスへの送信を伴う構成が一般的 |
| 導入のしやすさ | 環境準備が必要 | APIやSaaSで始めやすい |
| 費用の出方 | 機材・環境構築・保守などの費用が中心 | 従量課金や月額利用料が中心 |
| 拡張性 | 自社環境次第で制約を受けやすい | 高性能モデルや大規模処理を使いやすい |
| 運用負荷 | 更新・監視・障害対応が必要 | 基盤運用はベンダー側に寄せやすい |
とくに判断材料になりやすいのは、機密性と運用負荷のバランスです。
外部送信をできるだけ避けたい業務ではローカルLLMが候補になりやすい一方で、最新モデルをすばやく試したい場合や、高い推論性能を優先したい場合はクラウドLLMのほうが現実的なこともあります。
また、クラウドLLMは短期間で立ち上げやすい反面、利用量が増えると従量課金が膨らむ可能性があります。
ローカルLLMは外部APIの利用料を抑えやすい一方で、導入後もハードウェアの維持や保守、モデル更新などの負担が継続するため、単純にどちらが安いとは言い切れません。
ローカルLLMのメリット・デメリット
ローカルLLMには明確な利点がありますが、同時に見落としやすい負担もあります。
導入判断では、両面をセットで見ることが重要です。
メリット
ローカルLLMの主なメリットは次のとおりです。
- 機密データを外部へ送信しない構成を取りやすい
- ネットワーク接続に依存せず利用できる構成を作りやすい
- 外部APIの従量課金を抑えやすい
- モデルや実行環境を細かく制御しやすい
- 社内ルールに合わせた閉域運用を設計しやすい
とくに、社内文書や顧客情報を扱う業務では、入力データを外部へ送らない構成にしたいケースがあります。
そのような場面では、情報を自社管理環境にとどめながら生成AIを利用できることが大きな価値になります。
また、一定以上の利用量がある場合、毎回のAPI課金ではなく、自社機材を前提とした運用に切り替えることでコスト予測がしやすくなることもあるでしょう。
デメリット
一方で、ローカルLLMには次のようなデメリットがあります。
- 高性能なGPUや十分なメモリが必要になりやすい
- モデル更新や脆弱性対応を自社で管理する必要がある
- クラウドで提供される高性能モデルと比べて性能面で不利な場合がある
- 複数人利用や高負荷処理では構成が複雑になりやすい
- 品質検証やチューニングに工数がかかる
たとえば、軽量モデルならPCで試せても、業務で安定運用する段階になると、応答速度や同時接続数の要件が一気に厳しくなることがあります。
さらに、モデルを更新すれば精度が上がるとは限らず、既存業務との整合性や出力品質の再検証が必要です。
そのため、ローカルLLMは「導入すれば終わり」ではなく、継続的な運用体制まで含めて評価するべき選択肢と考えておきたいところです。
ローカルLLMが向いている用途と向かない用途
ローカルLLMは万能ではありません。
自社の目的に合うかどうかは、用途ごとに見極める必要があります。
向いている用途
ローカルLLMが向いているのは、次のようなケースです。
- 機密情報や社外秘データを扱う社内業務
- ネットワーク制約がある閉域環境での利用
- 個人開発やPoCで軽量モデルを試したいケース
- 社内ナレッジ検索やFAQ支援など限定用途の運用
- カスタマイズや制御性を重視するシステム組み込み
たとえば、議事録要約、社内マニュアル検索、コード補助、文書分類といった用途は、比較的ローカルLLMと相性が良い場面があります。
とくに社内文書活用では、モデル単体ではなくRAG構築の考え方を組み合わせることで、実務で使える回答精度を目指しやすくなります。
また、機密性を重視した社内AI基盤を考えるなら、社内RAGの構成例も参考になるでしょう。
向かない用途
反対に、次のような用途ではクラウドLLMのほうが適していることがあります。
- 最新の高性能モデルをすぐ利用したい
- 大規模ユーザーが同時接続するサービスを運用したい
- 画像・音声・外部ツール連携まで幅広く使いたい
- インフラ管理に人員を割きにくい
- 実験よりも短期立ち上げを優先したい
要するに、ローカルLLMは制御性と機密性を取りやすい一方で、スケールや最新性能では不利になる場面があります。
用途が広く、頻繁にモデルを切り替えたいなら、ローカルにこだわりすぎずハイブリッド運用も視野に入れると判断しやすくなります。
ローカルLLMの導入に必要なハードウェアと実行ツール
ローカルLLMを導入するうえで重要なのは、モデル選定と同じくらい実行環境の設計です。
必要スペックは一律ではなく、モデルサイズ、量子化、同時利用人数、応答速度の要件で変わります。
ハードウェアで見るべき項目
最低限、次の観点を確認しましょう。
- CPU性能
- GPUの有無とVRAM容量
- メインメモリ容量
- ストレージ容量と速度
- 冷却や電源などの安定稼働条件
軽量モデルを個人PCで試すならCPU中心でも動く場合がありますが、応答速度を重視するならGPU活用が現実的です。
一方、モデルが大きくなるほどVRAMやメモリの要求は上がり、業務利用では単に動けばよいのではなく、待ち時間を許容できるかまで見なければなりません。
そのため、必要スペックは「モデルの大きさ」だけでなく「どの速さで何人が使うか」で決まると考えると整理しやすくなります。
代表的な実行ツール
ローカルLLMの実行に使われる代表的なツールには、次のようなものがあります。
- Ollama:ローカルでモデルを扱いやすく、試験導入や開発用途で使いやすい
- LM Studio:GUI中心で操作しやすく、個人検証に向いている
- llama.cpp:軽量実行やCPU環境も含めて幅広く利用される
- vLLM:高効率な推論基盤としてサーバー運用寄りの場面で使われる
個人開発や小規模PoCなら、まずは導入しやすいツールから始めるほうがハードルは低いでしょう。
一方、社内システムへ組み込むなら、単体実行だけでなくAPI化、監視、スケーリング、権限管理まで考える必要があります。
生成AIを業務システムへつなぐ前提なら、生成AIシステム開発の進め方も押さえておくと設計の抜け漏れを防ぎやすくなります。
おすすめモデルの考え方
「どのモデルがよいか」は一概には決まりません。
選ぶ際は、4つの観点で整理すると判断しやすくなります。
- 日本語性能
- モデルサイズと必要リソース
- コンテキスト長
- ライセンス条件と商用利用可否
日本語での文書要約やQAを重視するなら、日本語性能や多言語性能の確認が欠かせません。
また、大きなモデルほど高性能とは限らず、用途が限定されているなら軽量モデルのほうが運用しやすい場合もあります。
ローカルLLMの導入方法
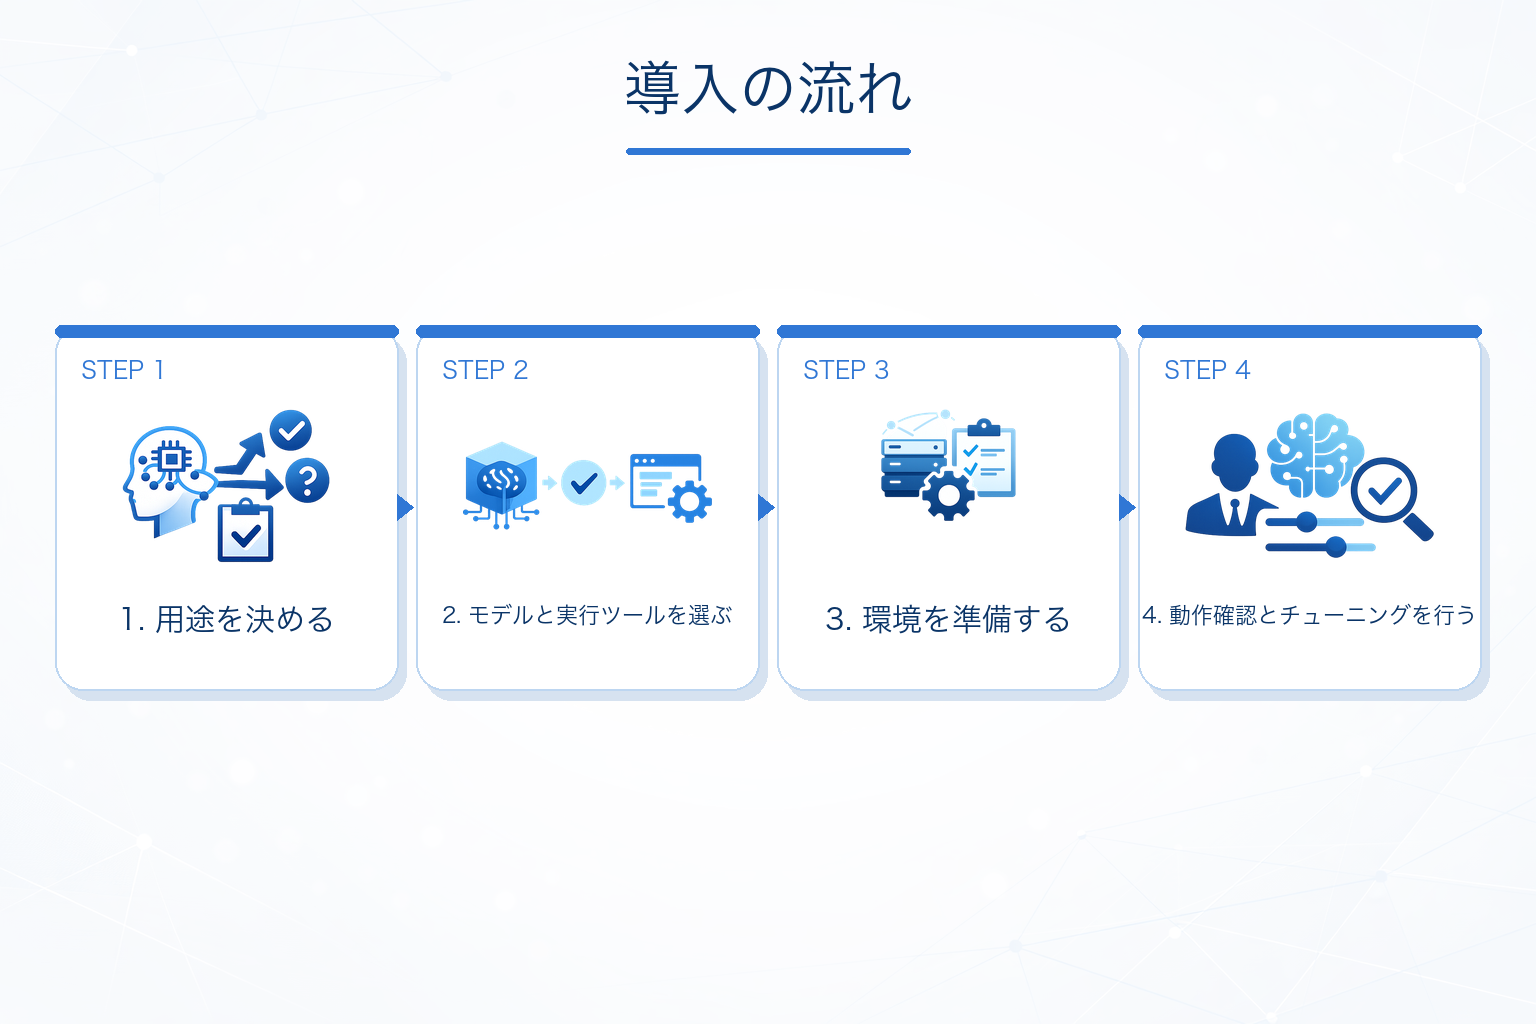
ローカルLLMは、一般的に次のような流れで導入します。
- 利用目的と対象業務を整理する
- 必要なモデルと実行方式を決める
- ハードウェアと実行ツールを準備する
- 小規模に動作確認と評価を行う
- 業務データやシステムと連携する
- 本番運用と監視・改善の体制を整える
最初に行うべきなのは、何のためにローカルLLMを導入するのかを明確にすることです。
議事録要約なのか、社内文書検索なのか、コード補助なのかで、必要なモデルも環境も変わります。
次に、目的に合ったモデルと実行方式を選びます。
個人や部署単位の検証ならローカルPCで始めやすい一方で、複数人利用や閉域利用を前提にするなら、サーバー構成やアクセス制御まで初期段階で検討しておく必要があります。
導入初期は、いきなり本番環境を作り込むより、小規模PoCで精度・速度・運用負荷を先に見極める進め方が現実的です。
たとえば、以下のように段階を分けると判断しやすくなります。
軽量モデルで検証
↓
社内データ連携を試す
↓
利用部門を限定して試験運用
↓
本番展開を判断
また、見積もりや計画を立てる際は、具体的な市場相場を一律で当てはめるより、料金体系と費用発生ポイントを整理することが重要です。
ローカルLLMの費用はどう考えるべきか
ローカルLLMの費用は、導入形態によって構造が大きく変わります。
そのため、単純な「相場」よりも、どの方式で何に費用が発生するかを理解することが先決です。
- オンプレミス初期投資型:自社内に物理サーバーを設置して構築する方式で、初期の機材投資が重くなりやすい形です。
- 専用環境・プライベートクラウド型:自社管理下の専用GPU環境やプライベートクラウドを利用する方式です。物理サーバーを自社保有する場合より初期投資を抑えられることがありますが、GPU利用料や保守費などの継続コストが発生します。
- ローカルPCによるスモールスタート型:ノートPCやワークステーションで軽量モデルから試す方式で、PoCや個人開発に向いています。
- 買い切り+継続運用費型:機材や環境を用意したあとも、電力、保守、品質確認、更新対応といった運用費が積み上がる考え方です。
- ハイブリッド運用型:機密データを扱う処理はローカル、高度な推論や大規模処理はクラウドと使い分ける方式です。
- 個別見積もり型:企業導入では、同時利用人数やRAG連携、可用性要件などで都度見積もりになることが少なくありません。
費用を左右する要因も多岐にわたります。
導入形態、GPUやVRAMの要件、モデル規模、PoCの有無、同時利用人数、電力や冷却、運用保守体制、RAGやシステム連携の有無などで総コストは変わります。
とくに見落としやすいのが、機材費だけでなく、モデル更新、ログ監視、障害対応、品質確認の工数です。
見積もりを取る際は、次の項目を確認しておくと比較しやすくなります。
- 初期費用にGPU、メモリ、ストレージ、電源、設置費まで含まれるか
- PoC費用と本番費用が分かれているか
- 月額費用に監視、保守、バックアップが含まれるか
- 運用保守を自社と外部のどちらが担当するか
- 同時利用人数と許容応答時間が見積条件として明示されているか
- RAGや既存システム連携が別料金かどうか
- 障害時の代替手段や復旧条件が決まっているか
- 商用利用ライセンスやモデル更新時の検証作業が対象に含まれるか
ローカルLLMはAPI費用の削減だけで判断せず、初期投資・継続運用費・品質管理コストを合わせた総コストで見ることが大切です。
ローカルLLMが活用される主な業務
ローカルLLMは、単なるチャット用途よりも、限定された業務の効率化に向いていることがあります。
とくに、入力データを自社内で扱いたい場面では活用イメージを持ちやすいでしょう。
個人開発での活用
個人開発では、コード補助、メモ作成、文章要約、簡易ボット作成などに使われます。
軽量モデルと扱いやすい実行ツールを組み合わせれば、クラウドAPIを使わずに試作しやすい点は魅力です。
オフライン環境でも試せるため、学習目的やプロトタイピングにも向いています。
社内業務での活用
企業利用では、議事録の要約、社内問い合わせ対応、手順書検索、報告書の下書き生成などが考えられます。
とくに社内文書検索では、ローカルLLM単体よりもRAGと組み合わせることで、既存資料を参照しながら回答する構成が取りやすくなります。
このとき重要なのは、回答の自然さだけではなく、どの文書を参照したか、誤回答が業務に与える影響はどれくらいかを事前に設計することです。
システム組み込みでの活用
既存システムにローカルLLMを組み込む方法もあります。
たとえば、社内ポータル、ヘルプデスク、ナレッジベース、開発支援ツールなどに組み込み、入力内容に応じて要約や回答補助を返す使い方です。
ただし、システム組み込みではモデル精度だけでなく、認証、権限管理、ログ設計、例外処理まで含めた設計が欠かせません。
ローカルLLM導入時の注意点
ローカルLLMは機密情報を自社管理環境にとどめやすい点が特徴ですが、導入時には事前に押さえるべき注意点があります。
ここを軽視すると、期待した効果が出にくくなります。
- モデル更新のたびに再検証が必要になる
- 出力品質を業務基準で評価しなければならない
- 商用利用ライセンスの確認が必要になる
- 障害時の代替手段を用意しておく必要がある
- ログ管理やアクセス制御を別途設計する必要がある
- 電力・冷却・設置環境まで含めた運用が求められる
まず注意したいのは、ローカル実行だからといって自動的に安全になるわけではない点です。
端末内や社内環境で処理を完結させても、権限設定、端末管理、ネットワーク構成、ログの扱いなどが適切でなければ、情報管理上のリスクは残ります。
また、モデルの回答品質も慎重に見極める必要があります。
一般的な会話では自然でも、業務文書の要約や社内規程の参照では、微妙な誤りが実務上のリスクになることがあります。
さらに、導入後に想定しやすいのが運用負荷の増加です。
モデル更新、脆弱性対応、バックアップ、障害監視まで考えると、「外部サービスへデータを送らない構成を取りやすい」一方で、自社で管理すべき範囲が広がることは理解しておきたいところです。
そのため、まずは利用範囲を限定し、精度評価と運用設計を固めてから広げる進め方が現実的でしょう。
ローカルLLMのよくある質問
Q.1 ローカルLLMとは何ですか?
ローカルLLMとは、大規模言語モデルを外部の生成AIサービスへAPI経由で問い合わせるのではなく、自分のPCや社内サーバーなど、自社で管理できる環境に配置して実行する形態です。外部サービスへのデータ送信を避ける構成を取りやすく、機密情報を扱う場面などで検討されます。
Q.2 クラウドLLMとの違いは何ですか?
大きな違いは、推論処理をどこで行うかです。ローカルLLMは自社端末や社内環境で動かし、クラウドLLMは外部ベンダーのサーバーで動かします。その結果、データの扱い、導入のしやすさ、費用構造、運用負荷に差が出ます。
Q.3 ローカルLLMにはどんなメリットがありますか?
主なメリットは、機密データを外部へ送信しない構成を取りやすいこと、ネットワーク依存を下げやすいこと、外部APIの従量課金を抑えやすいことです。また、モデルや環境を自社の要件に合わせて制御しやすい点も利点です。
Q.4 ローカルLLMのデメリットは何ですか?
高性能なハードウェアが必要になりやすく、モデル更新や障害対応、品質検証などを自社で担う必要があります。クラウドで提供される高性能モデルと比べて性能面で不利になることもあり、導入後の運用体制まで含めて検討することが欠かせません。
Q.5 ローカルLLMは個人開発でも使えますか?
はい、軽量モデルと扱いやすい実行ツールを選べば、個人開発でも試せます。まずは小さなモデルで動作確認し、要約やコード補助など限定用途から始めると、必要スペックや使い勝手を判断しやすくなります。
Q.6 企業で導入する場合は何を確認すべきですか?
利用目的、対象データ、同時利用人数、必要な応答速度、モデルのライセンス条件、ログ管理、障害時の代替手段を確認すべきです。また、PoC費用と本番費用を分けて考え、RAG連携や既存システム連携の有無まで含めて見積もることが重要です。
自社に合ったローカルLLM活用方針を見極めよう
ローカルLLMを検討する際に大切なのは、「ローカルで動くかどうか」だけで判断しないことです。
機密性、応答速度、継続コスト、運用負荷のどれを優先するかによって、適した構成は変わります。
また、ローカルLLMといっても、個人PCで試す小規模構成から、社内サーバーなどで運用する本格構成まで幅があります。
モデルの大きさ、実行ツール、RAG連携の有無、同時利用人数などで必要な環境は大きく変わるでしょう。
比較の前に整理したいのは、利用目的、扱うデータの機密性、必要な応答速度、運用保守を誰が担うかといった条件です。
この前提が曖昧なままでは、スペック選定も費用見積もりもぶれやすくなります。
まずは対象業務を絞り、軽量モデルや小規模PoCから始めて、精度と運用負荷を確かめる進め方が現実的です。
そのうえで、必要に応じてRAGやシステム連携へ広げると、投資判断もしやすくなります。
もし自社だけで設計や実装、評価を進めるのが難しい場合は、ローカルLLMやRAG、生成AIシステムに対応できる外部パートナーへ相談する選択肢もあります。
構築を委託するか、設計レビューだけ依頼するかでも進め方は変わるため、必要に応じてLLM開発会社の情報も確認しながら、支援範囲を見極めるとよいでしょう。
エラビサキでは、LLM開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。