RAG(検索拡張生成)への攻撃リスクに備えるには?仕組み・RAGセキュリティ対策を解説
社内文書やナレッジベースを生成AIに参照させ、回答の精度を高める方法としてRAGに関心を持つ企業もあります。
ただし、業務利用を前提にすると、精度だけでなくセキュリティをどう担保するかが大きな論点になります。
「RAGは通常の生成AIと何が違うのか」「機密情報が漏れることはないのか」「権限管理や誤参照にはどう備えるべきか」といった疑問を持つ担当者も多いでしょう。
この記事では、RAGの基本概念と仕組みを整理したうえで、セキュリティ上の主なリスク、導入時に押さえたい対策、導入前のチェックポイントまで実務目線で解説します。
RAGとは
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と呼ばれます。
ユーザーの質問に対して、あらかじめ学習済みのモデルだけで答えるのではなく、外部データベースや社内文書から関連情報を検索し、その内容を踏まえて回答を生成する仕組みです。
たとえば社内規程、製品マニュアル、FAQ、議事録などを検索対象にしておけば、LLMはそれらを参照しながら回答を返せるようになります。
この構成により、モデル単体では持っていない最新情報や企業固有の情報を扱いやすくなるのが大きな特徴です。
一方で、RAGは「検索できれば安全」というものではありません。
検索対象の文書、検索結果の取り扱い、回答生成時の権限制御まで含めて設計しないと、便利さと引き換えに新たな情報漏えいリスクを抱える可能性があります。
RAGの仕組み
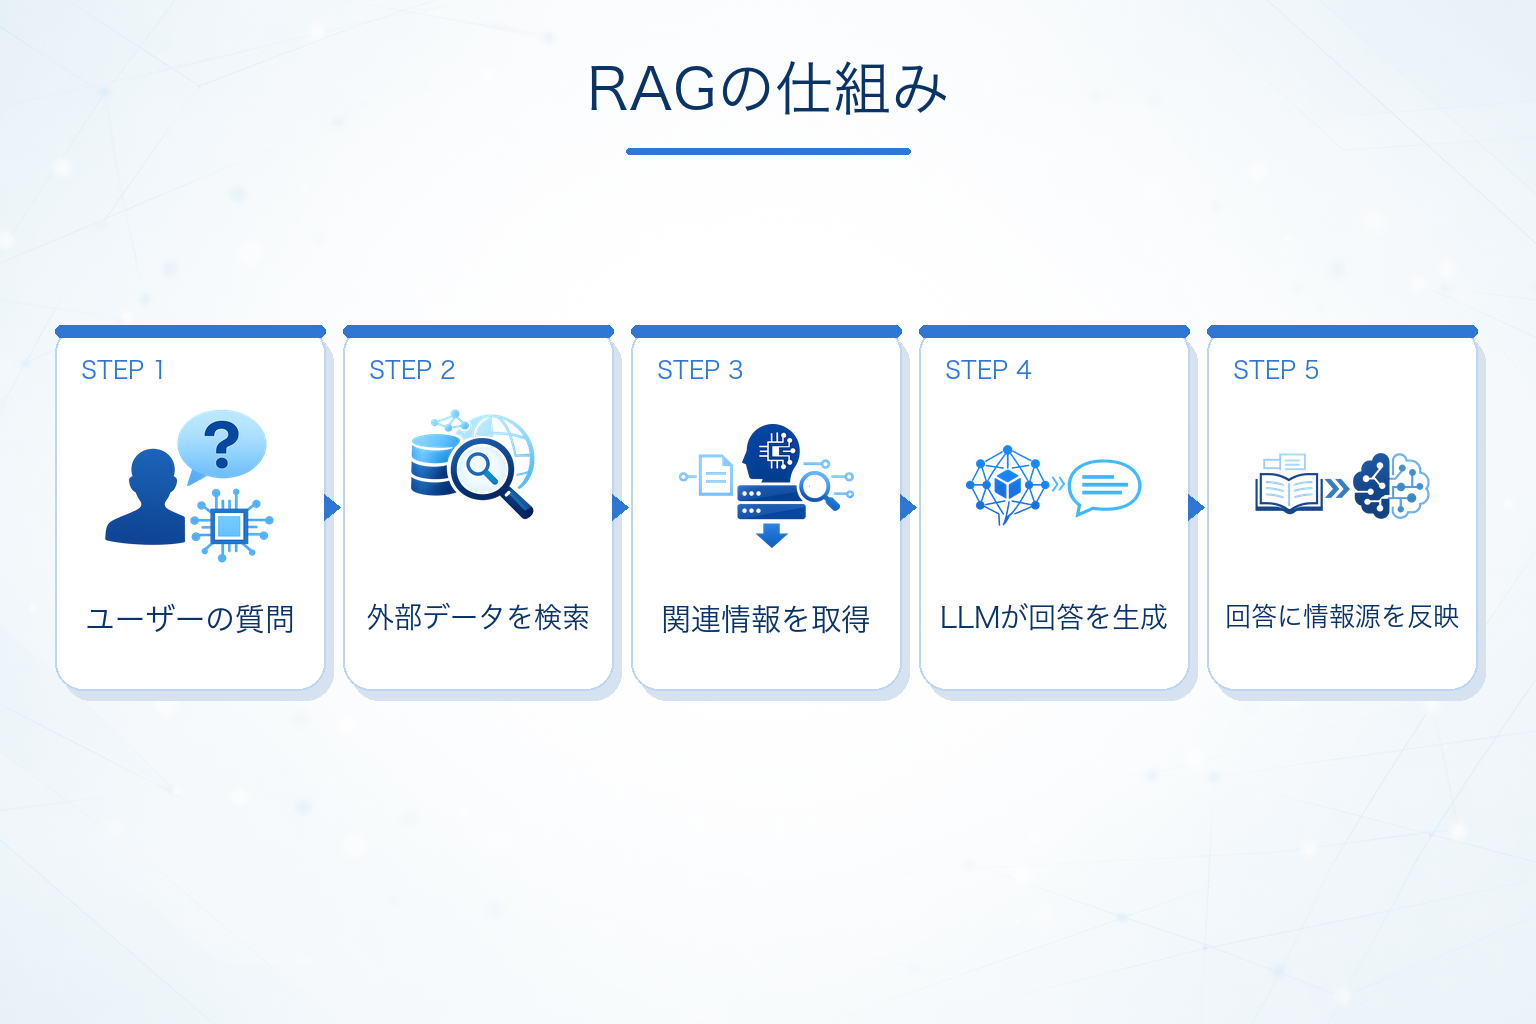
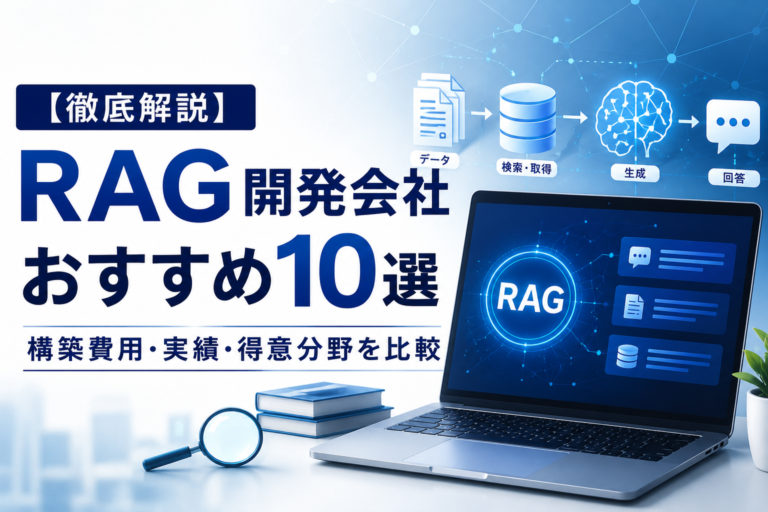
RAGの流れは、大まかにいうと「データを準備する」「質問に近い情報を検索する」「取得した情報をもとに回答を生成する」の3段階です。
1. 参照データを準備する
まず、参照させたい文書を分割し、テキスト化したうえでベクトル化し、ベクトルデータベースへ格納します。
この前処理では、PDFやWord、Webページ、社内Wikiなど多様なデータを扱うことが多く、ここでの整備品質が後の精度と安全性に直結します。
2. 関連情報を検索する
次に、ユーザーが質問すると、その質問もベクトル化され、意味的に近い文書片をベクトルデータベースから検索します。
これはキーワード一致だけでなく意味の近さを用いるため、表現が完全一致していなくても関連情報を見つけやすい仕組みです。
3. 検索結果をもとに回答を生成する
その後、取得した文書片をプロンプトの一部としてLLMに渡し、質問文と合わせて最終回答を生成します。
このとき、検索結果に不要な情報や権限外の情報が混ざっていれば、そのまま回答へ反映される可能性があります。
つまりRAGのセキュリティは、LLMそのものだけでなく、検索基盤、文書管理、アクセス制御、プロンプト設計まで含む全体設計の問題です。
RAGの構成をもう少し実務寄りに理解したい場合は、社内RAGの考え方もあわせて確認しておくと整理しやすくなります。
RAGのセキュリティ上の主なリスク
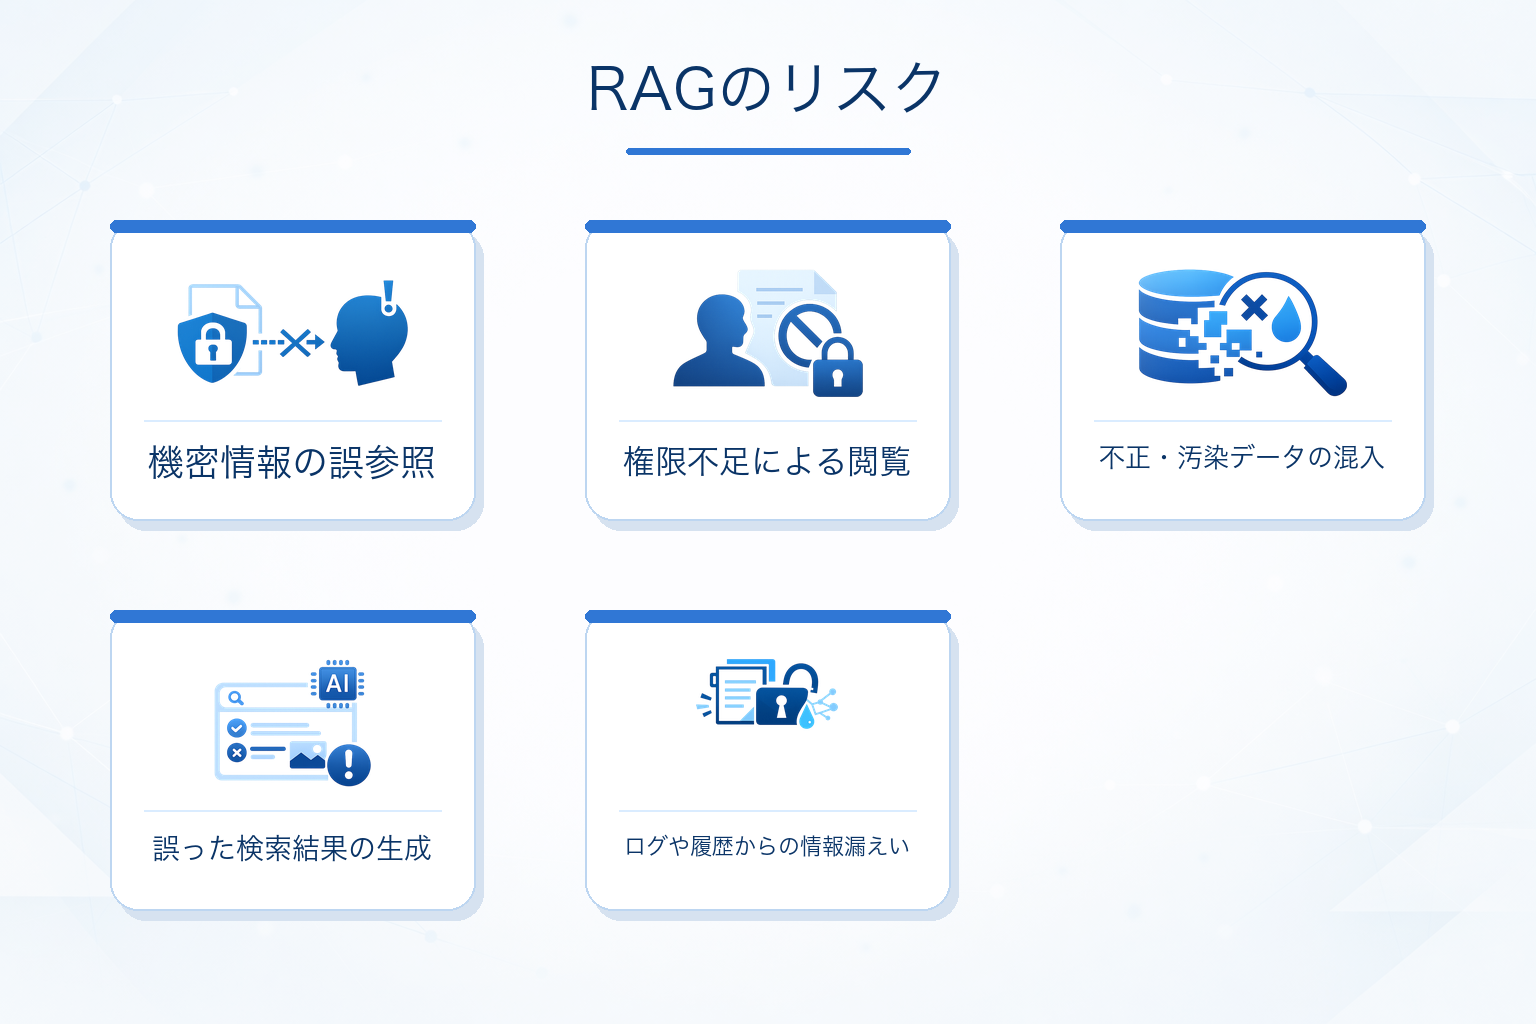
RAGのセキュリティリスクは、モデル単体の問題よりも、外部データを取り込んで検索・参照する構造から生じるものが多いのが特徴です。
とくに企業利用では、次のようなリスクを押さえておく必要があります。
- 権限外の文書を検索・参照してしまうリスク
- 機密情報が回答文やログに含まれるリスク
- 古い文書や不正確な文書を誤って根拠にするリスク
- 悪意ある文書混入によって応答が誘導されるリスク
- 検索結果の不適合によって誤答が強化されるリスク
以下では、実務でとくに問題になりやすい論点を整理します。
情報漏えい
もっとも代表的なのは、機密情報や個人情報が意図せず回答に含まれるリスクです。
たとえば閲覧権限の異なる部門文書が同じ検索基盤に載っている場合、検索時の制御が不十分だと、本来見えないはずの情報を拾って回答に出すおそれがあります。
また、回答文そのものだけでなく、チャット履歴、監査ログ、問い合わせ履歴などの周辺データから情報が漏れるケースも無視できません。
生成AI活用全体の漏えいリスクを広く把握したい場合は、生成AI情報漏洩も確認しておくと理解が深まります。
権限管理の不備
RAGでは「文書を持っている」ことと「参照してよい」ことは同じではありません。
アクセス権を考慮せずにインデックス化すると、検索時に権限外データが候補へ上がる可能性があります。
とくに、部署別、役職別、案件別に閲覧範囲が異なる企業では、元システムの権限を検索基盤側へ正しく引き継げるかが重要です。
RAGでは「検索できる範囲」と「回答に使ってよい範囲」を一致させる設計が欠かせません。
誤参照と誤答
RAGは検索した情報を根拠にするため、検索精度が低いと誤った情報をもっともらしく回答してしまいます。
たとえば似た製品名、古い規程、過去案件の資料などが誤って引かれると、利用者は「根拠がある回答」と誤認しやすくなります。
これは単なる精度問題ではなく、誤案内、誤判断、監査対応ミスにつながる業務リスクでもあります。
RAG poisoning
RAG poisoningは、検索対象のデータに不正な内容や誤誘導を含む文書を混入させ、回答を意図的に操作するリスクです。
公開Web情報を取り込む構成や、複数部門が自由に登録できるナレッジ基盤ではとくに注意が必要でしょう。
悪意ある指示文、隠しテキスト、不正リンク、誤情報がインデックス化されると、LLMはそれを信頼できる根拠のように扱う可能性があります。
プロンプトインジェクション経由の攻撃
RAGでは取得した文書がそのままモデルへの入力に近い位置で使われるため、外部データ側に埋め込まれた指示がモデル挙動へ影響することがあります。
これは間接的な攻撃経路になりやすく、悪意あるページや文書を参照したときに危険です。
この論点は通常の入力欄だけで起こる問題ではないため、プロンプトインジェクションの仕組みもあわせて押さえておきたいところです。
ログ・履歴からの二次漏えい
運用中のRAGでは、質問内容、検索クエリ、取得チャンク、生成結果、失敗ログなどが保存されることがあります。
これらは改善や監査に有用ですが、保管先や閲覧権限が曖昧だと、かえって機密情報の蓄積場所になってしまいます。
本番運用では、保存期間、マスキング方針、管理者権限、監査体制まで決めておく必要があります。
RAG導入時に押さえるべきセキュリティ対策
RAGの安全性を高めるには、単一の機能追加ではなく、データ・検索・生成・運用の各層で対策を組み合わせる必要があります。
とくに次の観点は優先して整理しましょう。
- 権限管理を検索基盤まで一貫させる
- データの品質と登録フローを管理する
- 出力制御とログ管理を行う
- 外部データや連携先の信頼性を見直す
- 評価と運用改善の仕組みを作る
権限管理を検索基盤まで一貫させる
まず重要なのは、元データのアクセス権をRAG基盤に反映することです。
文書管理システム側で閲覧制限があっても、インデックス作成時に権限属性が落ちていれば意味がありません。
ユーザー属性、部署、案件、役職などをもとに検索結果を絞り込めるよう設計する必要があります。
たとえばGoogle Drive、SharePoint、Box、Confluenceなど既存の文書基盤を参照元にする場合は、元システムの権限モデルをどこまで連携できるかを先に確認しておくと実装後の手戻りを減らしやすくなります。
データの品質と登録フローを管理する
次に、データ登録の入口を管理することも欠かせません。
誰でも自由にアップロードできる構成では、誤情報や不要文書、悪意あるテキストが混入しやすくなります。
登録元の限定、承認フロー、更新履歴、削除ルールを整備し、「どの情報を信頼できるソースとして使うのか」を明確にすることが、RAG poisoning対策の土台になります。
あわせて、失効した規程、旧版マニュアル、下書き資料、重複文書をどう除外するかも決めておくと、誤参照の抑制につながります。
出力制御とログ管理を行う
また、回答生成時には出力フィルタリングも検討したいところです。
たとえば個人情報、認証情報、特定の社外秘キーワードを検出したら回答を止める、あるいは要約表現へ変換するなどの制御が考えられます。
LLM自体の安全対策も重要なので、必要に応じてLLMセキュリティの観点も並行して確認するとよいでしょう。
ログ管理では、何を保存し、誰が閲覧し、どれだけ保持するかを決める必要があります。
改善目的で詳細ログを残す場合も、質問文や取得文書に機密情報が含まれる前提で設計しなければなりません。
暗号化、アクセス制限、マスキング、保存期間の短縮などを組み合わせると管理しやすくなります。
外部データや連携先の信頼性を見直す
さらに、公開Webや外部サービスを検索対象に含める場合は、信頼できるドメインに限定する、HTML中の不要要素を除外する、更新監視を行うといった対策も有効です。
RAGは検索対象が広がるほど便利になりますが、そのぶん攻撃面も広がります。
導入時点から「精度向上のために何でも入れる」発想を避けることが大切です。
評価と運用改善の仕組みを作る
安全性は導入時点だけで決まるものではなく、運用しながら検証と改善を続ける必要があります。
たとえば、権限外情報が回答に出ていないか、古い文書が優先表示されていないか、回答拒否が過剰または不足していないかを定期的に確認します。
質問例を部門ごとに蓄積し、検索精度と回答妥当性をレビューする体制があると、精度改善とセキュリティ確認を両立しやすくなります。
RAGとセマンティック検索の違い
RAGとセマンティック検索は混同されがちですが、役割は同じではありません。
セマンティック検索は、意味の近さをもとに関連文書を見つける検索技術そのものを指します。
一方でRAGは、その検索結果をLLMへ渡し、最終的な回答生成まで行う仕組みです。
つまり、セマンティック検索はRAGを構成する要素のひとつになり得ますが、それだけでRAGになるわけではありません。
実務上の違いとしては、セマンティック検索は「候補文書を探す」ことが中心なのに対し、RAGは「探した情報を使って自然文で答える」ことまで含みます。
そのため、RAGでは検索精度に加えて、プロンプト設計、出力制御、根拠の見せ方、誤答時のふるまいまで検討しなければなりません。
セキュリティ面でも差があります。
検索だけであれば文書表示範囲の制御が中心ですが、RAGでは取得文書の内容が回答へ再構成されるため、「文書を見せる制御」だけでなく「回答として再表現される制御」まで必要になります。
RAG導入前のチェックポイント
RAGを導入する前に、技術面と運用面の前提を整理しておくと、後からの手戻りを減らしやすくなります。
とくに次の項目は、PoCの前段階で確認しておきたい内容です。
- 検索対象にするデータの範囲と機密区分
- 権限管理をどこまで反映するか
- 文書更新と再インデックスの運用方法
- 回答品質の評価基準
- ログの保存方針と監査要件
- 外部連携やクラウド利用の可否
対象データを絞って始める
まず、対象データを広げすぎないことが重要です。
PoC段階では、業務上の価値が高く、かつ権限設計が比較的明確な文書群から始めるほうが検証しやすくなります。
たとえば社内ヘルプデスク向けFAQ、製品マニュアル、公開済み社内規程のように、参照範囲を整理しやすい文書から着手すると、精度と権限制御の両方を評価しやすくなります。
全社文書を一気に対象にすると、精度より先に権限制御とデータ整備の難しさが表面化しがちです。
評価基準を先に決める
次に、評価基準を先に決めておきましょう。
RAGは「なんとなく便利そう」では本番化しにくく、検索適合率、根拠一致率、回答拒否の妥当性、更新反映の速さなど、確認観点を置く必要があります。
誤答が許されにくい業務では、正しく答える能力だけでなく、分からないときに答えない能力も重要です。
運用と監査の前提を固める
あわせて、ログの保管先、管理者権限、監査時の確認方法、文書更新時の再インデックス手順も決めておくと、本番移行時の混乱を抑えやすくなります。
生成AI全般の安全対策をどう組み立てるか迷う場合は、生成AIセキュリティの全体像も参考になります。
RAGに関するよくある質問
Q.1 RAGとは何ですか?
RAGは、外部データや社内文書を検索し、その結果をもとにLLMが回答を生成する仕組みです。学習済みモデルだけに頼らず、最新情報や企業固有の情報を反映しやすい点が特徴です。
Q.2 RAGはハルシネーションを完全に防げますか?
いいえ、完全には防げません。関連性の低い文書を取得したり、古い文書を参照したりすると、RAGでも誤答は起こります。検索精度、文書品質、出力制御を含めた設計が必要です。
Q.3 RAGでとくに注意すべきセキュリティリスクは何ですか?
代表的なのは、権限外文書の誤参照、回答やログからの情報漏えい、RAG poisoning、間接的なプロンプトインジェクションです。検索対象を広げるほど利便性は上がりますが、同時に攻撃面も広がるため、対象データと権限設計を慎重に決める必要があります。
Q.4 RAGとセマンティック検索は同じですか?
同じではありません。セマンティック検索は意味の近さで文書を見つける検索技術で、RAGはその検索結果をLLMに渡して回答を生成する仕組みです。検索までがセマンティック検索、検索から回答生成まで含むのがRAGと考えると整理しやすいでしょう。
Q.5 外部データはどう更新すればよいですか?
更新頻度の高い文書は、差分取り込みや定期再インデックスの仕組みを用意するのが代表的な方法です。ただし、自動更新にすると誤情報や未承認文書も取り込みやすくなるため、承認フローや更新元の信頼性確認をあわせて設計することが重要です。
RAGを安全に活用するための考え方を整理しよう
RAGを導入するときに重要なのは、「回答精度が上がるか」だけで判断しないことです。
業務で使う以上、どの情報を検索対象にし、誰が何を見られ、どのような形で回答へ反映されるのかまで設計できて初めて、安全に使える仕組みになります。
導入前には、対象データの範囲、権限制御の方法、回答品質の評価基準、ログと監査の設計を優先して整理しておきましょう。
まずは対象業務を限定し、利用部門、参照文書、回答失敗時の扱いを整理したうえで、小さく検証を始めるのが現実的です。
エラビサキでは、RAG開発会社の対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。