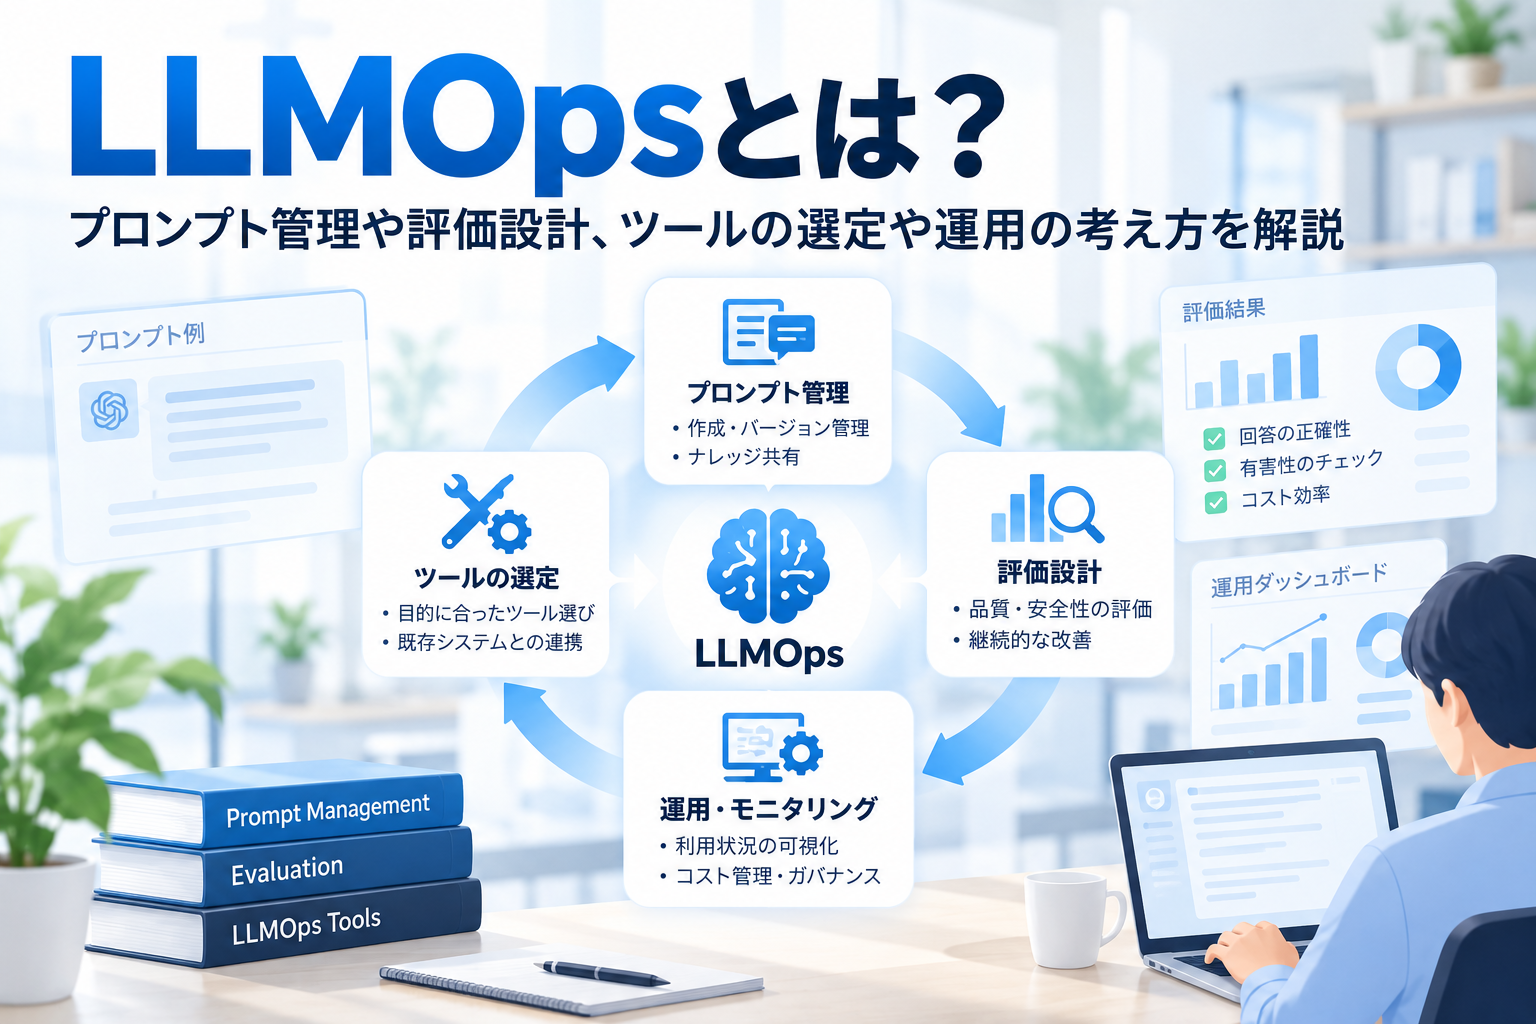
LLMOpsとは?プロンプト管理や評価設計、ツールの選定や運用の考え方を解説
社内向けチャットボットやナレッジ検索、問い合わせ対応の自動化などで、LLMが利用されることがあります。
ただし、実際に本番運用へ進めようとすると、モデルをつないで終わりでは済みません。
回答品質をどう評価するのか、プロンプトやモデル変更の影響をどう管理するのか、誤回答やコスト増をどう監視するのかといった論点が一気に出てきます。
そこで重要になるのがLLMOpsです。
LLMOpsは、LLMを使ったアプリケーションを継続的かつ安全に運用するための考え方であり、評価・モニタリング・ガバナンス・改善の仕組みまで含めて設計する視点を指します。
この記事では、LLMOpsの基本概念を整理したうえで、MLOpsとの違い、運用で重要になる管理項目、RAGやファインチューニングとの使い分け、さらに本番運用で押さえたいセキュリティやツール選定の考え方まで、実務目線でわかりやすく解説します。
LLMOpsとは
LLMOpsとは、Large Language Model(大規模言語モデル)を使ったシステムを、継続的に評価・監視・改善しながら本番運用するための運用概念です。
機械学習モデルの運用を扱うMLOpsの考え方を土台にしつつ、LLM特有の課題であるプロンプト管理、回答品質評価、ガードレール設計、コスト監視などを含めて扱う点に特徴があります。
たとえば、業務用の生成AIチャットを導入した場合、導入直後は問題なく見えても、データの更新、利用者の増加、プロンプト変更、モデル切り替えによって回答品質や費用が変わることがあります。
LLMOpsの本質は、LLMを「作ること」よりも「安定して使い続けること」を設計する点にあります。
そのため、対象はモデル単体ではありません。
実務では、プロンプト、RAGによる検索結果、評価データ、ログ、監視指標、承認フロー、アクセス権限までが管理対象になりやすく、本番運用では整理しておくと役立ちます。
そもそもLLMを使ったプロダクト全体の流れを整理したい場合は、LLM開発の記事もあわせて確認すると、開発から運用までのつながりを理解しやすくなります。
LLMOpsとMLOpsの違い
LLMOpsとMLOpsは似た言葉ですが、重視する運用対象が少し異なります。
MLOpsは、主に予測モデルや分類モデルなどの機械学習システムを継続運用するための仕組みです。
一方でLLMOpsは、LLMを使った対話型・生成型アプリケーションの運用を前提としており、出力の揺らぎや評価の難しさを前提に設計する必要があります。
MLOpsの全体像を先に整理したい方は、MLOpsの解説も参考になります。
| 観点 | MLOps | LLMOps |
|---|---|---|
| 主な対象 | 予測・分類などの機械学習モデル | LLMを使った生成AIアプリケーション |
| 出力の性質 | 比較的定型で評価しやすい | 自然文で揺らぎが大きい |
| 評価方法 | 精度・再現率など定量指標中心 | 定量評価と人手評価の併用が有効な場面がある |
| 管理対象 | 学習データ、特徴量、モデル、パイプライン | モデル、プロンプト、RAG、ガードレール、ログ |
| 主な運用課題 | 精度劣化、データドリフト、再学習 | 幻覚、プロンプト変更影響、コスト、権限制御 |
とくに大きい違いは、LLMの出力が確率的で、同じ入力でも毎回まったく同じ答えになるとは限らない点です。
そのため、MLOpsでよく使われる単一の精度指標だけでは、品質を十分に判断しにくい場面があります。
また、LLMOpsではモデルそのものだけでなく、プロンプトや参照データの設計によって結果が大きく変わることがあります。
RAGを組み合わせる場合は、検索部分の品質が回答品質に直結するため、アプリ全体で運用品質を見なければならないでしょう。
つまりLLMOpsは、モデル運用だけでなく「アプリケーション全体の振る舞い」を管理する発想が不可欠です。
LLMOpsで重要な運用要素
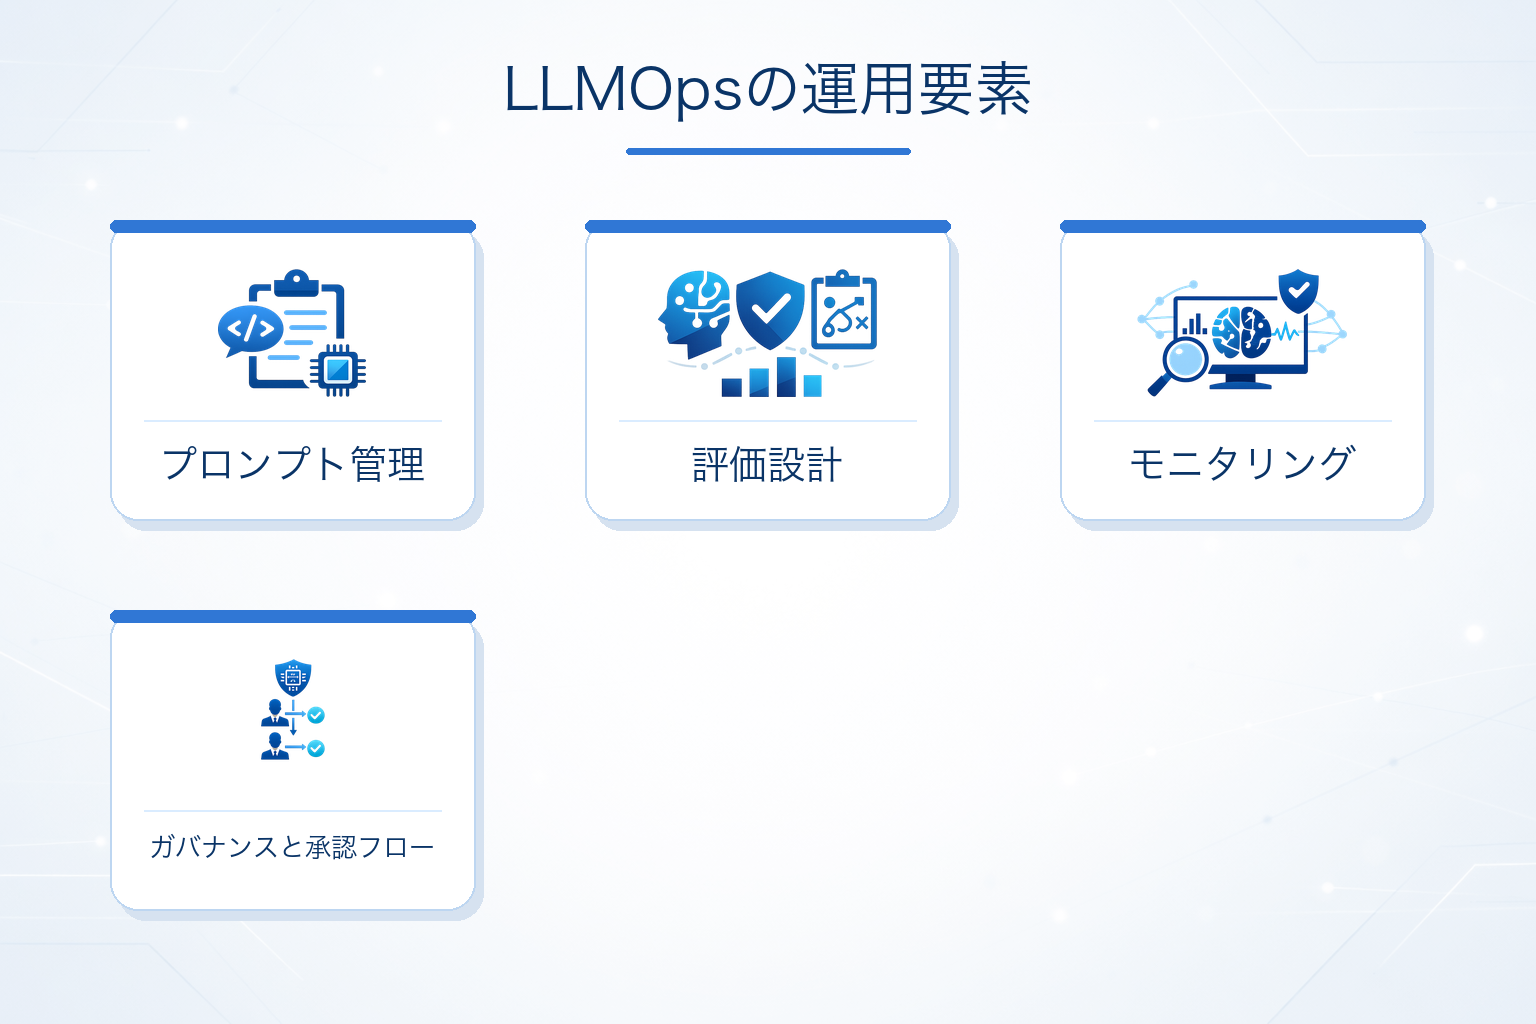
LLMOpsを実務で考えるときは、単にツールを導入する前に、何を管理対象にするのかを整理することが大切です。
とくに重要なのは、次のような運用要素です。
- プロンプト管理
- 評価設計
- モニタリング
- ガバナンスと承認フロー
- バージョン管理と変更履歴
- ログ収集と改善サイクル
プロンプト管理
LLMアプリでは、コードだけでなくプロンプト自体が挙動を左右します。
プロンプトを少し変えただけで、回答の丁寧さ、根拠の出し方、禁止事項への反応、JSON出力の安定性まで変わることがあります。
そのため、プロンプトは場当たり的に修正するのではなく、バージョンを切って管理し、いつ・誰が・何の目的で変更したのかを追える状態にしておきたいところです。
また、テンプレート化や変数化を進めると、業務ごとにプロンプトを再利用しやすくなります。
評価設計
LLMOpsで難しいのが評価です。
自然文の生成では、正解が1つに定まらないケースも多いため、単純な正誤判定だけでは不十分になりがちです。
たとえば、正確性、関連性、根拠の有無、禁止事項違反、回答形式の遵守といった複数観点で評価軸を設計する必要があります。
さらに、重要業務や高リスク用途では自動評価だけに頼らず、人手レビューを併用した方が安全です。
評価指標を決めずに本番投入すると、改善の成否を判断できず、運用が属人化しやすくなります。
モニタリング
LLMOpsのモニタリングでは、システムが落ちていないかを見るだけでは足りません。
以下のように、品質・利用状況・コストの3方向から監視する視点があると実務で役立ちます。
- 回答失敗率、タイムアウト、レイテンシー
- 想定外の応答やガードレール違反の発生
- 利用回数、ユーザー部門ごとの利用傾向
- トークン消費量、API呼び出し回数
- モデルやプロンプト変更後の品質差分
とくに生成AIは、障害が起きていなくても「答えてはいるが質が下がっている」という状態が起こります。
このような品質劣化を検知するには、単なるインフラ監視にとどまらない設計が必要です。
ガバナンスと承認フロー
業務で使うLLMは、誰でも自由に変更できる状態にしないことが重要です。
モデルの切り替え、プロンプト修正、参照データの変更、公開範囲の拡大などは、利用部門と情報システム部門、場合によっては法務やセキュリティ部門を含めた承認フローで管理した方がよいでしょう。
また、監査ログを残せるようにしておくと、後から問題発生時の原因追跡がしやすくなります。
バージョン管理と変更履歴
LLMOpsでは、モデルだけでなく、プロンプト、評価データ、RAGの参照元、ガードレール設定なども変更対象になります。
どの組み合わせで評価し、どの変更で品質が上下したのかを追えないと、改善ではなく場当たり対応になりやすくなります。
少なくとも、変更前後の差分、変更理由、評価結果、承認者をひも付けて残せる形にしておくと、回帰の確認や監査対応がしやすくなります。
ログ収集と改善サイクル
LLMOpsは、一度作って終わりの仕組みではありません。
実運用の会話ログや失敗事例を集め、評価データへ反映し、再評価しながら改善を回すことが前提になります。
RAGを使う場合は検索ヒット率や参照文書の適合性も含めて確認すると、回答品質の改善につながりやすくなります。
RAG型システムの構成や改善観点を詳しく知りたい場合は、RAG構築の解説も役立ちます。
RAG・ファインチューニング・プロンプトエンジニアリングの使い分け
LLMOpsの現場で迷いやすいのが、改善手段として何を選ぶべきかという論点です。
回答品質を上げたいからといって、すぐにファインチューニングを選ぶ必要はありません。
まずは課題の種類を見極め、適切な手段を選ぶことが重要です。
プロンプトエンジニアリングが向いている場面
出力形式をそろえたい、回答トーンを統一したい、不要な表現を減らしたいといった課題なら、まず見直すべきはプロンプトです。
比較的低コストで試しやすく、変更スピードも速いため、初期改善の第一候補になりやすいでしょう。
ただし、プロンプト改善だけでは、モデルが持っていない社内知識を補うことはできません。
RAGが向いている場面
最新の社内文書やFAQ、マニュアル、規程類などを参照して回答させたい場合は、RAGが有効です。
モデル自体を学習し直さなくても、外部知識を検索して文脈に加えられるため、更新頻度の高い情報を扱いやすくなります。
たとえば、就業規則、製品マニュアル、社内ヘルプデスクFAQ、営業提案書テンプレートのように、定期的に内容が変わる文書群との相性がよいでしょう。
一方で、RAGは検索精度やデータ整備の影響を強く受けます。
そのため、LLMOpsでは回答だけでなく、検索結果の妥当性まで含めて評価・監視する必要があります。
ファインチューニングが向いている場面
特定業界の言い回しに最適化したい、分類や抽出など一定の出力傾向を強く持たせたい、プロンプトだけでは安定しない振る舞いを改善したい場合には、ファインチューニングが候補になります。
たとえば、問い合わせ文のカテゴリ分類、請求書や申込書からの項目抽出、社内基準に沿った定型文生成のように、繰り返し発生するタスクでは検討余地があります。
ただし、学習データ整備、再評価、モデル更新時の追随が必要になるため、運用負荷は高めです。
ファインチューニングの進め方や適したケースを詳しく知りたい場合は、LLMファインチューニングの記事も参考になるでしょう。
| 手段 | 向いている課題 | 主な注意点 |
|---|---|---|
| プロンプトエンジニアリング | 出力形式、指示の明確化、応答トーン調整 | 複雑な知識補完には限界がある |
| RAG | 最新情報、社内文書参照、根拠付き回答 | 検索品質とデータ整備が成否を左右する |
| ファインチューニング | 特定タスクへの最適化、応答傾向の安定化 | 学習データ整備と継続運用の負荷が高い |
改善手段は「高度そうなもの」から選ぶのではなく、課題が知識不足なのか、指示不足なのか、挙動の安定性不足なのかで判断することが大切です。
LLMOpsで押さえたいセキュリティ
LLMOpsを本番運用へ進めるとき、見落としやすいのがセキュリティです。
PoCでは問題なく見えても、利用範囲が広がると情報漏えいリスクや権限設計の不備が顕在化しやすくなります。
入力データとログの取り扱い
LLMアプリでは、入力文そのものに機密情報が含まれる可能性があります。
顧客情報、契約情報、人事情報、未公開の社内資料などを扱うなら、どのデータをどこまで送信してよいかを事前に明確にしておくことが大切です。
あわせて、会話ログや評価用ログに何を保存するか、保存期間をどうするかも整理しておきたいところです。
アクセス権限と参照範囲
とくにRAGでは、参照データの公開範囲を誤ると、検索できてはいけない文書が回答に使われるおそれがあります。
部門別の閲覧権限、役職ごとのアクセス制御、検索基盤側の権限反映など、アプリ側だけでなくデータ基盤側も含めて確認する必要があります。
不正利用とガードレール対策
LLMアプリでは、プロンプトインジェクションや想定外入力によって、意図しない出力が発生することがあります。
そのため、入力フィルタリング、禁止事項チェック、出力制御、監査ログの保存、異常利用時のアラート設定などを組み合わせて対策を考えることが重要です。
- 入力データに機密情報や個人情報が含まれないか
- ログ保存先と保存期間が適切か
- アクセス権限が部門や役割に応じて制御されているか
- モデルや外部APIへの送信範囲が把握できているか
- 監査ログを残せるか
- プロンプトインジェクションや不正利用への対策があるか
LLMOpsに役立つツールの選定観点
LLMOps領域では、評価・監視・トレース・ガバナンスなどを担うツールが複数存在しますが、個別の知名度だけで選ばない方が安全です。
自社の運用課題に合っていなければ、ログは取れても改善につながらない、あるいは評価機能はあっても既存環境と統合しづらい、といったことが起こりえます。
選定時に見たい観点は、次の5つです。
1. 何を管理したいのか
まず、監視したいのがコストなのか、プロンプトなのか、RAG評価なのか、あるいは承認フローなのかを明確にしましょう。
同じLLMOpsツールでも、得意領域は異なります。
たとえば、プロンプト実験と比較評価に強いツール、トレースやログ可視化に強いツール、RAGの検索評価に向くツール、ガバナンスや監査対応を重視したプラットフォームなど、役割は分かれています。
2. 既存開発基盤とつながるか
CI/CD、クラウド監視、社内認証基盤、データ基盤など、既存環境と連携できるかは重要です。
統合しにくいツールを選ぶと、ログが分散して運用負荷が上がる可能性があります。
3. 評価ワークフローを回せるか
本番運用では、単にリクエストを記録するだけでなく、テストケースによる比較評価、バージョン差分の確認、人手レビューとの接続などが必要になります。
評価フローを回しやすいかどうかは、長期運用で差が出やすい部分です。
4. データ主権と運用形態に合うか
SaaSで手軽に始めたいのか、自己ホストや厳格なデータ管理が必要なのかによって、選ぶべき構成は変わります。
社内規定や業界要件が厳しい場合は、ログ保存場所や送信データ範囲まで確認が必要です。
5. 小さく始めて拡張できるか
最初から機能を盛り込みすぎると、現場が使いこなせないことがあります。
小規模チームでも運用できるか、将来的にユーザー数や対象業務が増えても拡張できるかを見ておくと、導入後の手戻りを減らせます。
また、AIエージェントのようにツール実行や複数ステップ処理を含む構成では、評価や監視の難易度が一段上がります。
そのため、将来的に高度な自動化を視野に入れるなら、AIエージェント構築の要件も意識した基盤設計が必要です。
LLMOpsを導入・運用するときの進め方
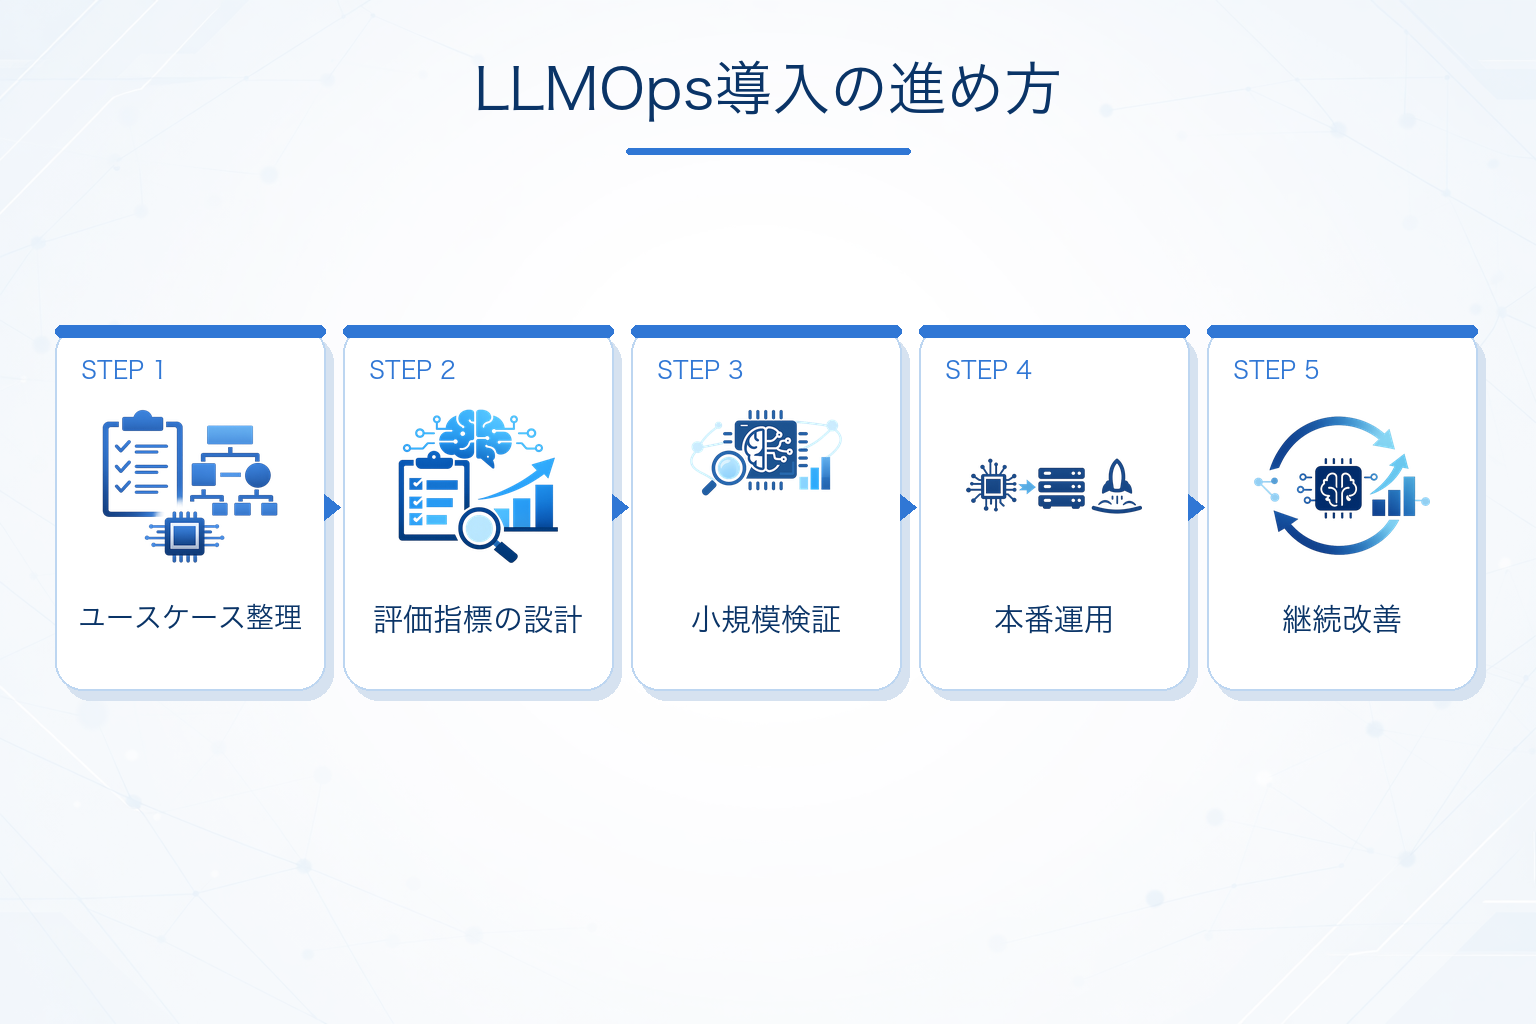
LLMOpsは、いきなり大規模導入するより、対象業務を絞って評価可能な形で始める方が進めやすくなります。
一般的には、次のような流れで進めると整理しやすいでしょう。
- 対象ユースケースと業務目的を整理する
- 品質要件と評価指標を決める
- モデル、RAG、プロンプトの方針を選ぶ
- ログ収集とモニタリング設計を行う
- 小規模なPoCで検証する
- 本番運用へ移行する
- 継続的に評価・改善を回す
1. 対象ユースケースと業務目的を整理する
最初の工程で大切なのは、「何のためにLLMを使うのか」を明確にすることです。
問い合わせ一次対応なのか、社内検索なのか、文書要約なのかで、求められる品質も許容リスクも変わります。
ここが曖昧だと、後工程の評価設計もぶれやすくなります。
2. 品質要件と評価指標を決める
次に重視したいのが、PoC前の評価指標設計です。
たとえば、正答率だけでなく、根拠提示率、禁止事項違反率、平均応答時間、1件あたりのコストなど、実運用に直結する指標を先に決めておくと、PoCの結果を判断しやすくなります。
3. モデル、RAG、プロンプトの方針を選ぶ
課題が知識不足なのか、出力形式の不安定さなのか、専門タスクへの最適化なのかによって、取るべき手段は変わります。
この段階で、まずプロンプト改善で試すのか、RAGを加えるのか、将来的にファインチューニングまで視野に入れるのかを整理しておくと、検証設計が進めやすくなります。
4. ログ収集とモニタリング設計を行う
本番を見据えるなら、PoC段階からログ設計を後回しにしないことが重要です。
入力・出力、参照文書、評価結果、エラー、レイテンシー、利用量など、後で見返すべき情報を決めておくと、改善サイクルを回しやすくなります。
5. 小規模なPoCで検証する
PoCでは、成功例だけでなく失敗例を意図的に集めることも重要です。
想定外の質問、権限外データへのアクセス要求、長文入力、曖昧な指示などを含めて試すと、本番前に弱点を見つけやすくなります。
6. 本番運用へ移行する
本番移行時には、承認フロー、アラート条件、障害時の切り戻し方針、問い合わせ窓口なども整理しておきたいところです。
評価結果が一定水準を満たした後も、公開範囲を段階的に広げる進め方の方が安全な場合があります。
7. 継続的に評価・改善を回す
本番移行後は、モデルやプロンプトを更新するたびに再評価できる状態を作りましょう。
LLMOpsは導入時よりも、変更後に品質とコストを保てるかどうかが成否を分けます。
LLMOpsに関するよくある質問
Q.1 LLMOpsとは何ですか?
LLMOpsとは、LLMを使ったアプリケーションを継続的に評価・監視・改善しながら本番運用するための考え方です。モデル管理だけでなく、プロンプト、RAG、ログ、評価、ガバナンスまで含めて扱う点が特徴です。
Q.2 LLMOpsとMLOpsの違いは何ですか?
MLOpsは主に機械学習モデルの継続運用を対象とし、LLMOpsは生成AIアプリケーション全体の運用に重点があります。LLMOpsでは、自然文出力の揺らぎ、プロンプト管理、回答品質評価、コスト監視など、LLM特有の論点をより強く扱います。
Q.3 LLMOpsで評価が難しいのはなぜですか?
LLMの出力は自然文で、正解が1つに定まらないケースが多いためです。単純な精度指標だけでは判断しにくく、正確性、関連性、禁止事項違反、根拠提示など複数軸で見る必要があります。重要業務や高リスク用途では、自動評価と人手評価を併用することも有効です。
Q.4 LLMOpsでは何をモニタリングすべきですか?
レイテンシーやエラー率だけでなく、回答品質の劣化、ガードレール違反、トークン消費量、API利用量、利用部門ごとの傾向なども監視対象になります。RAGを使う場合は、検索結果の妥当性や参照文書の質も見ておきたいところです。
Q.5 RAGとファインチューニングはどう使い分ければよいですか?
最新の社内文書や外部知識を参照させたいならRAGが向いています。一方、特定タスクに応答傾向を最適化したい、出力スタイルをより安定させたい場合はファインチューニングが候補になります。まずは課題が知識不足なのか、モデル挙動の安定性不足なのかを切り分けることが大切です。
Q.6 プロンプト管理はなぜ必要ですか?
プロンプトはLLMアプリの挙動を大きく左右するためです。少しの変更でも回答品質や形式、禁止事項への反応が変わることがあるので、コードと同じようにバージョン管理し、変更履歴と評価結果をひも付けて運用するのが望ましいでしょう。
LLMOpsを実運用できる形で設計しよう
LLMOpsで重要なのは、LLMを導入したかどうかではなく、継続して安全に改善できる運用設計になっているかです。
評価方法、プロンプト管理、監視体制、権限設計まで含めて整備し、変更後も品質を確認できる状態を作ることが、実務では重要です。
まずは対象業務を絞ってPoCを行い、失敗例も含めて評価基盤を整えるところから始めると、自社に合うLLMOpsの形を見つけやすくなります。
エラビサキでは、LLM開発や生成AI運用に関する対応領域・提供形態・実績・料金などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。