【入門編】生成AIを活用したRAG導入方法をわかりやすく解説|仕組みや検索方式、注意点まで
RAGを導入したいと考えたとき、まず気になるのは「生成AIに社内文書をどう参照させるのか」「通常のチャットAIと何が違うのか」といった基本の部分ではないでしょうか。
とくに、社内FAQや規程集、マニュアル、設計資料のように情報が散在している業務では、RAGの活用余地が大きくなります。
一方で、仕組みを理解しないまま導入すると、検索精度が出ない、文書が古くて誤回答につながる、権限制御が不十分で情報管理リスクが生じる、といった問題も起こり得ます。
そのため、RAGは単にツールを入れれば終わりではなく、対象業務や参照文書の整理、検索方式の選定、評価方法の設計、運用改善まで含めて考えることが重要です。
この記事では、RAGの基礎知識や仕組みを押さえたうえで、導入前に決めるべきこと、具体的な導入ステップ、検索方式、評価・改善の方法、活用例や注意点までを実務目線で整理します。
自社でRAGを導入すべきか判断したい担当者の方は、全体像をつかむところから読み進めてみてください。
RAGとは?
RAGは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と訳されます。
生成AIが回答を作る前に、外部の文書やデータベースから関連情報を検索し、その内容を踏まえて回答を生成する仕組みです。
RAGを使わずに生成AIを利用する場合、モデルが持つ学習済みの知識だけでは、社内独自の情報や最新資料に十分対応できないことがあります。
一方、RAGでは質問のたびに関連文書を取り出して参照できるため、社内規程、商品仕様、過去の問い合わせ履歴などを使った回答がしやすくなります。
RAGの本質は、生成AIに「自社で持つ根拠情報」を参照させながら回答させることにあります。
そのため、社内FAQ、ヘルプデスク、マニュアル検索、営業資料検索、法務・人事文書の照会など、正確性と根拠提示が求められる業務と相性がよいでしょう。
RAGの仕組み
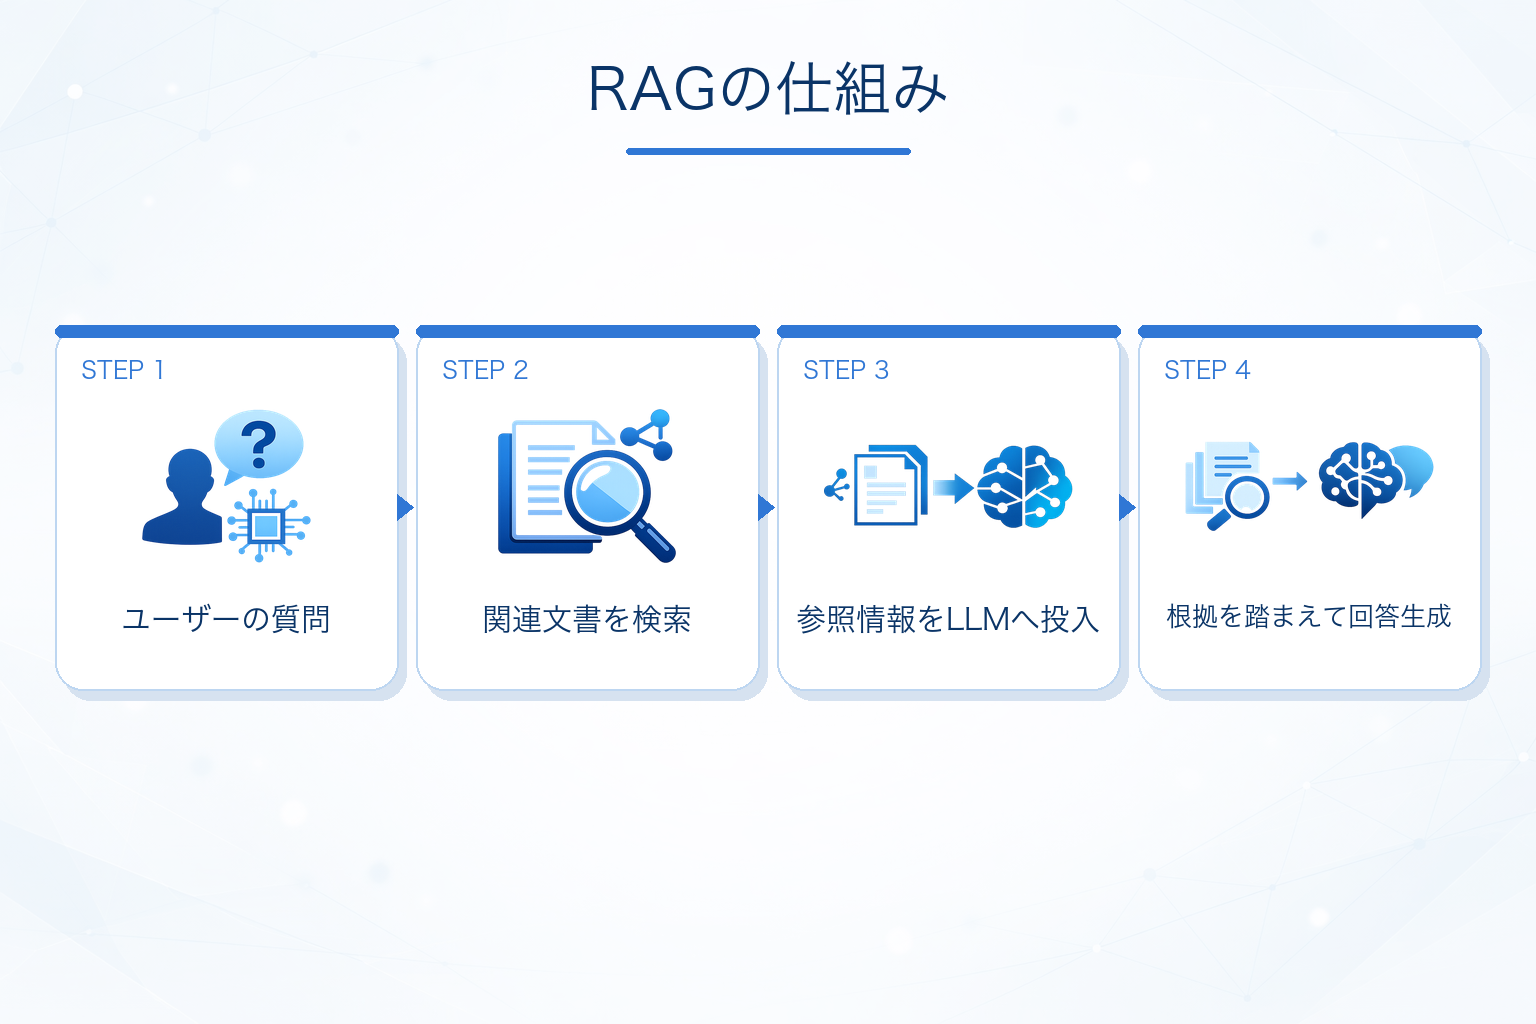
RAGの基本的な流れは、質問を受けて関連文書を検索し、その結果を生成AIへ渡して回答させるというものです。
大まかには、次の4段階で理解するとつかみやすくなります。
- ユーザーが質問する
- 関連する文書やデータを検索する
- 検索結果を生成AIへ渡す
- 参照情報をもとに回答を生成する
たとえば「この商品の返品条件は?」という質問が来た場合、RAGはまず社内の規程集やFAQ、マニュアルから該当箇所を検索します。
そのうえで、該当文書の内容を根拠として回答文を作るため、一般知識だけで答える場合よりも業務文脈に合った返答がしやすくなります。
また、参照元の文書名やURL、抜粋を併せて表示する設計にすれば、利用者が回答の根拠を確認しやすくなります。
これは、ハルシネーションを抑えるための対策としても有効です。
ただし、RAGを使えば必ず正しく答えられるわけではありません。
検索で誤った文書を拾えば、その情報をもとに不正確な回答を生成する可能性があるため、検索精度と文書品質の両方が重要になります。
RAG導入の前に決めるべきこと
RAG導入を成功させるには、実装前の要件整理が欠かせません。
ここが曖昧なままだと、検索方式や評価基準がぶれ、PoCで何をもって成功とするのか判断できなくなります。
導入前には、少なくとも次の点を整理しておきたいところです。
- どの業務に使うのか
- どの文書やデータを参照対象にするのか
- 誰が使うのか
- 文書の更新頻度はどの程度か
- 回答精度をどう評価するのか
- 根拠表示や権限制御をどう設計するのか
たとえば、社内FAQ向けなのか、法務文書検索なのか、カスタマーサポート支援なのかで、必要な精度もUIも変わります。
また、対象文書がPDF中心なのか、構造化データなのか、画像や表を含むのかによって、前処理やOCRの要否も変わるでしょう。
さらに重要なのが評価基準です。
「回答が自然か」だけでは不十分で、正答性、根拠の妥当性、必要な文書を検索できているか、回答できない質問への挙動なども確認する必要があります。
PoC前に成功条件を決めておかないと、精度改善を続けても導入可否を判断しにくくなります。
RAGの導入方法
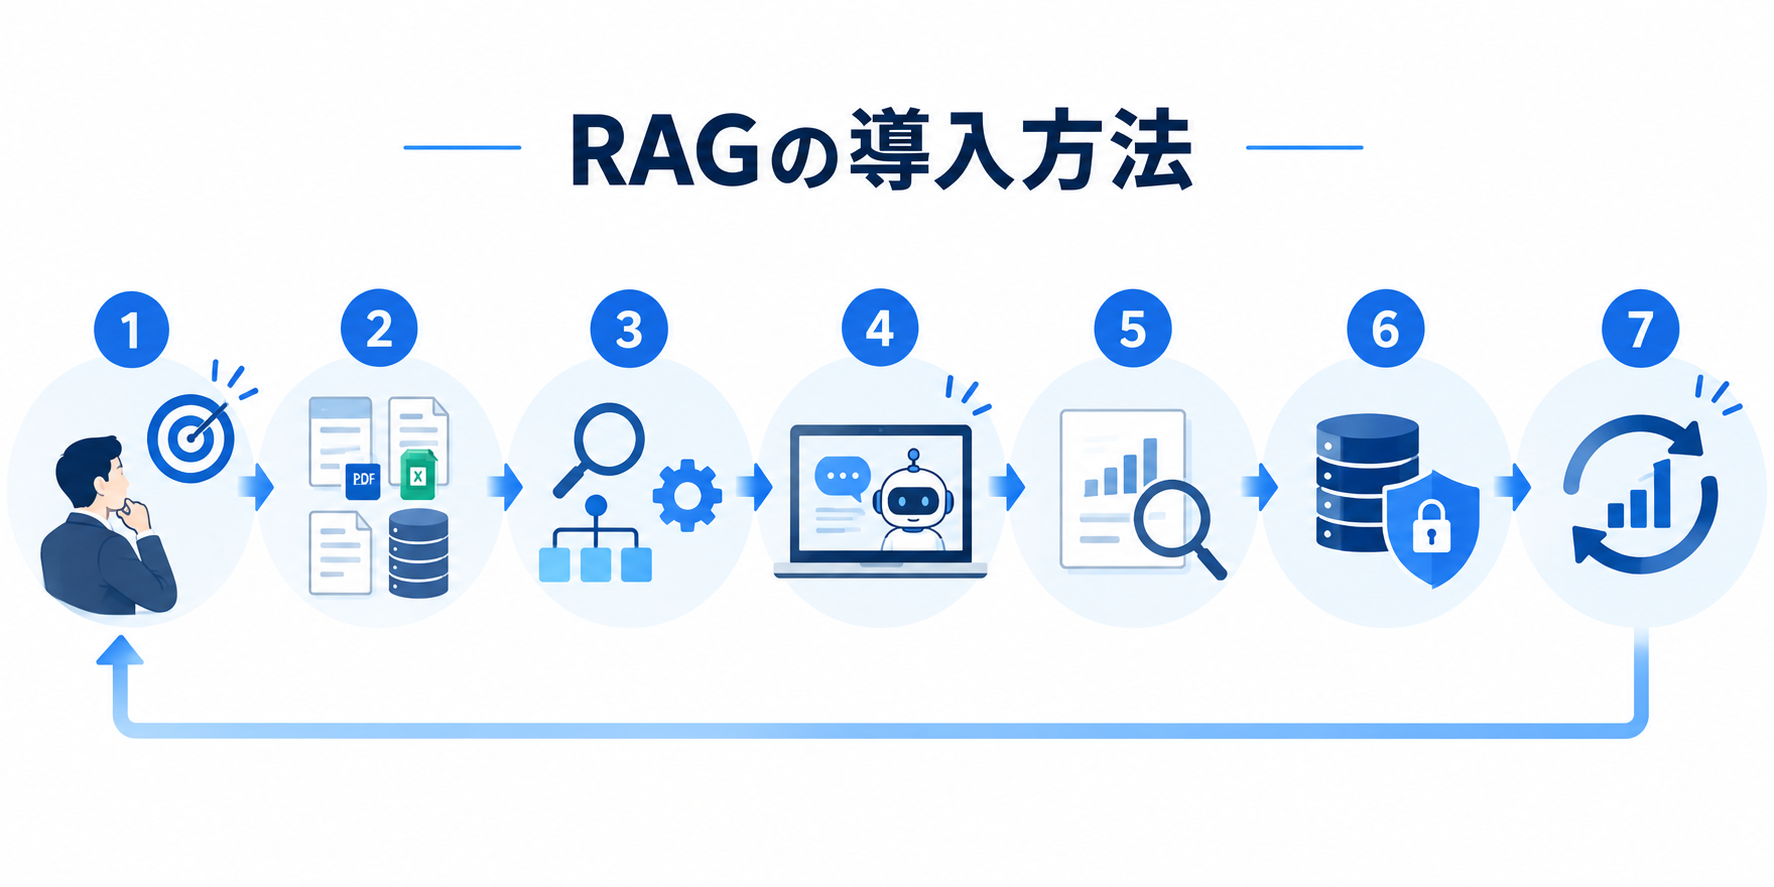
RAG導入は、一般的に次のような流れで進みます。
- 対象業務と目的を決める
- 対象文書・データを整理する
- 検索方式と構成方針を決める
- PoCを実施する
- 精度を評価して改善する
- 本番導入と権限制御を整える
- 運用・継続改善を行う
最初の工程では、何のためにRAGを導入するのかを明確にします。
たとえば、問い合わせ対応の工数削減、検索時間短縮、一次対応品質の平準化など、業務KPIに落とし込める形にすると評価しやすくなります。
次に、参照対象となる文書を整理します。
このとき、古い版の文書、重複ファイル、表記ゆれの大きいデータが多いと精度に影響しやすいため、データ整備は軽視できません。
そのうえで、対象業務に適した検索方式やシステム構成を検討します。
PoCでは、いきなり全社の文書を対象にするのではなく、検証対象を絞って始めると評価しやすくなります。
たとえば「人事規程だけ」「製品マニュアルだけ」「問い合わせ履歴だけ」のように範囲を絞り、検索方式やチャンク分割、プロンプト設計の妥当性を検証します。
その後、検索結果と回答内容を評価し、必要に応じてチャンクサイズ、メタデータ、検索方式、再ランキング、プロンプトなどを改善します。
本番導入に進む段階では、SSO連携、アクセス権、監査ログ、文書更新の運用まで含めて整備する必要があります。
費用面では、PoC、本番構築、運用保守を分けて考えると比較しやすくなります。
また、導入形態には、既存のSaaSを利用する方法、ローコード・ノーコード製品を活用する方法、クラウドサービスを組み合わせて構築する方法、個別に開発する方法などがあります。
費用体系も、PoC単位のプロジェクト費、初期構築費、月額利用料、APIやインフラの従量課金など、導入形態によって異なります。
どの構成・料金体系になるかは、対象データの量と品質、OCRの有無、セキュリティ要件、既存システム連携、求める検索精度、利用量、更新頻度などによって変わります。
見積もりを見るときは、PoC費用と本番費用が分かれているか、月額運用費とAPI・インフラの従量課金が分離されているか、データ整備や再インデックス、権限制御、監査ログ、精度改善対応が含まれているかを確認しましょう。
RAGで使われる検索方式
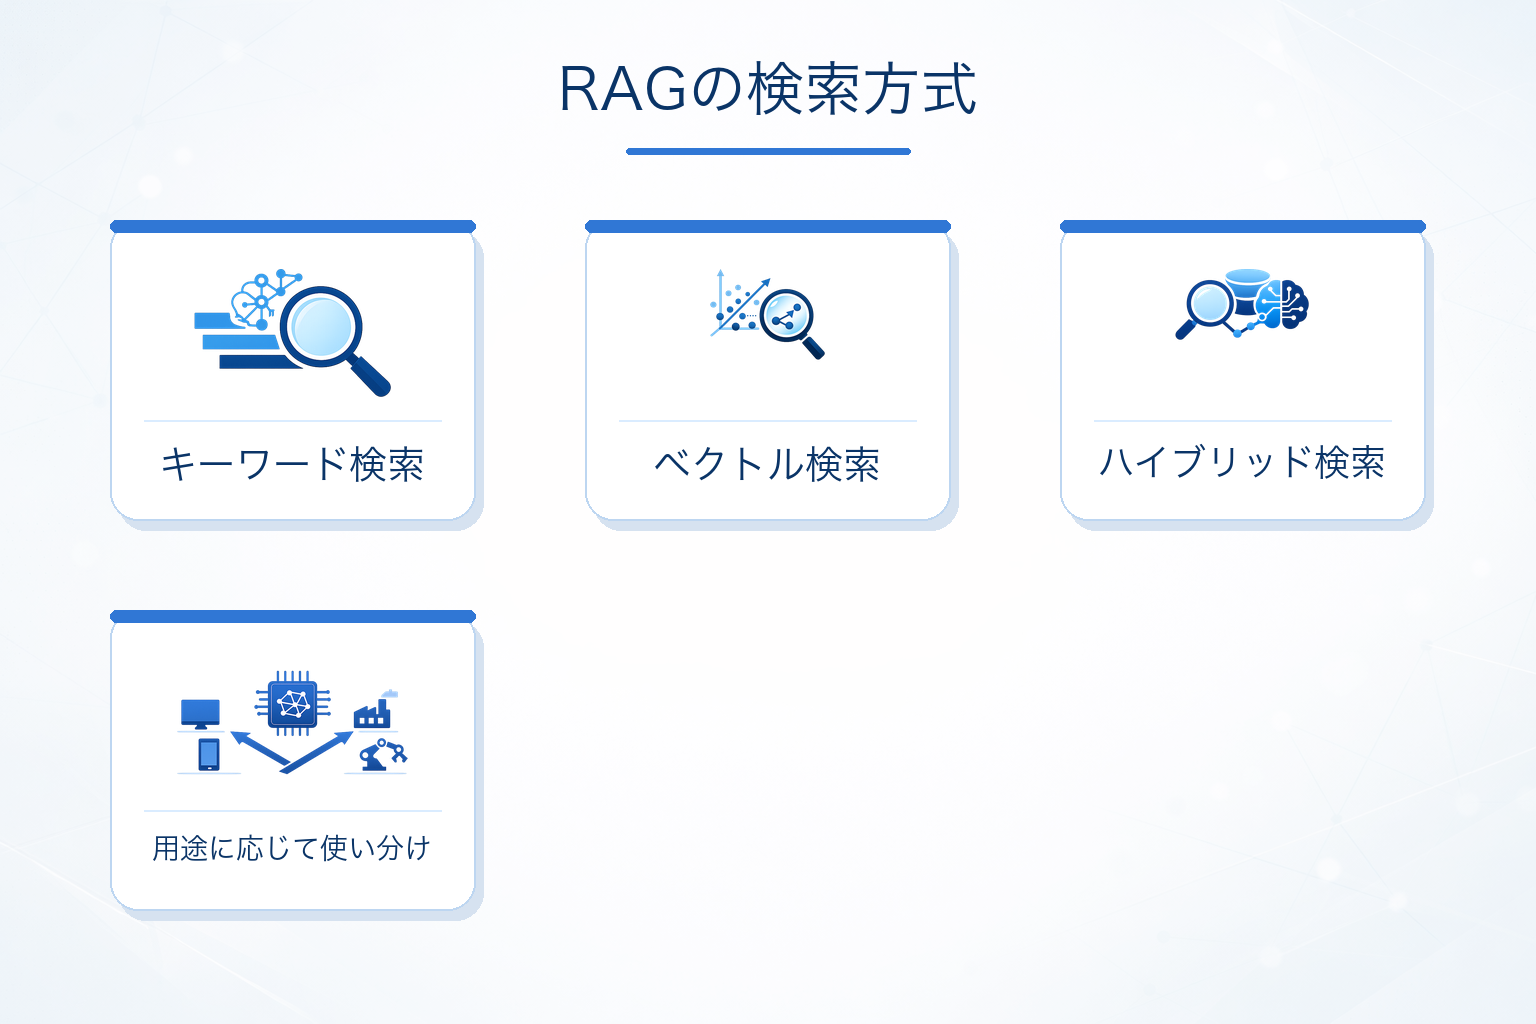
RAGの品質を左右する大きな要素が検索方式です。
同じ文書群を使っても、どの方式を選ぶかによって、ヒットする情報や回答精度は変わります。
代表的なのは、キーワード検索、ベクトル検索、ハイブリッド検索の3つです。
キーワード検索
キーワード検索は、入力された語句と文書内の単語一致などをもとに検索する方式です。
社内規程名、製品名、型番、エラーコードのように、明確な単語で探したい情報には向いています。
一方で、質問文と文書側の表現が違うとヒットしにくいのが弱点です。
たとえば、利用者が「解約したい」と尋ねても、文書側に「契約終了手続き」としか書かれていない場合、取りこぼしが起きることがあります。
ベクトル検索
ベクトル検索は、文章をベクトル化し、意味的な近さをもとに検索する方式です。
質問文と文書の表現が多少違っていても、意味が近ければ候補として見つけやすくなります。
そのため、自然文での問い合わせが多い社内FAQやヘルプデスクでは有効です。
ただし、意味の近さで拾うぶん、型番や条文番号のような厳密一致が重要なケースでは、意図しない候補が含まれることもあります。
ハイブリッド検索
ハイブリッド検索は、キーワード検索とベクトル検索を組み合わせる方式です。
厳密一致と意味検索の両方を活用できるため、複数の検索要件が混在する業務では有力な選択肢になります。
表記ゆれのある自然文にはベクトル検索、型番や規程番号にはキーワード検索が有効な場合があり、両者を組み合わせることで検索精度を高められるケースがあります。
どの方式が適しているかは、対象データと質問の性質によって異なります。
製品番号や条文番号など正確な語句一致が重要ならキーワード検索を活用し、自然文による検索が中心ならベクトル検索を検討するなど、実際の質問データを使って比較することが重要です。
RAG導入後の評価と改善の考え方
RAGは導入して終わりではなく、運用しながら精度と業務効果を改善していく前提で考えたい仕組みです。
導入初期から完璧を目指すより、評価指標を定めて改善サイクルを回すほうが現実的です。
評価では、次のような観点を分けて見ると整理しやすくなります。
- 検索で適切な文書を拾えているか
- 回答が質問に対して正しいか
- 根拠表示が妥当か
- 回答できない質問に無理に答えていないか
- 業務時間短縮や問い合わせ削減につながっているか
たとえば、正答率が低い場合でも、原因は生成AIではなく検索側にあるかもしれません。
その場合、チャンク分割の見直し、メタデータ付与、検索方式の変更、再ランキングの導入などが改善策になります。
一方、検索では適切な情報を取得できているのに回答が不安定なら、プロンプト設計や回答フォーマットなど、生成側の見直しが必要でしょう。
このように、RAGでは「検索の問題」と「回答生成の問題」を分けて評価することが重要です。
業務効果を見るなら、検索時間、回答作成時間、一次解決率、問い合わせ件数、利用率などの指標も追いたいところです。
評価と改善を継続することで、RAGは単なる実験ではなく、現場で使われる業務基盤へ近づいていきます。
RAGを導入するメリット
RAGのメリットは、単に生成AIを業務に取り入れられることだけではありません。
自社文書を参照して回答できることで、検索効率やナレッジ活用、回答品質の面で改善を狙いやすくなります。
- 社内情報をもとに回答しやすくなる
- ハルシネーションを抑制しやすい
- 文書検索や問い合わせ対応の時間を短縮しやすい
- ナレッジの属人化を減らしやすい
- 参照文書を更新することで新しい情報を反映しやすい
とくに現場で実感されやすいのは、検索や回答作成の効率化です。
担当者が複数の資料を横断して調べていた業務を、質問ベースで絞り込めるようになるため、一次対応のスピードを上げられる可能性があります。
また、モデル自体を再学習させなくても、参照対象となる文書を更新することで、新しい情報を回答へ反映しやすい点もメリットです。
もちろん、データ整備や評価設計は必要ですが、「社内文書を活用した回答基盤」を作りたい場合、RAGは有力な選択肢の一つでしょう。
RAGで成果が出た企業の具体例
RAGのメリットは概念だけでは伝わりにくいため、ここでは公式情報で確認できた国内企業の事例を紹介します。
いずれも、検索時間短縮、回答作成の効率化、調査工数の削減など、RAG導入による変化が比較的わかりやすい事例です。
トヨタ自動車株式会社|問い合わせへの回答・調査工数を約20%削減見込み
トヨタ自動車は、部門ごとに個別構築されていたRAG環境の分散や、認証・アクセス制御の一元化を課題としていました。
そこで、AWS上に社内認証と統合したセキュアなRAG基盤を構築し、自動車設計情報管理部門の問い合わせ対応や調査業務に適用しています。
公式事例では、問い合わせへの回答・調査工数について、机上計算で約20%の削減を見込んでいるとされています。また、検証段階では、RAGに登録されている情報に関する質問という条件下で、約50%の調査工数削減が報告されています。
RAGは精度だけでなく、アクセス権や認証を含めた社内利用基盤として設計することが重要だとわかる事例です。
ヤンマーホールディングス株式会社|社内検索で1人当たり月20分短縮
ヤンマーホールディングスでは、ベテランの知見継承や文書検索のしにくさ、業務の属人化が課題になっていました。
そこで、社内情報共有基盤上の文書を自動取り込みし、自然言語の質問に対して参照元リンク付きで答えるRAG基盤を構築しています。
公式事例によると、社内内規検索では1人当たり月20分短縮、利用者約60人で月1,200分の効果が確認されました。
さらに別業務でも、カスタマーサービス時間の短縮や設計資料検索の効率化が示されており、複数部門での活用が進められています。
株式会社セゾンテクノロジー|回答作成時間を最大30%短縮
セゾンテクノロジーでは、数万ページのマニュアルやFAQ、過去問い合わせ履歴から回答を作る必要があり、若手サポートエンジニアを中心に検索や回答作成の負担が課題となっていました。
そこで、Amazon Bedrockを活用して複数のRAG手法を比較検証し、正答率がもっとも高かったAdvanced RAGを採用しました。
その結果、サポートエンジニアの回答作成時間を最大30%短縮しています。
この事例からは、RAGは単に導入するだけでなく、複数の検索・生成方式を実データで比較しながら構成を選ぶことの重要性がわかります。
IQVIAサービシーズ ジャパン合同会社|検索・調査時間を93%削減
IQVIAサービシーズ ジャパンでは、医薬品関連文書や規制文書、臨床試験Q&Aの確認に手作業で時間がかかり、Q&A調査だけでも月合計204時間を費やしていました。
そこで、一般公開文書と社内Q&Aを対象にRAGベースの社内チャットを構築し、少人数運用を前提としたサーバレス構成で導入しています。
公式情報では、月あたりの検索・調査時間を93%削減し、社内ユーザー321人に利用が広がったことが確認できます。
文書量が多く、正確性も求められる業務において、RAGが大きな効率化につながった事例といえるでしょう。
株式会社クリエイティブ・ウェブ|平均対応時間を約40%削減
クリエイティブ・ウェブは、コールセンター業務における効率化と、対応品質の標準化を課題としていました。
そこで、過去対応履歴を検索・インデックス化し、類似事例を提示するRAG機能付きのお問い合わせ管理システムを構築しています。
その結果、初回解決率が約30%増加し、平均対応時間を約40%削減、さらに過去事例の検索時間も5分から1分以下へ短縮しました。
RAGは単なる文書検索にとどまらず、問い合わせ品質の平準化にもつながり得ることがわかります。
RAGの活用例
RAGは「社内文書を検索して答える」仕組みなので、情報探索が多い業務と相性がよいです。
代表的な活用例を挙げると、次のようになります。
- 社内FAQの自動応答
- ヘルプデスクや問い合わせ一次対応
- 業務マニュアル・規程集の検索
- 営業資料や提案書作成時の情報参照
- 設計資料や技術文書の検索支援
- コールセンターの類似事例検索
たとえば社内FAQでは、人事制度、経費精算、総務手続きなどの問い合わせを自己解決しやすくなります。
ヘルプデスクでは、製品仕様書や障害対応手順書を参照しながら回答案を提示できるため、担当者の調査負荷を減らせる可能性があります。
また、業務文書検索では、長いPDFや複数部門の文書を横断して必要な情報を探しやすくなります。
単純な語句一致だけでは見つけにくい情報でも、検索方式によっては自然文による質問から関連箇所へたどり着きやすくなります。
一方で、判断そのものをRAGに任せる用途には慎重さが必要です。
RAGは参照情報をもとに回答できますが、最終判断が法務・安全・医療などに関わる業務では、人による確認を前提に設計することが大切です。
RAG導入時の注意点
RAGは有効な仕組みですが、導入すれば自動的に高精度になるわけではありません。
失敗を防ぐには、よくあるつまずきどころを事前に押さえておく必要があります。
- 文書の質が低いと回答品質も下がる
- 検索方式が業務に合っていないと取りこぼしやノイズが増える
- 権限制御が不十分だと情報漏えいリスクが高まる
- 運用設計が弱いと文書更新に追随できない
- 回答精度の評価方法が曖昧だと改善が進まない
もっとも基本的なのは、参照文書の品質です。
古い版の規程、重複したFAQ、誤記を含むマニュアルをそのまま検索対象にすると、検索結果や回答が不安定になる可能性があります。
そのため、RAG導入ではモデルや検索エンジンの選定だけでなく、参照データの整理や更新ルールも重要です。
セキュリティ面も重要です。
RAGでは社内文書を検索対象にするため、「検索対象として登録されていること」と「その利用者に見せてよいこと」を分けて設計する必要があります。
利用者や所属部門に応じて参照権限を制御し、閲覧権限のない機密文書が検索結果や回答に含まれないようにすることが欠かせません。
さらに、運用コストにも注意が必要です。
文書更新が多い環境では、データの再取り込みや再インデックス、必要に応じた再エンベディングなどの運用が発生し、想定より管理負荷が大きくなることがあります。
RAG導入に関するよくある質問
Q.1 RAGとは何ですか?
RAGは、生成AIが回答を作る前に、関連する文書やデータを検索して参照する仕組みです。自社のFAQ、規程、マニュアル、技術文書などを検索し、その内容を踏まえた回答を生成できるため、社内情報を活用する用途で使われています。
Q.2 RAGはなぜ注目されているのですか?
社内独自の情報や最新文書を参照しながら回答できるためです。モデルが持つ知識だけでは対応しにくい社内問い合わせや業務文書検索にも活用しやすく、ハルシネーション抑制や検索時間短縮の観点から導入が検討されています。
Q.3 RAGの検索方式には何がありますか?
代表的なのは、単語一致などをもとに探すキーワード検索、意味の近さで探すベクトル検索、その両方を組み合わせるハイブリッド検索です。どの方式が適しているかは、対象文書や実際の質問内容を使って評価することが重要です。
Q.4 RAG導入はどの業務に向いていますか?
社内FAQ、ヘルプデスク、業務マニュアル検索、設計資料検索、コールセンター支援など、情報探索や回答作成に時間がかかる業務と相性がよいです。一方で、最終判断まで完全に任せる用途では、人の確認を前提に設計したほうがよいでしょう。
Q.5 RAG導入時に注意すべきことは何ですか?
文書品質、検索方式の適合性、権限制御、セキュリティ、更新運用、評価方法の設計などです。とくに、古い文書や重複データをそのまま使うと回答品質に影響しやすく、アクセス権を考慮しないと機密情報が不適切に参照されるおそれがあります。
自社に合ったRAG導入の進め方を見極めよう
RAG導入で大切なのは、流行の技術として取り入れることではなく、どの業務の、どの情報探索を、どこまで効率化したいのかを明確にすることです。
同じRAGでも、社内FAQ向けなのか、規程検索向けなのか、問い合わせ対応支援なのかによって、求められる検索方式や運用設計は変わります。
また、導入形態や構築方法によって、対応できる範囲も異なります。
SaaS型で比較的早く始める方法もあれば、権限制御や既存システム連携を重視して個別構築する方法もあるため、自社の要件と照らして判断する必要があります。
比較するときは、対象業務、参照文書の整備状況、検索方式、権限制御、評価方法、運用体制を確認しておきたいところです。
とくにPoCでは、成功条件と評価指標を先に定めておくと、導入可否を判断しやすくなります。
まずは、自社でRAGを適用したい業務を絞り、対象文書の整理、更新頻度の確認、利用者の範囲、必要なセキュリティ要件を洗い出してみましょう。
自社だけで設計や精度評価まで進めるのが難しい場合は、PoC設計やデータ整備、権限制御、運用設計を支援できる専門家へ相談するのも有効です。
要件や費用、支援範囲を比較しながら進めることで、自社に合ったRAG導入の形を見つけやすくなるでしょう。