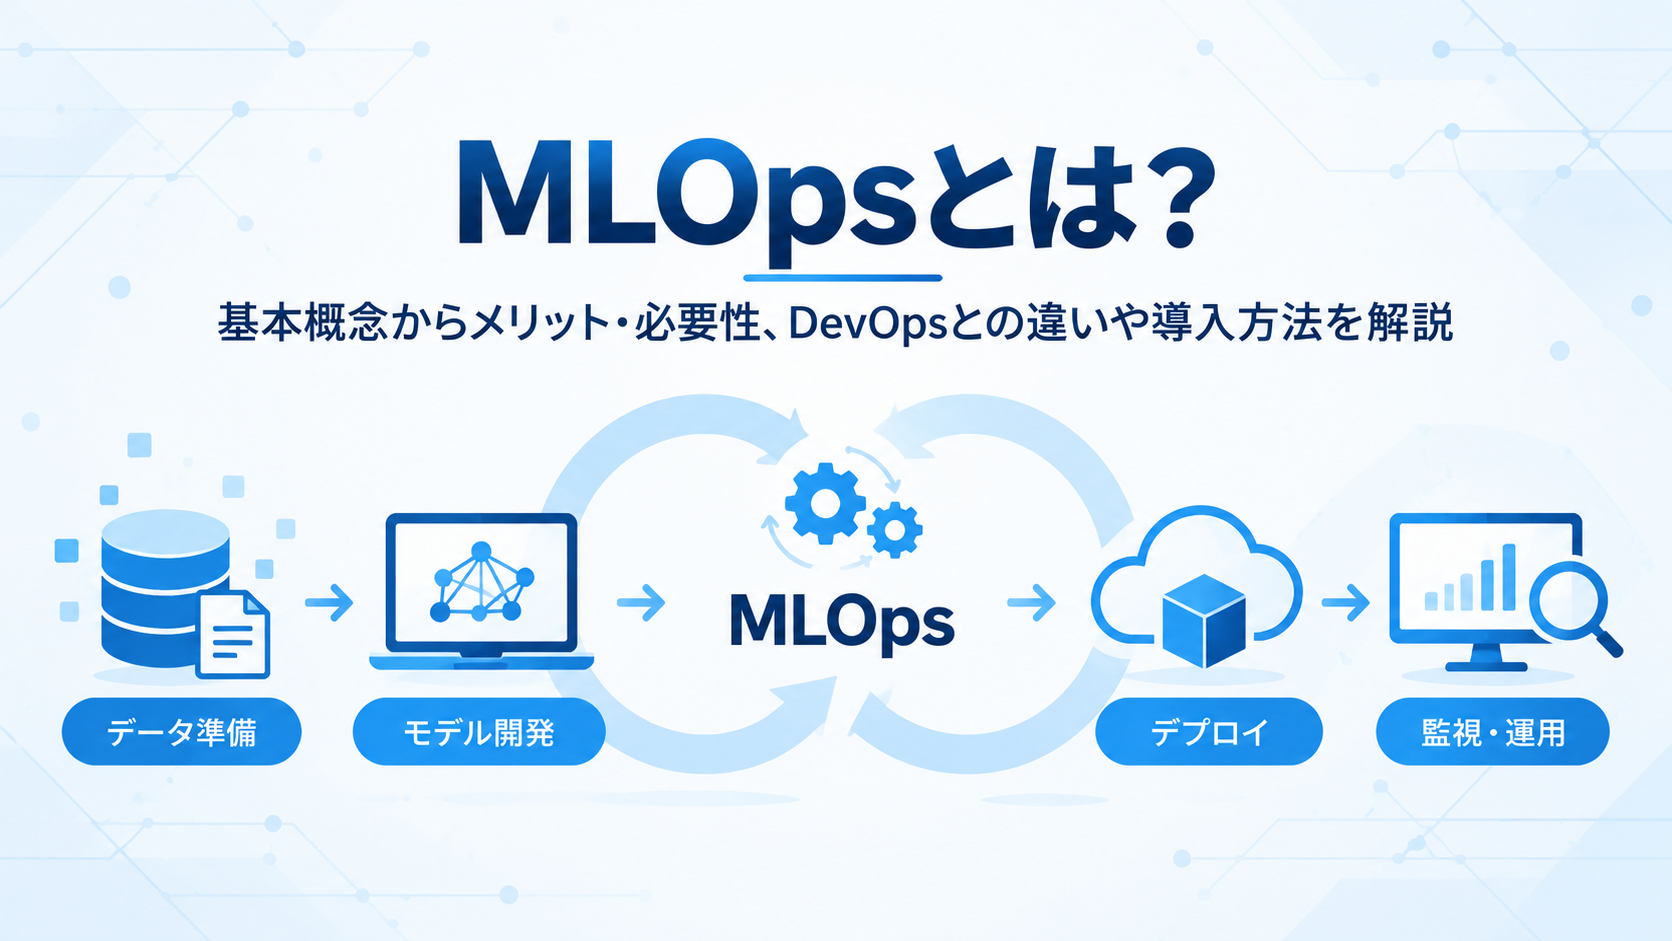
MLOpsとは?基本概念からメリット・必要性、DevOpsとの違いや導入方法を解説
機械学習モデルを業務に組み込む際、PoCでは問題なく動作していても、本番運用に移行すると新たな課題が生じることがあります。
学習時には高い精度が出ていても、運用開始後にデータの傾向が変わったり、再学習の手順が属人化したりすると、期待した成果を継続的に出しにくくなります。
そこで重要になるのがMLOpsです。
「MLOpsとは何か」「DevOpsとどう違うのか」「なぜ必要なのか」といった疑問を持つ方も多いでしょう。
この記事では、MLOpsの基本概念から必要性、DevOpsとの違い、主なメリット、構成要素、導入ステップ、成熟度モデルまでを順番に整理します。
PoCで終わらせず、機械学習を本番運用につなげるために何を押さえるべきかを、実務目線でわかりやすく見ていきましょう。
MLOpsとは何か
MLOpsとは、機械学習モデルの開発からデプロイ、監視、再学習、改善までを継続的に回すための考え方や運用の仕組みを指します。
名称はMachine LearningとOperationsを組み合わせたもので、単にモデルを作るだけでなく、作ったモデルを安定して使い続けるための管理と自動化が中心テーマです。
従来の機械学習プロジェクトでは、データ分析担当者がノートブック上でモデルを作り、検証結果をもとに個別に本番化する流れがよく見られました。
ただし、このやり方では、誰がどのデータで学習したのか、どのパラメータを使ったのか、いつ再学習すべきかが不明確になりやすく、運用が続くほど管理負荷が高まります。
MLOpsは、こうした課題に対して、データ・コード・モデル・実験結果・本番環境を一連の流れとして管理し、再現性と継続性を高めるための枠組みだと考えると理解しやすいでしょう。
なお、MLOpsは単一のツール名ではありません。
運用ルール、役割分担、自動化パイプライン、監視基盤、モデル管理などを含む広い概念であり、AI開発全体の流れの中で見ると、AI開発の流れのうち本番運用と継続改善を強化する考え方にあたります。
なぜMLOpsが必要なのか
MLOpsが必要とされる最大の理由は、機械学習モデルは作って終わりではなく、運用開始後に価値を出し続けるための仕組みが欠かせないからです。
PoC段階ではうまく見えても、本番運用ではデータの変化、推論負荷、障害対応、モデル劣化など、開発時とは別の課題が次々に出てきます。
とくに、次のような問題が起きやすくなります。
- PoCは成功したが本番環境への移行手順が整っていない
- 学習時と本番時でデータの品質や分布が変わる
- 精度低下に気づく監視体制がない
- 再学習や再デプロイが手作業で属人化する
- モデルや特徴量のバージョンが追えず再現性が失われる
こうした状態では、モデルそのものの性能よりも、運用の不安定さがボトルネックになります。
その結果、現場から「使い続けにくい」「更新が怖い」「精度が落ちても原因が分からない」といった不満が出やすくなります。
MLOpsは、この運用上の分断を埋めるための取り組みです。
データ更新、学習、評価、承認、デプロイ、監視、再学習の流れを整理することで、PoC止まりを防ぎやすくなります。
たとえば、需要予測モデルなら季節変動や販促の影響で入力データの傾向が変わることがありますし、不正検知モデルなら新しい不正パターンの出現で精度が落ちることもあります。画像検査でも、撮影環境や機器の変更で推論結果がぶれやすくなります。
このように、機械学習は本番運用に入ってから変化へ対応する設計が欠かせないため、MLOpsの必要性が高まります。
PoCから先に進まない背景を詳しく整理したい場合は、AI PoCの進め方もあわせて確認すると、MLOpsが求められる理由をよりつかみやすくなります。
また、MLOpsが未整備のままAI導入を進めると、運用定着の失敗につながることもあります。
本番移行後のつまずき方には共通点も多いため、AI導入の失敗で起こりやすいパターンも把握しておきたいところです。
MLOpsとDevOpsの違い
MLOpsとDevOpsは近い考え方ですが、対象とする成果物や管理対象に違いがあります。
DevOpsは、主にアプリケーションコードを継続的に開発・テスト・リリース・運用するための考え方です。
一方でMLOpsは、アプリケーションコードだけでなく、学習データ、特徴量、モデル、評価指標、再学習の仕組みまで含めて管理します。
つまり、MLOpsはDevOpsの延長線上にありつつ、機械学習特有の不確実性に対応するための要素が追加されたものです。
| 観点 | DevOps | MLOps |
|---|---|---|
| 主な対象 | アプリケーションコード | コード、データ、モデル、学習結果 |
| 品質確認 | テスト結果、動作確認 | 精度、再現率、ドリフト、推論品質 |
| 変更要因 | 仕様変更やバグ修正 | 仕様変更に加え、データ変化やモデル劣化 |
| 運用時の重要管理 | デプロイ、障害監視、可用性 | デプロイ、障害監視、可用性、再学習、モデル監視 |
| 再現性の対象 | コードと環境 | コード、環境、データ、特徴量、学習条件 |
DevOpsでは、同じコードを同じ環境にデプロイすれば同じ動作が期待しやすい一方で、MLOpsでは同じコードでも学習データが変われば結果が変わることがあります。
そのため、MLOpsではデータとモデルのバージョン管理がDevOps以上に重要になります。
また、MLOpsでは本番精度の監視や再学習の判断も必要です。
単にシステムが動いているだけでは不十分で、モデルが期待通りの予測を続けているかまで見なければなりません。
MLOpsの主なメリット
MLOpsを整備すると、機械学習プロジェクトを単発の実験で終わらせず、継続的な業務価値につなげやすくなります。
とくに大きいメリットは、運用の安定化と再現性の向上です。
モデルの学習条件やデータの履歴を追えるようにしておけば、問題発生時の原因分析がしやすくなりますし、改善版モデルへの切り替えも計画的に進められます。
また、再学習やデプロイの流れを標準化・自動化することで、担当者個人の経験に依存しにくくなるのも利点です。
担当者が変わっても同じ手順で運用しやすく、引き継ぎコストの抑制にもつながるでしょう。
主なメリットを整理すると、次の通りです。
- 本番運用を前提とした安定したリリース体制を作りやすい
- データやモデルの変更履歴を追いやすく、再現性が高まる
- 監視によって精度低下や異常を早期に把握しやすい
- 再学習や再デプロイの工数を減らし、運用効率を上げやすい
- 属人化を防ぎ、チームで継続改善しやすくなる
さらに、要件や運用ルールを初期段階で整理しやすくなる点も見逃せません。
機械学習の本番運用では、監視指標や再学習条件、承認フローなどを曖昧にしたまま進めると後で手戻りが増えます。
そのため、導入前にはAI開発の要件定義の観点もあわせて整理しておくと、MLOps設計の精度が上がります。
MLOpsを構成する要素
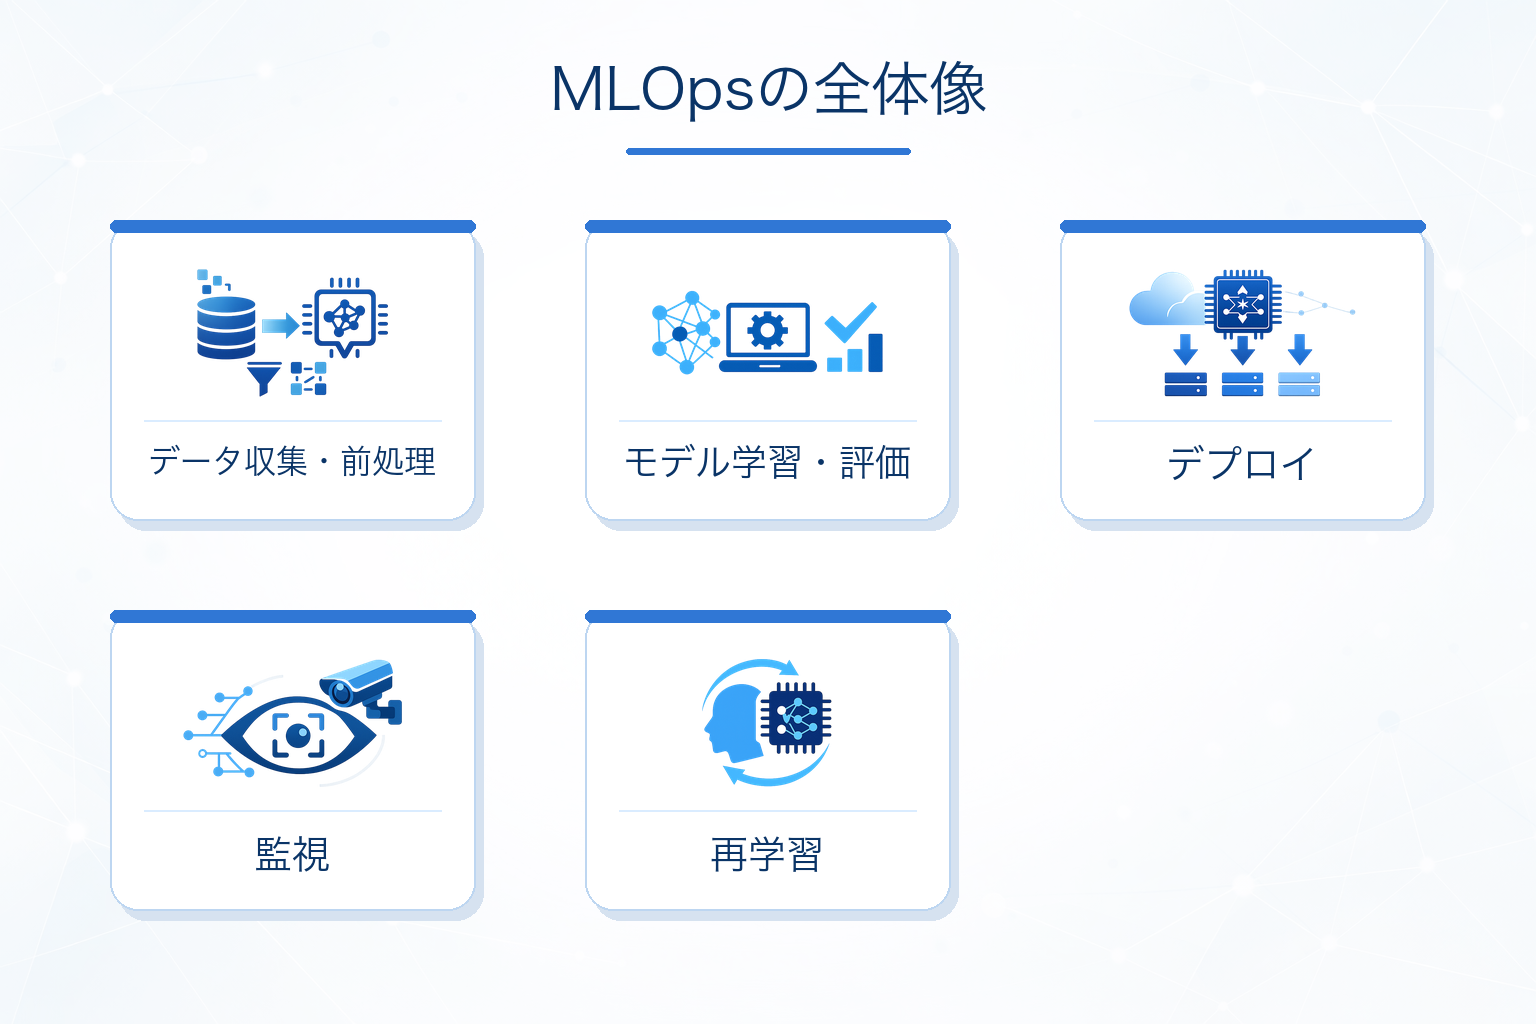
MLOpsは単一機能ではなく、複数の管理要素が組み合わさって成り立ちます。
全体像を把握するには、データ、モデル、運用、自動化の4つを軸に見るとわかりやすくなります。
データ管理
機械学習では、モデルより前にデータの管理が重要です。
どのデータを使ったか、欠損や重複をどう処理したか、学習用と推論用で整形手順が一致しているかを管理しないと、本番で想定外のズレが起きやすくなります。
データソースが複数ある場合は、更新タイミングや品質ルールも含めて整理する必要があります。
たとえば、受発注データを基幹システムから取得し、顧客属性をCRMから補完している場合、どちらかの更新遅延や欠損が推論結果に影響することがあります。
モデル管理
モデル管理では、学習済みモデルのバージョン、評価結果、学習条件、承認状況などを記録します。
どのモデルを本番に出したのか、前のモデルに戻せるのかが明確でないと、障害時や精度低下時の対応が遅れます。
モデルレジストリのような仕組みを使って、学習済みモデルを体系的に保管する考え方がよく用いられます。
CI/CD/CT
MLOpsでは、コードの継続的インテグレーションと継続的デリバリーに加え、継続的トレーニングも重要です。
CIはコード変更の検証、CDは安全なデプロイ、CTはデータ更新などをきっかけにモデル学習や再評価を継続的に回す仕組みを指します。
この3つが整うと、モデル改善を本番運用につなげやすくなります。
監視
本番運用では、サーバーの稼働監視だけでなく、モデルの振る舞いも見なければなりません。
MLOpsの監視対象には、推論遅延、エラー率、入力データの変化、予測分布の偏り、精度指標の悪化などがあります。
システムが動いていても、モデルの判断品質が落ちていれば業務価値は維持できません。
たとえば、レコメンドモデルならクリック率や購買率の変化、需要予測なら予測誤差の増加、問い合わせ分類なら誤分類の増加など、業務に近い指標まで見る設計が重要です。
再学習と改善サイクル
MLOpsでは、監視して終わりではなく、必要に応じて再学習し、改善版を安全に反映する流れまで設計します。
再学習の頻度は固定とは限らず、定期実行、ドリフト検知時、業務イベント発生時など、ユースケースに応じて決めるのが一般的です。
この改善サイクルが回り始めると、機械学習運用が単発施策から継続運用へ変わっていきます。
MLOpsの導入ステップ
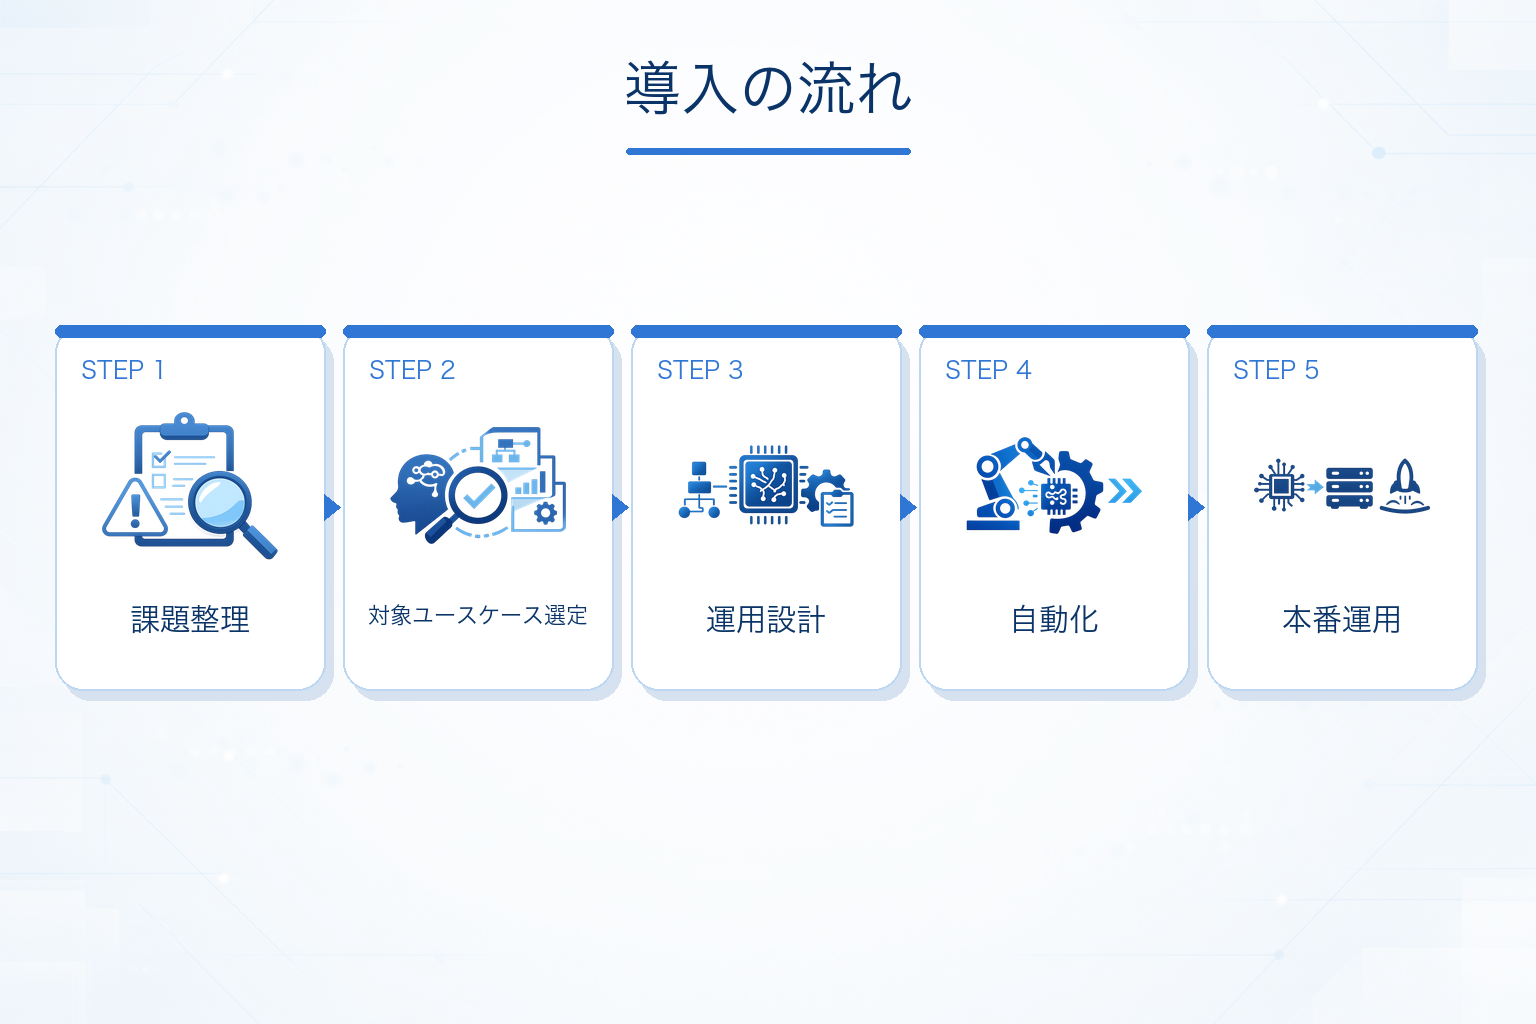
MLOpsは最初から完璧な基盤を作ろうとすると負荷が大きくなります。
そのため、まずは対象ユースケースを絞り、運用上のボトルネックを解消するところから始めるのが現実的です。
一般的には、次のような流れで導入を進めます。
1. 課題と導入目的を整理する
最初に、何を改善したいのかを明確にします。再学習の手間を減らしたいのか、精度低下を早く検知したいのか、本番リリースの属人化を解消したいのかで、必要な設計は変わります。
2. 対象ユースケースを選定する
いきなり全社横断で整備するより、需要予測、異常検知、問い合わせ分類など、効果と課題が見えやすい対象から始める方が進めやすくなります。
3. データとモデルの管理方法を決める
データの保存場所、前処理手順、特徴量の扱い、モデルの版管理、評価結果の保存先などを決めます。ここが曖昧だと、後から再現性を確保しにくくなります。
4. 学習・評価・デプロイの運用フローを設計する
誰が学習を実行し、どの評価を通過したら本番反映するのか、承認者は誰か、切り戻しはどう行うかまで整理します。
5. 監視指標と再学習条件を定義する
何をもって異常や性能低下とみなすかを決めます。予測誤差、入力分布の変化、推論失敗率、業務KPIの悪化など、ユースケースに合った指標設計が必要です。
6. 自動化できる工程から順次実装する
初期段階では、実験管理やモデル登録、テスト、デプロイの一部自動化から始める進め方が現実的です。すべてを一度に自動化しなくても問題ありません。
7. 本番運用しながら改善サイクルを回す
運用開始後は、監視結果や障害対応の記録をもとに、ルールやパイプラインを見直します。MLOpsは導入して終わりではなく、運用しながら育てる前提で考えることが大切です。
最初の段階で大切なのは、単に「MLOpsツールを入れる」ことを目的にしないことです。
まず整理すべきなのは、何を安定運用したいのか、どの工程に手間やリスクが集中しているのかという業務課題です。
たとえば、再学習に毎回人手がかかっているのか、精度低下を検知できていないのか、リリース手順が属人化しているのかで、優先すべき整備内容は変わります。
次に重要なのが、監視と再学習のルールを先に定義することです。
本番導入後に「何をもって精度低下と判断するのか」「どの条件でモデルを更新するのか」が曖昧だと、MLOps基盤があっても運用は安定しません。
また、初期段階から全工程を自動化する必要はありません。
まずは再現性の確保と監視の標準化を優先し、その後に自動化範囲を広げる進め方が失敗しにくいでしょう。
MLOpsの成熟度モデル
MLOpsは、一度に完成形へ到達するものではありません。
MLOpsの成熟度は、手動運用中心の状態から、管理や自動化の範囲を段階的に広げていく形で整理できます。
その進み具合を把握するための一つの考え方が成熟度モデルです。
| 成熟度 | 状態 | 主な特徴 |
|---|---|---|
| レベル0 | 手動運用中心 | 分析担当者ごとの個別対応が多く、再現性や標準化が弱い |
| レベル1 | 一部自動化 | 学習やデプロイの一部が整備され、モデル管理や実験管理が始まる |
| レベル2 | 継続運用 | 監視、再学習、デプロイがつながり、改善サイクルを回しやすい |
| レベル3以降 | 高度な最適化 | 複数モデルや複数部門へ展開し、標準化やガバナンスも強化される |
自社がどの段階にいるかを見極めるときは、ツールの有無だけで判断しないことが大切です。
重要なのは、モデルの状態を継続的に把握できるか、再学習や切り戻しを現実的に実行できるか、担当者が変わっても運用が止まらないかという点です。
たとえば、クラウド基盤を導入していても、学習条件の記録が残らず、監視も手作業であれば成熟度はまだ高いとはいえません。
反対に、ツール構成がシンプルでも、モデル管理、監視、再学習判断が標準化されていれば、実務上の成熟度は十分高いケースもあります。
MLOps導入で失敗しないためのポイント
MLOps導入で失敗しやすいのは、技術選定だけに意識が向き、運用設計や体制整備が後回しになる場合です。
本番運用に必要なのは、ツール導入そのものより、継続改善を回せる仕組みづくりだと考えた方がよいでしょう。
導入前にとくに確認したいのは、次の点です。
- 何の課題を解決するためにMLOpsを導入するのか明確か
- データ管理、モデル管理、監視の責任者が決まっているか
- 精度低下や異常をどう検知するか定義されているか
- 再学習の条件、承認フロー、切り戻し手順が決まっているか
- PoCと本番運用で必要な要件の違いを整理できているか
- 内製と外部支援の役割分担が現実的か
たとえば、データ基盤は情報システム部門、モデル改善はデータサイエンス部門、業務KPIの判断は事業部門が担う形もあります。どこで責任が切り替わるのかを曖昧にしないことが、運用定着では重要です。
なお、自社だけで設計と運用を回すのが難しい場合は、機械学習開発会社やAI導入支援の専門家に相談する選択肢もあります。
その際は、単にモデル開発実績を見るだけでなく、運用設計、監視、再学習、引き継ぎまで支援範囲に含まれるかを確認しておくと、MLOpsの定着につながりやすくなります。
MLOpsに関するよくある質問
Q.1 MLOpsとは何ですか?
MLOpsとは、機械学習モデルの開発、デプロイ、監視、再学習、改善を継続的に行うための仕組みや運用の考え方です。モデルを作ること自体ではなく、本番環境で安定して使い続けるための管理と自動化に重点があります。
Q.2 MLOpsとDevOpsの違いは何ですか?
DevOpsは主にアプリケーションコードの継続的開発と運用を対象にしますが、MLOpsはコードに加えてデータ、特徴量、学習済みモデル、評価結果まで管理対象に含みます。とくに、データ変化による精度劣化や再学習の必要性に対応する点がMLOpsの特徴です。
Q.3 なぜMLOpsが重要なのですか?
PoC段階では性能が出ていても、本番運用ではデータの変化や運用負荷によって成果が維持できないことがあるためです。MLOpsを整備すると、監視、再学習、バージョン管理、切り戻しなどの仕組みを作りやすくなり、機械学習を継続的な業務価値につなげやすくなります。
Q.4 MLOpsの導入は難しいですか?
最初から大規模な基盤を整えようとすると難しく感じやすいですが、対象ユースケースを絞って段階的に始めれば導入しやすくなります。まずはデータ管理、モデル管理、監視指標の定義など、再現性と運用の見える化から着手するのが現実的です。
Q.5 MLOpsは何から始めるべきですか?
最初に整理したいのは、MLOpsで解決したい運用課題です。たとえば、再学習が手作業なのか、精度低下を検知できないのか、本番デプロイが属人化しているのかで優先順位は変わります。そのうえで、対象モデルを絞り、データ管理、モデル管理、監視、再学習条件を順番に整えていくと進めやすいでしょう。
PoCで終わらせずMLOpsを本番運用につなげよう
MLOpsで重要なのは、モデル開発の成功だけでなく、運用開始後も品質を保ち、改善を継続できる状態を作ることです。
検討時には、目的の明確化、監視指標の設計、再学習ルール、責任分界を優先して整理しましょう。
まずは対象ユースケースを絞り、データ管理やモデル管理の現状を確認したうえで、必要な自動化範囲を段階的に決めていく進め方が現実的です。
自社だけで難しければ、機械学習や運用設計に詳しい専門家へ相談し、PoCから本番運用までの道筋を明確にするのも有効でしょう。
エラビサキでは、AI開発会社や機械学習関連パートナーの対応領域・提供形態・実績などを整理し、自社の条件から発注先候補を比較できるデータベースを構築していきます。